
2026 年,AI 行业完成从大模型调用到自主智能体工程化的转型。企业知识库落地进入从 Demo 验证走向生产规模化阶段,向量检索、知识图谱 RAG、长上下文 RAG、Agentic RAG 四类架构成为市场主流选型。依据 2026 ERAA 企业 RAG 基准测试数据,纯向量 RAG 在单跳问答场景召回准确率可达 94%,但多跳复杂推理场景准确率仅 61%;知识图谱 RAG 将跨实体关联问题的事实准确率提升 80%;长上下文 RAG 适合完整文档精读,但算力成本显著上升;Agentic RAG 具备自主任务拆解、迭代检索与结果自校验能力,适合复杂业务调研,同时带来架构复杂度与 token 开销。
市场对人才的要求随之改变,仅掌握提示词工程已经无法满足岗位需求,企业更看重开发者能够独立完成开源模型本地部署、微调、工具编排、多智能体协作、RAG 系统搭建,并且能够提供可验证的项目成果。但学习者普遍面临资源碎片化问题:网上教程版本老旧、项目仅为演示 Demo,缺少可复现代码,作品集真假难以核验。本文对 2026 最新开源大模型、AI 智能体学习资源做系统性梳理,划分课程、社区、竞赛、作品集四大板块,构建完整学习路径。
一、体系化课程资源:分层学习,从理论到 Agent 工程实战
2026 年的优质课程已经告别单纯讲解 Transformer 理论,形成 “基础理论→模型部署微调→RAG 系统→AI 智能体编排” 的递进式学习链路,分为免费开源课程与商业实战训练营两类。
入门理论层,适合零基础学习者。Hugging Face 2026 更新全套学习体系,新增独立 Agents Course,覆盖 smolagents、LangGraph、LlamaIndex 三大主流智能体框架,完整讲解工具调用、状态管理、多轮任务编排。Karpathy 的《Neural Networks: Zero to Hero》依旧是底层理论首选,从 Python 从零搭建神经网络,理解 LLM 底层原理。国内 Datawhale 推出 Hello-Agents 开源教程,面向中文开发者,讲解通用智能体架构,配套完整代码仓库与阶段性作业,降低中文用户上手门槛。
工程实战层,面向有 Python 基础,目标落地企业级项目的学习者。魔搭 ModelScope 研习社配套 MinerU 实战训练营,免费提供算力资源,课程覆盖文档解析、模型微调、Agent 技能开发,课程作业可直接开源提交,产出项目可纳入作品集。斯坦福 CS324 大模型课程更新 2026 春季版本,新增 Agentic RAG、智能体评测、可观测性模块,聚焦大模型生产环境落地,配套论文阅读与编程作业。商业课程大多聚焦 MCP 协议、多智能体团队协作,以项目制教学为主,适合希望快速积累端到端项目经验的开发者。
课程选择避坑要点:优先选择带有可执行代码仓库、评测数据集的课程,拒绝只讲概念、没有代码实操的短视频碎片化教程。2026 行业调研显示,仅完成纯理论课程的学习者,项目落地成功率不足 18%;配套实战作业、开源提交的课程,学习者独立搭建智能体系统的成功率提升至 62%。
 545b9a3270e94bb06ccd7ce37922b29.webp
二、开发者社区:获取源码、答疑、共建开源项目
社区是开源大模型与智能体方向不可或缺的学习阵地,不仅可以获取最新源码,还能参与项目共建、接收同行代码评审,这也是作品集重要加分项。
国际社区方面,Hugging Face Hub 是核心阵地,2026 年新增大量 Agent 相关模型、评估数据集、Demo 空间,开发者可以直接在 Space 在线部署项目,一键公开演示。GitHub 的 Agent-Learning-Hub、500-AI-Agents-Projects 仓库,汇总数百个智能体实战案例,覆盖 CrewAI、AutoGen、LangGraph 多套框架,适合参考项目架构。Discord 社区聚集大量 Agent 开发者,讨论 MCP 协议、智能体记忆、执行追踪等前沿工程问题。
国内核心社区,魔搭 ModelScope 提供免费 GPU 算力,支持模型微调、Agent 项目在线运行,魔搭共建者计划鼓励开发者提交项目、模型、数据集;Datawhale 长期组织开源共读、组队实战营,适合组队完成项目;智源社区聚焦国产开源大模型,定期发布 Qwen、Muse-Glimmer 等模型技术文档与工程案例。
社区学习的正确方式,不是单纯浏览帖子,而是深度参与:提交 Issue 修复 bug、完善文档、贡献轻量功能,这些开源贡献记录,是简历中可信度极高的证明,远优于单纯自建 Demo。
三、行业竞赛:以赛促练,产出标准化可验证项目
2026 开源大模型与 AI 智能体相关竞赛数量持续增长,竞赛提供标准化评测数据集、算力资源、明确评估指标,解决个人项目缺少客观打分的痛点,竞赛成果是可验证作品集的优质素材。
国内主流竞赛:魔搭 AI+∞开发者创作大赛、MinerU 数据智能与前沿语料挑战赛,赛道包含文档智能、RAG 知识库、AI 智能体开发,提供免费算力,提交成果自动评测,获奖作品会在社区公开展示。这类竞赛偏向应用落地,适合学生与初级 AI 工程师。
国际赛道:Kaggle 大模型赛道、Hugging Face Open LLM Leaderboard 相关挑战赛,聚焦模型微调、智能体任务规划、多跳推理评测,任务难度更高,适合进阶开发者。
竞赛选题建议,优先选择 RAG 知识库、多智能体调研系统、代码智能体这类业务场景赛道,避开纯生成类文本创作赛道。纯文本生成项目很难验证能力;而 RAG、Agent 赛道拥有固定测试集,召回率、幻觉率、任务完成率等指标可以量化,能够作为作品集的核心证据。同时注意,竞赛不要盲目追求复杂多智能体架构,2026 大量参赛项目因为架构过度复杂,稳定性不足,最终评测分数反而低于轻量化 Agentic RAG 方案。
四、可验证作品集:2026AI 求职的核心凭证,构建标准与项目方向
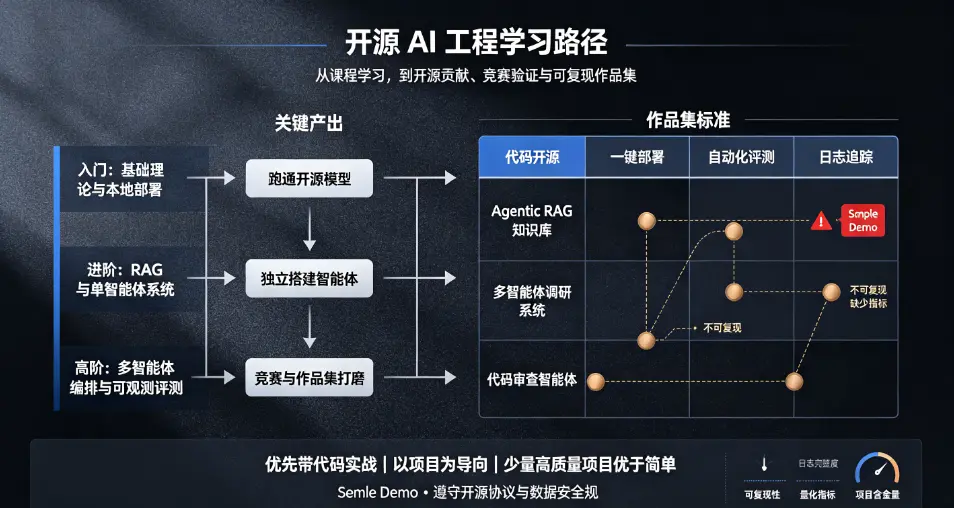
传统作品集只展示网页 Demo,在 2026 年已经失去说服力,AI 可以快速生成简单网页应用。行业催生可验证作品集(AIfolio),核心要求:项目代码开源、可一键部署、自带自动化评测脚本、完整日志追踪、量化指标,任何人都可以复现结果,验证项目性能。
可验证作品集的硬性标准:第一,代码托管于 GitHub,清晰 README,包含环境部署脚本,无需复杂配置即可一键启动;第二,配套独立评测集,记录幻觉率、召回率、任务完成率等量化指标,对应前文提到的 ERAA RAG 评测体系;第三,增加可观测追踪日志,记录 Agent 思考路径、工具调用过程,证明不是简单提示词包装;第四,提供在线演示入口,附带测试案例与失败案例复盘。
推荐 3 类高含金量作品集项目。第一,企业级 Agentic RAG 知识库,区分向量检索、图谱检索路由,内置权限检索、引用溯源,测试多跳问答,记录召回准确率;第二,多智能体调研系统,使用 LangGraph/CrewAI 搭建,拆解调研任务、调用搜索工具、交叉校验信息,输出带引用的调研报告;第三,代码审查智能体,对接代码仓库,自动完成代码漏洞检测、注释生成,集成 CI/CD 工作流。
作品集避坑:不要堆砌大量简单聊天机器人项目。面试官重点考察开发者处理幻觉、任务失败、上下文溢出等工程问题的能力,少量高质量、可复现项目,远优于十几个简单 Demo。2026 招聘数据显示,拥有可验证 Agent 项目的候选人,简历通过率提升约 76%。
五、学习路径规划与资源导航使用策略
完整学习路线可以分为三个阶段。入门阶段,学习 Transformer 基础、Python、提示词工程,完成基础课程,在社区跑通开源模型本地部署;进阶阶段,学习向量数据库、RAG、工具调用,独立搭建单智能体系统,参与社区开源贡献;高阶阶段,学习多智能体编排、Agent 评测、可观测体系,参加 AI 竞赛,打磨可验证作品集。
资源导航使用原则:导航仅作为线索,不要一次性收藏大量资源却不落地。优先选定一条技术主线,以项目为导向学习,边学习边迭代作品集。同时,学习过程中需要持续关注开源生态迭代,MCP 协议、Agent 运行时、评估工具在 2026 年更新速度极快,陈旧教程容易误导开发思路。
六、总结
2026 年开源大模型与 AI 智能体学习,已经从 “看教程、玩 Demo” 转向工程实践与成果验证。课程提供理论与代码基础,社区提供交流与开源贡献渠道,竞赛提供标准化评测环境,而可验证作品集是所有学习成果的最终载体。
企业在评估 AI 人才时,不再只看证书与学习笔记,更看重开发者能不能构建稳定、可验证的智能体系统,掌握 RAG、多智能体编排、幻觉抑制、可观测性等工程能力。在学习选型时,优先选择带代码、可复现的实战资源,聚焦真实业务场景,打造量化可核验的作品集,避免陷入碎片化学习与无效 Demo 的误区。同时开发者需要遵守开源协议、数据安全法规,在合法合规范围内开展模型部署与项目开发。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。
评论列表