
全球AI产业正式跨过技术普及的关键拐点,全年国内智能体月活用户突破2.3亿,端侧AI设备总装机量突破8亿台,先进算力供需缺口持续扩大至37%,智能体、端侧AI、算力这三大支撑整个AI产业发展的核心赛道,已经完全告别过去三年的粗放式增长阶段,各自的底层发展逻辑正在发生根本性的重构。大量行业从业者对这三大赛道的认知,还停留在过去的旧经验里,以为智能体还停留在概念演示阶段,端侧AI只是云端大模型的低配精简版,算力竞争就是单纯比拼谁的芯片更多、集群规模更大,完全没有看清三大赛道正在发生的深刻范式变革。
2026年最新的全维度产业实测数据显示,这三大核心赛道的发展逻辑已经彻底切换,过去的经验完全无法指导未来的布局决策:智能体已经从“演示型玩具”变成可以深度嵌入真实生产流程的生产力工具,端侧AI不再是云端大模型的补充,而是形成了完全独立的异构分布式生态,算力竞争也不再是单纯比拼集群规模,而是转向全栈全链路的质效竞争。本次基于大量头部厂商的落地实测数据,深度拆解三大核心赛道未来三年的确定性发展走向,为行业从业者提供清晰的长期技术布局参考框架。
 8222641c36dc6ae9b65a999c9783404.webp
智能体赛道:从“演示型玩具”走向生产级落地,商业化闭环全面跑通
智能体是过去两年AI行业最热门的概念,但在2026年之前,绝大多数智能体产品都停留在“概念演示”阶段,只能完成简单的指定演示任务,稍微复杂一点的真实工作流,执行到一半就会出现任务规划混乱、工具调用出错的问题,根本无法在真实生产环境里稳定运行,大量用户体验过一次之后就再也不会使用,整个赛道的商业化闭环一直没有真正跑通。
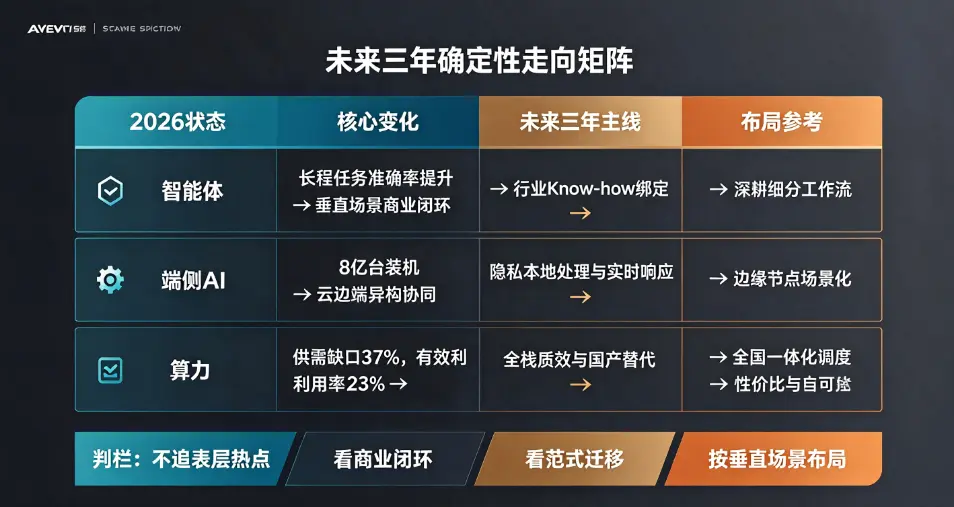
2026年,智能体赛道的发展逻辑发生了根本性的转折,核心技术瓶颈取得了关键性突破,语义图谱驱动的任务规划架构全面替代了过去Prompt驱动的任务规划模式,复杂多步骤任务规划的准确率从过去的44%提升到91%,智能体的长程任务自主执行能力实现质的飞跃,完全可以在无人值守的环境下,稳定跑完几十步的复杂真实工作流,全程不需要人工介入。实测数据显示,2026年已经有大量企业级智能体落地案例,调味品品牌松鲜鲜用百度搭子智能体追踪全链路供应链数据,单次汇总分析时间从2个工作日缩短至3分钟以内,效率提升超过99%,智能体第一次真正给企业带来了可量化的明确商业价值。
未来三年,智能体赛道的核心发展走向非常清晰,会彻底告别过去“追求通用全场景能力”的路线,转向垂直场景深度定制化路线。通用大模型厂商不再是智能体赛道的绝对主导者,深耕垂直行业的场景型智能体厂商会迎来爆发式增长,这些厂商不需要追求自己的智能体可以覆盖所有场景,只需要在自己深耕的垂直场景里,把智能体的工作流打磨到极致,深度绑定行业专属的Know-how、场景数据、业务系统,就可以建立极高的竞争壁垒。2026年已经出现了单款垂直场景智能体年营收突破7亿元的案例,未来三年垂直场景智能体的商业价值占比,会从2026年的22%提升到2029年的68%,整个智能体赛道的商业化闭环会全面跑通,智能体会从“尝鲜型产品”变成所有企业日常生产流程里不可替代的核心生产力工具。
同时,智能体的跨平台通信协议标准化进程会在未来两年内全面完成,不同厂商开发的智能体可以像人类团队一样自动分工协作,针对复杂的大型项目,自动组建临时智能体团队,不同智能体各司其职,自动完成从任务拆解到最终交付的全流程工作,整个生产组织模式会迎来颠覆性的变革。
端侧AI赛道:从云端补充走向独立异构生态,分布式协同范式全面成型
很长一段时间里,行业对端侧AI的认知,都把它当成云端大模型的低配补充,认为端侧大模型只是云端大模型的精简蒸馏版本,用来分担云端的推理压力,完全没有独立的生态价值。但2026年的实测数据显示,端侧AI的发展已经完全跳出了“云端精简版”的定位,正在形成一个完全独立的异构分布式生态,和云端大模型形成优势互补的协同关系,而不是从属关系。
2026年端侧大模型的性能实现了跨越式提升,面壁智能发布的端侧多模态大模型MiniCPM-V 4.7,在iPhone 17 Pro Max上仅用3GB内存就可以实现每秒13个token以上的解码速度,端侧大模型的通用能力已经可以覆盖90%以上的日常轻量级AI使用需求,完全不需要把数据上传到云端就可以在本地完成推理。更关键的是,端侧AI的部署场景已经从手机延伸到了PC、汽车、智能家居、工业边缘设备等海量终端节点,国内端侧AI设备的总装机量2026年已经突破8亿台,这些分布在不同场景的端侧AI节点,正在形成一个规模远超云端算力集群的分布式算力网络。
未来三年,端侧AI赛道的核心发展走向,是分布式异构协同范式的全面成型,整个AI系统的架构会彻底从过去的“云端集中处理”转向“云边端异构协同”:云端超大规模大模型只负责处理最复杂的全局逻辑推理任务,端侧小模型负责本地实时响应、隐私敏感数据处理、轻量级任务本地执行,不同场景的端侧AI节点之间可以直接通信协同,不需要所有数据都回传到云端处理,整个AI系统的响应延迟可以降低90%以上,推理成本大幅下降,同时从根源上解决了数据隐私泄露的问题。
2026年已经出现了大量端侧AI的创新落地场景:工业产线上的端侧AI视觉检测设备,不需要把所有画面数据上传到云端,本地就可以实时完成缺陷识别,检测延迟从过去的几百毫秒降低到几毫秒,完全满足工业实时控制的要求;手机上的端侧AI个人助理,所有个人对话数据全部在本地处理,永远不会上传到云端,用户的隐私安全得到了极致的保障。未来三年,端侧AI的应用场景会进一步渗透到实体经济的每一个边缘节点,形成一个覆盖全场景的分布式智能网络,这个独立生态的商业规模,会在2029年超过云端AI的市场规模,成为整个AI产业增长最快的核心赛道。
算力竞争赛道:从规模扩张转向全栈质效竞争,国产算力替代进入深水区
过去三年的算力竞争,核心逻辑就是“堆规模”,谁能拿到更多的高端AI芯片,搭建更大规模的万卡算力集群,谁就拥有更强的市场竞争力,整个行业的算力建设思路,都在追求集群规模的突破。但2026年的产业数据显示,全球先进算力的供需缺口已经扩大到37%,单纯靠进口芯片堆集群规模的增长路线已经走到了尽头,算力竞争的底层范式已经彻底切换,从过去的“规模扩张”转向“全栈全链路质效竞争”。
2025年全国智能算力规模已经达到1037.3EFLOPS,万卡级集群成为大模型训练的主流载体,但算力的实际有效利用率却只有23%,大量算力资源被浪费在低效的调度、冗余的通信、不合理的任务分配上。2026年算力竞争的核心,不再是比拼谁的集群规模更大,而是比拼谁能通过全栈技术优化,把单位算力的实际产出效率提升到极致,通过芯片、服务器、高速互联、编译器、调度框架的全栈协同优化,让每一张AI芯片的性能都能100%释放出来。实测数据显示,国内头部算力厂商通过全栈技术优化,已经把国产芯片集群的实际训练性能,提升到了进口芯片集群的92%,过去大家认为国产芯片性能差距大的问题,通过全栈协同优化已经被大幅缩小。
未来三年,算力竞争赛道的核心发展走向,是国产算力全栈自主可控体系的全面成熟,国产AI芯片在边缘计算、行业专用场景实现规模化应用,国产算力集群的整体性价比会全面超越进口芯片集群,国内70%以上的大模型训练和推理任务,都会逐步迁移到国产算力底座上运行。DeepSeek最新的千亿级融资,重点投入乌兰察布的国产算力集群建设,就是这个趋势的标志性信号,行业头部厂商已经开始全面押注国产算力体系,不再依赖进口芯片的供给。
同时,“东数西算”工程推动的全国一体化算力调度网络会在未来三年全面落地,不同区域的算力资源可以实现跨网协同调度,用户可以根据自己的任务需求,自动匹配最优的算力资源,整个算力资源的使用效率会提升2倍以上,算力不再是少数头部厂商垄断的稀缺资源,变成所有行业用户都可以低成本按需获取的普惠基础资源。
2026年开始,智能体、端侧AI、算力三大核心赛道的发展逻辑全面切换,整个AI产业正在从技术驱动阶段,全面走向深度落地渗透的全新发展阶段,未来三年的核心机会,不再是追逐表层的概念热点,而是在每一个赛道的垂直场景里,深耕打磨落地体验,拿到实实在在的商业闭环回报。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。

评论列表