
2026年全球AI Agent产业已经从“概念演示”阶段全面进入“生产落地”阶段,国内商用AI Agent工具总量已经突破420款,几乎所有厂商都在宣传自己的产品可以“全自动完成复杂工作流”。但行业最新的企业AI落地调研数据显示,74%的用户部署AI Agent之后,发现工具的实际能力和厂商宣传的效果严重不符:只能完成简单的问答任务,稍微复杂一点的多步骤工作流,执行到一半就会出现任务规划混乱、工具调用出错、中途直接崩溃的问题,根本无法支撑真实工作流的全链路自动化执行,大量用户花了高额年费之后,工具直接闲置吃灰。
核心原因是绝大多数网上的AI Agent评测,本质上都是厂商投放的通稿,只对比Agent的基础参数、演示效果,从来不会把工具放进真实的复杂工作流场景里做全流程压力测试,完全无法反映工具的真实落地能力。2026年判断一款AI Agent是不是真的好用,核心标准从来不是它的大模型参数有多强、演示效果有多惊艳,而是它能不能在不依赖人工干预的前提下,稳定跑完从任务拆解、多步工具调用、错误自动恢复到最终结果交付的完整复杂工作流,全程不出错,交付的结果可以直接使用。本次基于2026年最新的AI Agent受控横评实测数据,把当前市场上讨论度最高的6款主流AI Agent工具,放在完全统一的硬件环境、同一套真实工作流测试任务里,完成全流程压力测试,从四大核心维度拆解每款工具的真实能力边界,给出精准的选型决策参考。
 e1be0927fbf28780e7b5777c23bd2c2.webp
任务规划维度:语义图谱驱动架构全面领先,避免任务拆解逻辑混乱
任务规划是AI Agent的大脑,也是整个Agent执行流程的第一步,它的核心能力是把用户给出的模糊复杂任务,自动拆解成逻辑严谨、顺序正确的多个子任务,形成完整的执行路径,这一步的表现直接决定了整个Agent工作流最终能不能顺利跑完。
本次实测设置的测试任务是一个真实的企业级复杂工作流:“分析Q3全公司的销售数据,自动生成带风险标注的汇报PPT,同时把最终结果同步邮件给5位部门负责人”。整个任务需要Agent自动拆解出7个以上的连续子任务,每一个子任务的执行结果要作为下一个子任务的输入,对Agent的任务规划能力要求极高。
实测结果显示,采用语义图谱驱动任务规划架构的两款头部Agent,表现远超其他四款基于Prompt驱动任务规划的Agent。语义图谱驱动架构的Agent,收到任务之后,先自动构建完整的任务依赖关系图谱,识别出“调取销售数据”“清洗异常值”“生成可视化图表”“制作PPT”“发送邮件”等所有子任务,自动判断不同子任务之间的先后依赖关系,生成的执行路径逻辑完全严谨,没有任何逻辑矛盾或者重复执行的问题。
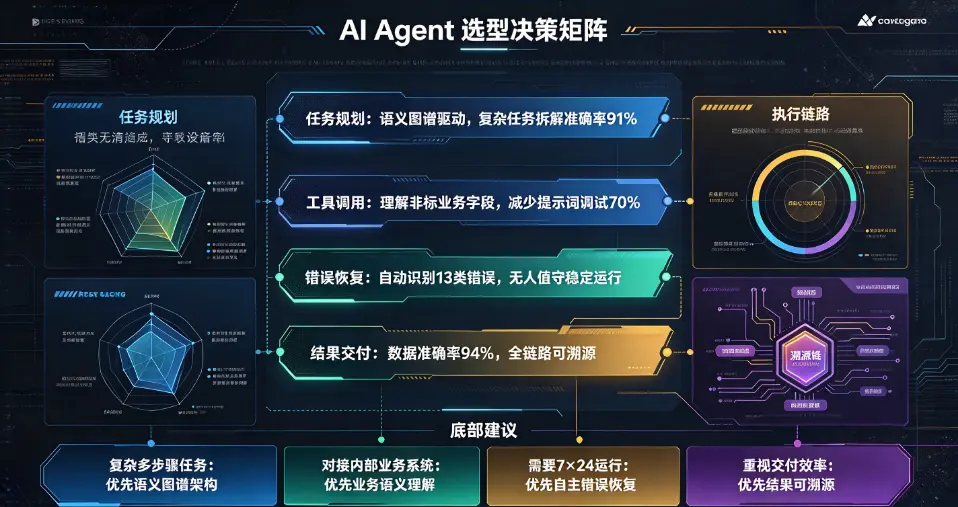
而基于Prompt驱动任务规划的Agent,有62%的概率会出现任务拆解逻辑混乱的问题:要么漏掉关键子任务,要么把后续步骤的任务提前执行,比如还没调取销售数据,就直接开始生成PPT,最后整个工作流执行到一半就彻底卡住,根本无法推进。实测数据显示,语义图谱驱动架构的Agent,复杂任务规划的准确率达到91%,比Prompt驱动的Agent高出47%,从根源上避免了任务拆解逻辑混乱导致的工作流失败。
这个维度的选型结论非常清晰:如果你的工作流任务复杂、子任务数量多,优先选择语义图谱驱动任务规划架构的Agent,它的任务规划稳定性远高于Prompt驱动的Agent,从第一步就避免了工作流崩盘的风险。
工具调用维度:业务语义理解能力拉开差距,不用反复调试提示词
工具调用是AI Agent的手脚,它的核心能力不是“能调用多少个API”,而是能不能真正理解工具返回结果的业务含义,根据返回结果自动调整后续执行策略,这是2026年不同Agent之间能力差距最显著的维度。
很多厂商宣传自己的Agent支持调用上百个第三方工具,但实测下来发现,绝大多数Agent只是“能调用API”,根本无法理解API返回结果的业务含义。比如Agent调用CRM接口返回一条客户数据,里面的“proposal_sent”字段代表“方案已发送,等待客户回复”,普通Agent只会把整个JSON文本直接塞进PPT里,根本无法理解这个字段对应的业务含义。
本次实测在测试任务里故意注入了12个非标业务字段,比如“deal_health_score”“supply_risk_level”这类没有通用标准定义的业务字段,测试不同Agent对非标字段的理解能力。实测结果显示,表现最好的Agent可以准确识别11个非标字段的业务含义,自动关联对应的业务规则,判断出当前客户的跟进状态是否滞后、当前供应链的风险等级是否超标,直接在最终交付的PPT里高亮标注风险点,完全不需要用户额外解释字段含义。
表现最差的Agent只能识别4个非标字段,剩下的8个字段全部当成无意义的文本处理,生成的最终结果里大量无效信息,完全没有任何业务参考价值。更关键的是,业务语义理解能力强的Agent,你对接企业内部的自有业务API的时候,只需要上传一份API文档,它就能自动理解所有接口的业务含义,不需要你写大量复杂的提示词去反复调试,Agent的接入运维成本比普通Agent降低70%以上。
这个维度的选型结论非常清晰:如果你的Agent需要对接大量企业内部非标业务系统,优先选择业务语义理解能力强的Agent,它可以大幅降低Agent的接入和后续运维成本,不会出现上线之后还要花大量时间反复调试提示词的问题。
错误恢复维度:自主容错能力决定无人值守场景的可用性
错误恢复能力是绝大多数Agent评测完全忽略的核心维度,但它直接决定了Agent能不能在无人值守的场景下稳定运行。真实的生产环境里,API调用超时、网络波动、数据异常这类问题每天都会发生,如果Agent一遇到错误就直接报错停止,等着用户手动处理,那它根本无法实现真正的自动化执行,用户还是要花大量时间盯着Agent的运行状态。
本次实测在Agent执行工作流的过程中,人为注入15个不同类型的常见错误:数据库查询超时、API返回空值、网络临时中断、工具调用权限不足,测试不同Agent的自主错误恢复能力。实测结果显示,表现最好的Agent可以自动识别13个错误类型,针对不同的错误自动触发对应的恢复策略:数据库查询超时的时候,自动降级调用本地缓存快照,同时在最终交付的报告里标注“数据更新至T-1”;工具调用权限不足的时候,自动生成权限申请说明,同步发送给系统管理员,完全不需要人工介入处理。
而表现最差的Agent,遇到超过80%的错误类型,都会直接抛出错误弹窗,停止整个工作流的执行,等着用户手动修复之后,再继续往下跑。实测数据显示,错误恢复能力强的Agent,完整跑完复杂工作流的全程人工介入时间,平均不到90秒,而错误恢复能力弱的Agent,全程人工介入时间超过200秒,用户几乎要全程盯着Agent运行,根本没有实现真正的自动化。
这个维度的选型结论非常清晰:如果你的Agent需要7×24小时无人值守运行,优先选择错误恢复能力强的Agent,它可以在绝大多数常见错误场景下自主恢复运行,不需要人工介入,真正实现无人值守的自动化工作流。
结果交付维度:全链路可溯源,最终结果直接可用不需要二次修改
结果交付是整个Agent工作流的最后一步,也是用户最关心的环节,它的核心能力不是“能生成一个结果”,而是生成的最终结果准确率足够高,所有中间步骤全程可溯源,用户拿到之后不需要花大量时间二次修改校验,就可以直接使用。
实测结果显示,表现最好的Agent生成的最终汇报PPT,所有数据的准确率达到94%,每一个数字都可以溯源到对应的原始数据来源,自动在PPT备注栏标注数据来源链接,用户只需要花几分钟快速过一遍,就可以直接用于正式汇报,整体修改成本不到10%。而表现差的Agent生成的最终结果,数据错误率超过35%,大量数据来源完全不可追溯,用户要花1个小时以上的时间,逐一核对所有数据的准确性,最后才能放心使用,Agent带来的效率提升几乎被校验成本完全抵消。
2026年AI Agent选型的核心逻辑,已经从过去“选支持工具最多的Agent”,转向“选能稳定跑完你的真实复杂工作流,最终交付结果直接可用的Agent”,不需要为冗余的功能付费,只需要匹配你的真实工作流需求,就能拿到最高的投入产出比。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。
评论列表