
2026 年 9 月,行业监测数据显示全球可用智能算力缺口已经突破 35%,AI 产业迎来新一轮基础设施压力测试。对比前两年单纯高端 GPU 芯片缺货,本轮算力危机呈现明显结构性特征:大模型训练算力供给压力有所缓解,但面向 AI 智能体、企业知识库、多模态生成的推理算力严重不足。大量云厂商采购到芯片,却受限于变电站扩容、HBM 内存、高速光模块交付周期,服务器无法上架投产,出现 “有芯片、缺电力、缺带宽” 的新型瓶颈。面对持续扩大的供需缺口,全球头部云厂商上调资本开支,启动下一代智算集群建设,核心思路从硬件堆叠转向异构架构重构。
本轮 35% 算力缺口的根源,是算力供给结构跟不上 AI 应用的需求迁移。2026 年全网 Token 调用量持续爆发,80% 以上算力消耗来自推理场景,而非一次性模型训练。推理任务具有高并发、短时突发、持续在线的特点,传统面向训练设计的大卡集群,在推理场景下资源利用率长期偏低。硬件配套层面,HBM 高带宽内存、高速光模块交付周期拉长,即便 GPU 产能提升,整机交付周期仍维持半年以上。电力基建更是核心卡点,一座万卡智算中心耗电量接近小型城镇,电网改造周期长达 2 至 3 年,远长于服务器采购周期,成为限制算力落地的硬门槛。
 1776b4b2b3071f6bbe98d714a6d95ee.webp
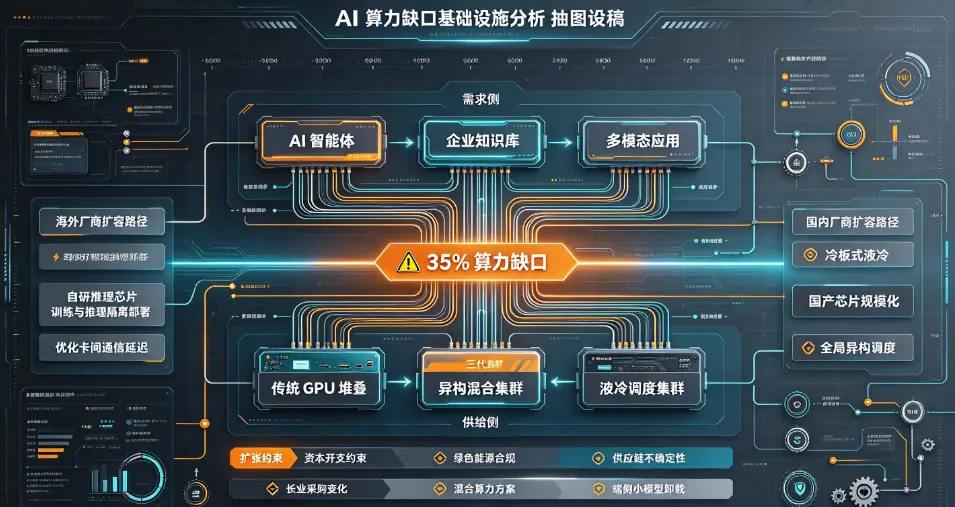
在此背景下,微软、谷歌、AWS 以及国内头部云厂商同步推进下一代智算集群扩容,新集群不再简单堆砌 GPU 服务器,转向异构算力混合部署。海外厂商重点推进自研芯片与通用 GPU 混合集群,微软 Azure 依托 Maia 自研推理芯片,专门针对 AI 智能体并发请求优化,降低单位 Token 成本;AWS 将 Trainium、Inferentia 芯片与高端 GPU 隔离部署,区分训练与推理负载,避免任务抢占带宽;谷歌 TPU 集群重点优化 Gemini 多模态与 Agent 应用的卡间通信延迟。
国内云厂商扩容路线聚焦液冷改造、国产芯片规模化落地与跨区域算力调度。字节、阿里、腾讯、百度新建智算中心普遍采用冷板式液冷技术,将机房 PUE 降至 1.1 以内,单机柜算力密度大幅提升。在软件层面,云厂商搭建全局算力调度平台,实现异构芯片统一纳管,自动将大模型训练任务分配至高端 GPU 集群,企业 RAG、智能体推理任务调度至低成本自研推理芯片,最大化提升算力利用率。
但算力集群扩容存在不可忽视的三大约束,意味着算力缺口短期难以快速抹平。第一是资本开支约束,万卡级智算中心投入巨大,硬件折旧周期长,叠加芯片快速迭代带来的资产贬值风险,云厂商不会无上限扩张。第二是绿色能源合规约束,欧美多地对大型数据中心能耗、碳排放出台管控政策,新建集群需要配套绿电,能源获取难度持续增加。第三是供应链地缘风险,高端芯片、HBM、高速互联组件供给存在不确定性,异构国产芯片的软件生态仍需持续打磨。
算力紧缺也直接改变企业算力采购策略。在算力充足时期,企业习惯于按需调用云端算力;而当前 35% 缺口环境下,大型企业开始提前一年锁定算力配额,签订长期框架协议。中小企业则放弃自建算力,转向混合算力方案,复杂推理任务使用云 API,文档处理、内部知识库等轻量任务部署端侧小模型,配合模型量化、稀疏推理技术降低算力消耗,用算法优化对冲算力供给不足。
行业机构预判,2026 年底至 2027 上半年全球算力缺口仍维持高位,直到 2027 下半年,本轮新建液冷异构智算集群集中投产,叠加自研推理芯片大规模商用,供需矛盾才会逐步缓解。长期来看,AI 产业竞争已经从模型算法下沉到底层算力基础设施。下一代智算集群的核心评价指标不再是峰值算力,而是推理并发能力、单位 Token 能耗、异构算力调度弹性。算力紧缺倒逼产业回归理性,低 ROI 的 AI 项目会被逐步淘汰,资源持续向高价值产业场景集中。
评论列表
Loading...