
一、先正视一个事实:朴素 RAG 的失败率高达 40%
动手前先泼冷水。有开发者复盘过真实经历:第一版知识库问答准确率只有 40%,被业务当场打回,后来一个个填坑才做到 90%——结论是"朴素 RAG 的失败率高达 40%,答不准真不是模型笨"[1]。更反直觉的是,很多人以为 RAG 的难点在生成,现实恰恰相反:检索质量才是生死线,你把检索结果的噪声喂给模型,再强的模型也会一本正经地胡说。所以这篇教程不教你"接个向量库就完事",而是按 2026 年的可靠工程实践,把七个坑逐个填平。
 25a040947493c43cf14d219c6952aab.webp
二、避坑一:分块别切坏
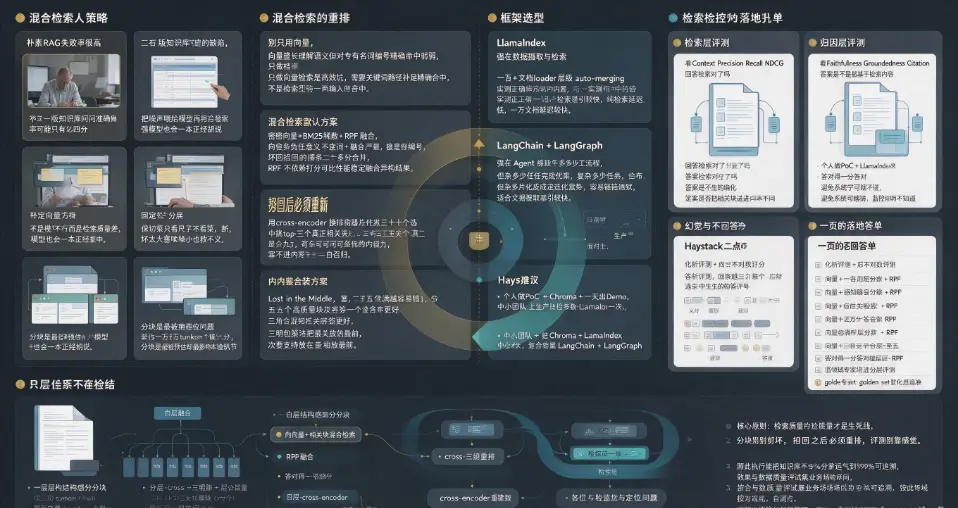
分块是 RAG 里最被低估、却最影响体验的环节。固定长度分块省事,但它不关心句子、段落、标题和上下文——"像切菜只看尺子不看菜"。切太大塞噪声、切太小断语义,坏分块=必败,后面再强也救不回[1]。2026 年的可靠做法是结构感知切分:尊重文档结构,在标题、段落、表格边界、代码块处切分;要更高的准确率就用层级分块——按多粒度存储(父块+子块)并在多层级检索,最准但最贵。一组被验证过的初始参数:父块约 1500 token、子块约 300、重叠约 60,配合 parent-child 检索。
三、避坑二:别只用向量
只做向量检索是另一个高频坑。向量擅长"理解语义",但对专有名词、编号这类精确命中很弱。2026 年的默认答案是混合检索:稠密向量 + BM25 稀疏 + RRF(Reciprocal Rank Fusion)融合——向量负责语义、关键词负责精准命中"SR-2026-08-xxx"这类编号,两路各召回前 20 条再合并[6][7]。RRF 之所以成为稳健默认,是因为它不依赖打分可比性,能稳定融合异构检索结果。
四、避坑三:召回之后必须重排
混合检索召回了一大堆,可最相关的那一条可能排在第八、第九——上下文窗口就那么大,塞不进去等于白召回。解法是 Rerank:召回后用 cross-encoder 重排器,从 30–50 个候选中挑出 top 3–5 个真正相关的块。这里还有一个反直觉原则——Lost in the Middle:塞得越满越容易错,3–5 个高质量块比 8 个混合相关块答得更好;若必须传多个块,用"三明治"策略:最相关的放最前、次要支持放中间、次相关的放最后[8][9]。
五、框架怎么选:LangChain vs LlamaIndex vs Haystack
框架选型有 2026 年的实测数据支撑。LlamaIndex 强在数据摄取与检索:100+ 文档 loader、层级分块、auto-merging 内置,实测正确命中段落率 87.3%(vs LangChain 74.1%),纯检索延迟约 180ms p99、比 LangChain 快约 25%,1 万文档建索引仅约 14 秒。LangChain(+LangGraph)强在 Agent 编排与多步工作流,四工具 ReAct Agent 11.4 秒完成任务(vs LlamaIndex 19.2 秒),但文档碎片化、版本迭代快、容易"链地狱"[10][11][13]。Haystack 2.0 面向生产,代码清晰、内建可观测性(首 token 约 145ms)。选型建议:个人做 PoC 用"Chroma + LlamaIndex"一天出 Demo;中小团队上生产选 Haystack;复杂多步编排选 LangChain/LangGraph[14][15]。
六、评测别靠感觉:从检索到归因的四层指标
"感觉答得不错"在 2026 年不够了。评测要分层做:检索层看 Context Precision/Recall、NDCG——问"检索对了吗";归因层看 Faithfulness/Groundedness/Citation——问"答案是不是都基于检索内容",RAGEval 明确区分:Hallucination(无中生有)是生成器问题、Irrelevance(答非所问)是检索问题,先定位再修。还要注意一个细节:幻觉评测要用非对称打分——答对得 1 分、答错要扣更多(如 k=4),否则系统会学会"宁可瞎猜"而不是"承认不知道"。用领域专家标注的 golden set 做评测仍是金标准[19]。
七、一页式落地清单
给从零开始的人一张可照做的路线图:① 解析文档并保留元数据(来源、标题、时间);② 结构感知/层级分块(父 1500/子 300/重叠 60);③ 向量 + BM25 混合检索,RRF 融合;④ 召回后 cross-encoder 重排,只取 top 3–5;⑤ 按"检索→归因→回答"分层评测,用 golden set 量化准确率;⑥ 把最相关块放最前组装上下文(三明治策略);⑦ 监控幻觉与不可回答率,答不出就明确"不知道"。照此执行,你能把知识库从"40% 靠运气"做到"90% 可追溯"。
免责声明
本文基于公开资料、社区工程实践与 2026 年公开实测数据整理,仅供检索增强生成(RAG)技术学习、工程实践与方案选型参考,不构成任何投资、商业、法律或技术选型承诺,亦不构成对任何框架、产品、数据库或厂商的推荐或背书。文中涉及的失败率、准确率、延迟、框架性能等数据均以相关方公开发布口径为准,可能随版本、数据集、硬件与场景变化,请以官方信源与自测结果核实。RAG 系统效果与数据质量、评测集、业务场景高度相关,具体结果不可简单复制;涉及企业私有数据与隐私时,请严格遵守相关法律法规与数据安全要求。作者与发布方不对因使用本文内容产生的任何直接或间接后果承担责任。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。
评论列表