
引言
过去两年大量企业落地文本 RAG 项目,但普遍遇到一个共性瓶颈:企业内部知识资产并非只有纯文字。技术手册里的原理图、财务报告中的数据图表、产品 PPT、内部培训录音、会议录播视频,这些非文本信息占据企业知识总量 60% 以上,单纯依靠 OCR 提取文字,会丢失空间结构、时序画面、图表逻辑,问答结果经常出现错读图表、遗漏视频关键信息的问题。
2026 年,多模态 RAG 不再是实验室原型方案,已经进入企业规模化落地阶段。区别于早期 “图片转文字 + 传统文本 RAG” 的简易拼接方案,新一代多模态 RAG 在统一向量空间内完成文本、图像、音频、视频的特征对齐,并引入 Agentic RAG 智能体循环:智能体自主拆解复杂业务问题,按需检索不同模态知识库,校验检索结果,多轮迭代直到获取足够证据,最终输出带原始素材引用的答案。基于 ViDoRe V3 基准 2026 实测数据,优化后的多模态 RAG 相比纯文本 RAG,复杂图文场景答案召回率提升 28%~34%,图表类问题准确率提升超过 40%。本文从工程实战角度,完整讲解从原始素材处理到企业知识智能体上线的整套流程。
一、企业多模态素材接入:分模态预处理流水线
搭建多模态 RAG 的第一步,不是直接调用嵌入模型,而是针对不同类型素材设计差异化的解析流水线,这也是很多企业原型项目上线后效果大幅衰减的核心原因。
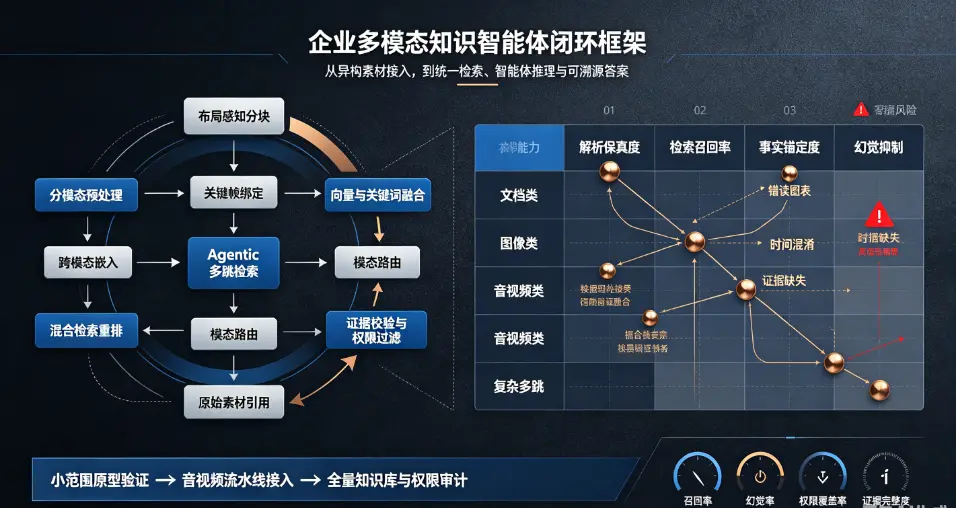
文档类素材(PDF、Word、PPT),不再简单按固定字符长度切块。2026 主流方案采用布局感知分块,识别页眉、标题、正文、表格、图片、公式的页面层级结构,保留文档阅读顺序。对于扫描件 PDF,使用布局 OCR 同时提取文字与图片坐标,将页面内图表单独切分,作为独立图像索引单元。MM-BizRAG 方案在财报、技术文档场景实测,布局感知解析相比普通全局 OCR,检索准确率提升最高可达 32%。
图像素材包含截图、工程图纸、数据图表。处理流程分为两步:由多模态 VL 模型生成详细结构化描述,标注坐标轴、图例、数据趋势;同时保留原图向量嵌入,实现 “文字提问检索图片,图片提问检索文档” 双向跨模态检索。仅靠图片描述文本做检索,会丢失图像细节,遇到细粒度图表对比问题极易产生幻觉。
音频与视频素材是企业知识库最难处理的模块。标准流水线包含:ASR 语音转写,区分不同发言人;按时间窗口切片,提取关键帧;将关键帧与对应时间段的字幕做时间戳绑定。视频不会把全部帧入库,而是通过画面熵值变化筛选关键帧,剔除重复画面,降低向量存储成本。当用户提问 “这段培训视频里演示的设备参数截图在哪一分钟”,系统可以同时检索字幕文本与关键帧图像,直接定位视频时间点并返回对应画面。
所有素材处理完成后,统一附加元数据:文档来源、部门、上传时间、权限标签、页码 / 时间戳。元数据在检索阶段做过滤,实现企业内部细粒度数据权限隔离,避免敏感资料越权检索。
 66e29f367e634386b0d7c43e2cd7915.webp
二、跨模态嵌入与向量库选型:构建统一语义空间
多模态 RAG 核心难点在于,文本、图片、音视频属于不同信号空间,需要通过多模态嵌入模型映射到同一个向量空间,实现跨模态混合检索。2026 年嵌入模型已经分化两大路线:一类是统一多模态嵌入模型,直接输入图片 / 文本输出同维度向量;另一类是双编码器方案,文本编码器、视觉编码器分开训练,后做跨模态对齐。
在企业落地选型上,需要权衡检索精度、推理成本、私有化部署能力。公开实测数据显示,新一代多模态嵌入模型在图文跨模态检索任务 R@1 指标普遍达到 0.88 以上,但推理算力开销高于传统文本嵌入模型。向量数据库必须支持多模态向量存储、混合检索、元数据过滤与重排能力,Milvus、Weaviate、PGVector 都已在 2026 版本完善多模态向量支持,支持同时检索文本向量、图像向量,再使用交叉编码器做结果重排,融合多模态检索结果,降低模态带来的检索偏差。
工程上的一个实战技巧:不要完全依赖向量检索。采用 “关键词检索 + 多模态向量检索” 混合检索策略。关键词检索负责精准匹配专有名词、编号;向量检索负责语义模糊查询;两路结果通过 reciprocal rank fusion 算法融合重排,兼顾召回率与准确率,大幅降低单一向量检索带来的漏检问题。
三、知识智能体编排:Agentic 多模态 RAG 循环架构
2026 年多模态 RAG 最大创新点,就是将检索逻辑交给知识智能体,从过去 “一次查询、一次检索” 的单轮 RAG 升级为 Agentic RAG 闭环。智能体的工作流程分为四步:问题拆解、模态路由、多跳检索、结果校验。
收到用户复杂业务问题,智能体先判断问题需要哪种模态证据:如果是产品参数对比,检索文档文本;如果是图纸结构问题,检索图像;如果是会议历史决议,检索音视频字幕与关键帧。当第一轮检索信息不足时,智能体会生成子查询,继续检索其他文档、图片或者视频片段,完成多跳检索。检索完成之后,调用校验模块,对照原始素材校验生成答案,剔除没有证据支撑的内容,抑制幻觉。
这套智能体架构特别适合企业复杂场景,例如 “对比三份版本的产品手册原理图差异,结合培训视频说明改动带来的风险点”。这类问题需要同时检索文档文本、多张原理图、视频关键帧,传统静态 RAG 很难一次性召回全部证据。根据 2026 行业实测,Agentic 多模态 RAG 在多模态多跳问题场景,答案准确率相比静态 RAG 提升 25% 左右,但代价是增加推理调用开销,企业可以设置阈值,简单查询直接走基础检索,复杂问题才启动智能体循环,平衡延迟与成本。
四、幻觉抑制、评测体系与企业落地风险管控
多模态 RAG 幻觉问题比纯文本 RAG 更隐蔽:模型可能看错图表坐标轴、误读图片文字、混淆视频不同时间点信息,而且错误很难人工识别。在实战项目中,需要三层幻觉控制手段。第一,检索时强制绑定原始素材引用,生成答案附带页码、图片 ID、视频时间戳;第二,增加证据校验环节,VL 模型核验检索到的图像证据是否支持结论;第三,设置拒绝机制,检索证据不足时直接说明无法回答,禁止编造信息。
评测层面,不能只依靠人工主观打分。2026 企业项目普遍采用 ViDoRe V3、UniDoc-Bench 多模态评测集,从解析保真度、检索召回率、答案事实 groundedness(事实锚定度)三个维度持续自动化评测,在知识库新增文档、更新模型版本后自动回归测试,防止系统效果退化。
企业场景还有合规与权限风险。多模态知识库包含大量内部图纸、会议录音、财务截图,必须在检索层接入权限控制,不同角色只能检索权限范围内素材;音视频转写内容需要脱敏,自动屏蔽手机号、身份证等敏感信息;所有问答日志、检索记录留存审计,满足企业内控要求。
五、落地路径与成本收益分析
企业搭建多模态知识智能体不建议一步到位上线全量素材,推荐分三阶段迭代。第一阶段,选取高价值小范围知识库,例如产品手册、技术图纸,搭建原型,验证图文检索效果,重点优化文档布局解析与图像检索链路。第二阶段,接入会议录音、短视频培训素材,完善音视频预处理流水线,调试智能体多跳检索逻辑。第三阶段,全量知识库上线,接入企业内部 OA、文档系统,实现知识库自动增量同步,配套权限、审计、监控体系。
成本结构上,多模态 RAG 算力开销主要集中在素材入库阶段:图像描述、视频关键帧提取、ASR 转写都是一次性批处理开销;线上推理阶段,向量检索开销可控。对比传统人工知识库维护,多模态知识智能体可以把内部资料查询耗时降低 70% 以上,在技术支持、研发、售后培训场景 ROI 优势明显。
结语
2026 年,企业知识智能体的核心能力不再局限于文字问答,而是统一理解文档、图表、图片、音视频混合信息。多模态 RAG 的落地难点不在于大模型本身,而在于分模态素材预处理、跨模态向量对齐、混合检索融合、智能体检索编排以及企业数据权限与幻觉治理整套工程体系。
随着多模态嵌入模型、向量数据库、Agent 编排框架持续迭代,未来企业知识智能体可以做到自主读取企业全部异构资料,跨文档、跨图文、跨音视频完成复杂推理。但企业落地依然需要理性看待边界:多模态 RAG 不是万能的,素材质量、解析精度、证据是否充足,直接决定最终问答效果。只有把预处理、检索、校验、评测全链路闭环做好,才能真正搭建稳定可用、可溯源、低幻觉的企业多模态知识智能体。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。
评论列表