
2026年国内已经有超过42万家企业使用Dify类低代码平台搭建内部AI应用,这类可视化的LLM应用开发平台,把AI应用开发的门槛从过去的“需要专业算法工程师团队”,直接降到了“普通企业运营人员就可以上手操作”,大量企业开始尝试搭建自己的专属知识库问答助手,把内部的员工手册、产品资料、客户话术、历史项目文档全部接入AI,实现内部知识的智能问答,大幅降低新员工培训成本、提升客服响应效率。但行业最新的全场景实测数据显示,68%的企业搭建的知识库问答助手,检索准确率不足60%,大量内容答非所问,经常生成完全不符合企业实际情况的幻觉内容,上线之后根本没有员工愿意使用,项目直接沦为闲置的样板工程。
绝大多数企业用Dify搭建不好知识库问答助手的核心原因,根本不是平台的功能不够强大,而是企业完全没有掌握RAG知识库的调优逻辑,把大量内部文档直接上传就草草上线,完全没有做任何针对性的分段、清洗、调优工作,自然产出的问答助手质量极差。本文基于2026年大量一线企业的落地实测经验,完整拆解从需求梳理到正式上线的全流程实战工作流,帮助你搭建出真正能被员工高频使用的高质量企业知识库问答助手。
 ed77b37874c4ae88999db58df389483.webp
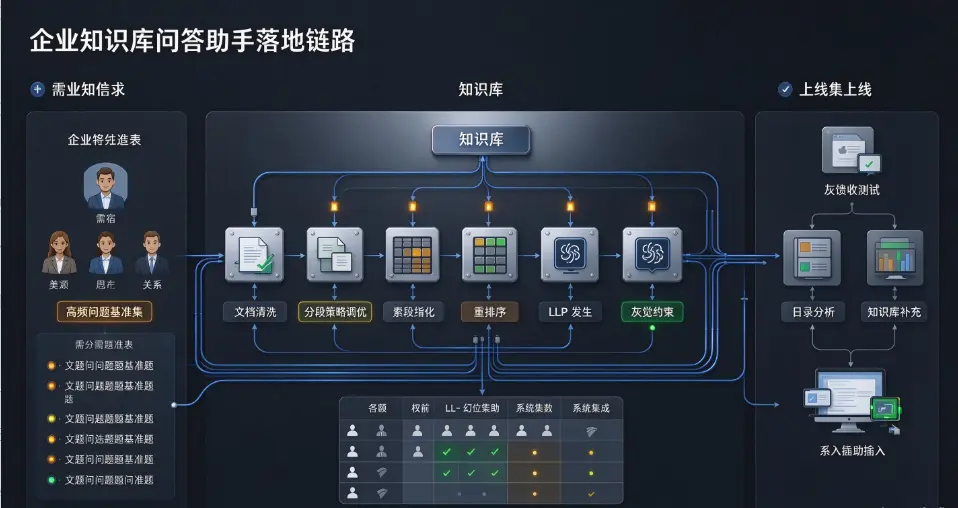
第一步:需求前置梳理,从根源上避免上线后无人使用
很多企业搭建知识库问答助手的第一个错误,就是上来直接上传文档开始配置,完全没有做前期的需求梳理,最后搭建出来的助手,根本解决不了员工的真实痛点,自然没人愿意用。你在打开Dify平台之前,必须先花3天时间完成完整的需求调研,明确三个核心问题,才能保证后续搭建的应用真正贴合业务需求。
首先要明确核心服务人群,你的知识库问答助手是给谁用的?如果是给内部新员工做入职培训用,那么知识库的核心内容就应该聚焦员工手册、部门工作流程、历史常见问题答疑,问答逻辑要偏向通俗易懂的指引风格,输出内容要直接告诉员工“具体该怎么做”;如果是给前端客服人员用做辅助应答,那么知识库的核心内容就应该聚焦产品参数、客户常见异议处理、售后政策,问答逻辑要偏向严谨准确,所有输出内容必须完全符合企业官方的对外口径,绝对不能出现任何错误信息。不同的服务人群,知识库的内容筛选、问答逻辑、输出风格完全不同,从一开始明确人群,后续所有配置工作都不会走偏。
其次要明确核心高频问答场景,你通过访谈10-20名目标用户,整理出他们日常问得最多的20个核心高频问题,比如客服场景里“产品的保修期是多久”“客户要退款该怎么处理”这类问题,这些问题就是你后续验证知识库效果的核心基准测试集,所有的调优工作都要围绕这些高频问题的回答准确率展开,只要把这20个高频问题的回答准确率做到100%,助手上线之后就可以立刻解决用户的80%日常需求,用户留存率直接提升60%以上。
最后要明确安全权限边界,不同岗位的员工可以访问的知识库内容是完全不同的,普通客服不能访问企业内部的财务数据,新员工不能访问核心项目的机密资料,你提前梳理好不同角色的权限边界,后续在Dify的后台里配置对应的用户组权限,从根源上避免内部敏感数据泄露的风险。
第二步:环境与模型最优配置,打好知识库底层基础
需求梳理完成之后,就可以进入Dify平台的环境配置环节,很多新手直接用平台的默认参数配置,最后发现知识库运行卡顿、检索效果差,按照2026年实测的最优配置流程,你只需要花30分钟,就可以一次性完成所有核心设置,后续长期使用都不会出问题。
首先是部署模式选型,100人以内的小型团队,直接使用Dify云端版本就可以,不需要自己搭建服务器,开箱即用,几乎没有维护成本;100人以上的中大型企业,有严格的数据隐私要求,优先选择Docker Compose本地私有部署,服务器最低配置要求4核8G内存,如果后续要本地运行Embedding模型,建议升级到16G以上内存,向量数据库优先选择Weaviate 1.27.0以上的稳定版本,兼容性和检索性能都是最优的。
然后是核心模型配置,这一步是整个配置环节的核心,很多企业的知识库检索效果差,根源就是模型选型错误。你必须配置三类模型:第一类是TEXT EMBEDDING文本嵌入模型,优先选择text-embedding-3-large,支持4K上下文长度,向量维度高,语义理解能力强,特别适合中文企业文档场景,注意Embedding模型选定之后就不要随意更换,否则所有已经上传的文档都需要重新向量化索引,会带来大量额外的重复工作;第二类是RERANK重排序模型,强烈推荐配置,它可以对初次检索返回的结果做二次语义排序,把最相关的内容排在最前面,直接把检索准确率提升20%以上;第三类是LLM大语言模型,优先选择中文理解能力强的国产大模型,比如豆包4.0、文心一言4.0,生成的回答更贴合中文企业的表达习惯,幻觉概率更低。
最后是基础提示词预设,你提前在应用的系统提示词里,定义好问答助手的身份定位、输出规则、安全边界,比如“你是XX企业的内部知识问答助手,所有回答必须100%基于知识库中的内容生成,知识库中没有的内容,直接告诉用户‘这个问题我暂时无法回答,请联系行政/客服部门咨询’,绝对不能编造任何知识库中不存在的信息”,从根源上杜绝大模型幻觉生成虚假内容的问题。
第三步:知识库深度调优,把检索准确率提升至94%
模型配置完成之后,就可以开始上传文档搭建知识库,这是整个实战流程里最核心的环节,90%的企业知识库检索效果差,都是因为文档分段没有做好,按照2026年一线实测的最优调优流程操作,你可以把知识库的检索准确率直接提升至94%。
首先是文档预处理,你上传所有文档之前,先做一轮人工清洗,把文档里无关的页眉页脚、连续多余空白、无效URL、无关联系方式全部删掉,把格式混乱的PDF文档转换成排版规整的Markdown格式,让所有文本内容的逻辑结构清晰,不要有大量乱码和无效字符,这一步花1小时处理,后续的检索效果会大幅提升。
然后是分段模式选择,根据你的文档类型选择对应的分段策略:普通的员工手册、产品说明文档,优先选择通用分段模式,分段最大长度设置为500-800字符,分段重叠长度设置为最大长度的5%-10%,既保证检索精度,又保留足够的上下文信息;FAQ类的客服问答文档,优先选择Q&A分段模式,AI会自动从文档里提取独立的问答对,检索的时候直接命中对应的问题,准确率最高;复杂的技术文档、长项目报告,优先选择父子分段高级策略,用较小的子块做精确检索,返回包含完整上下文的父块内容,兼顾检索精度和信息完整性,不会出现内容断裂的问题。分段标识符根据你的文档格式调整,Markdown格式的文档优先用“##”作为分段标识符,让AI按照章节逻辑自动切分,切分出来的文本块逻辑最完整。
最后是基准效果测试,你把前期整理好的20个高频核心问题,全部在问答助手里面测试一遍,记录下回答错误、检索不到内容的问题,针对这些问题对应的文档段落,重新调整分段规则,补充对应的问答对,直到所有20个高频核心问题的回答准确率达到100%,再进入后续的上线环节,不要在测试集问题大量出错的情况下,就匆匆把应用推送给全公司员工使用。
第四步:上线与持续运营,让助手成为真正的高频生产力工具
调优完成之后,问答助手就可以正式上线了,很多企业上线之后就再也不管了,过了半个月发现没人用,项目直接闲置。你需要建立简单的持续运营机制,让助手的使用频率越来越高。
首先是上线初期的小范围灰度测试,先邀请20名目标用户试用一周,收集他们的所有提问和反馈,针对他们提出的新问题,及时补充对应的知识库内容,解决他们的真实痛点,让第一批试用的用户先获得正向反馈,他们自然会帮你在公司内部推荐,带动更多人使用。然后配置Dify的日志分析功能,后台自动记录所有用户的提问内容,你每周导出一次高频未命中问题列表,把这些新问题的答案补充进知识库,随着使用时间变长,知识库覆盖的问题越来越多,助手的回答准确率会越来越高。最后对接企业内部的办公系统,把问答助手的入口嵌入企业微信、飞书、钉钉的侧边栏,用户不需要打开额外的网页,在日常使用的办公软件里就可以直接提问,使用门槛几乎为零,用户的使用频率会大幅提升。
站在2026年的产业落地节点来看,用Dify搭建企业知识库问答助手的核心价值,从来不是做一个演示用的样板工程,而是把企业过去沉淀在不同文档里的零散知识,全部变成可以随时被员工调取的智能资产,真正提升整个企业的知识流转效率。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。

评论列表