
一、2026 的转折:从"拼接"到"原生全模态"
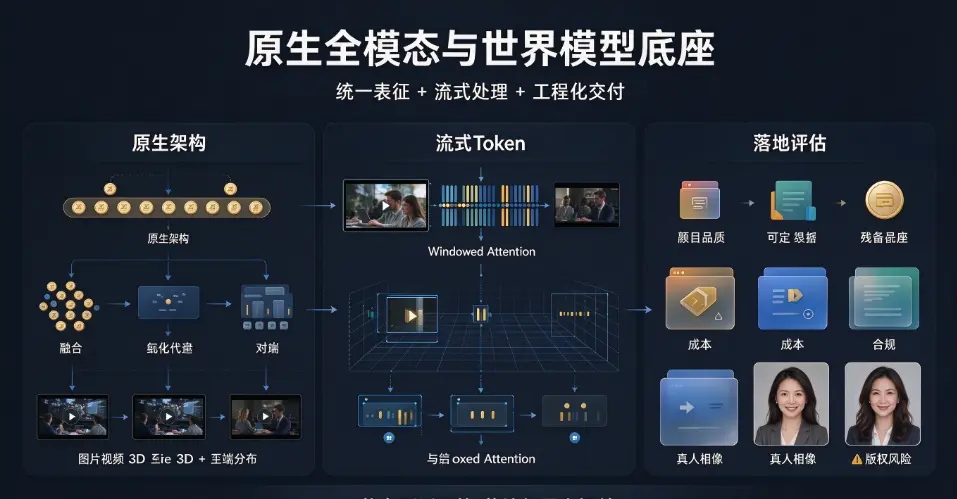
2026 年多模态最根本的变化,是架构从"拼接"走向"原生"。过去的多模态模型多是"图像识别模块 + 文本生成模块"的拼盘;而现在,以 arXiv 提出的"原生多模态建模路线图"为代表,业界正在区分"架构原生性"——早期融合/中融合是否在模型底层统一,并按输入输出关系分为"多模态到文本、多模态到目标"等范式[1]。落地侧,智象未来等团队选择"多模态→原生全模态→世界模型"的路线,用原生全模态底层架构打通图像、视频、3D、动作等信号,实现端到端对齐[2]。一句话:模型不再"分别看图和写字",而是在底层学会"同一套对世界的表征"。
 8f15ee897719f6491104d662912a40a.webp
二、文本→图像:从"能生成"到"懂审美、能干活"
图像侧 2026 年已进入"作品级"竞争。Google 的 Nano Banana 系列把高质量图像生成带进 Gemini 生态,Gemini 引入图像能力后 MAU 三个月内明显增长[3]。国内阵营同样活跃:阿里的 Qwen3.8-Omni-Flash(2026-09 发布)是新一代原生全模态模型,主攻音乐视频(MV)创作、影视制作、多媒体解说与实时音视频对话等复杂视听应用[4]。Black Forest Labs 的 FLUX 3 则把图像、视频、音频放进统一架构,原生支持多语言对话与动作预测[5]。图像生成的竞争已从"像不像"转向"审美、可控性与生产力"。
三、图像→视频:从"生成片段"到"作品交付"
视频是 2026 年竞争最激烈的战场,且正从"生成几秒片段"升级为"交付完整作品"。Google Gemini Omni Flash(2026-06-30 开放)把多模态推理与视频生成、编辑统一在一个模型里,支持从文本、图像、视频输入做高质量视频生成与对话式剪辑[6]。国产阵营全面跟进:快手可灵 Kling 4.0(2026-10 上线)支持 10-bit HDR、4K/1080p/21:9 超宽画幅[7];通义万相 Wan2.6 系列覆盖文生视频、图生视频、参考生视频等五大模型,可用"视频参考生成"把人物或任意物体作为主角生成单人/多人合拍[8];智象未来 HiDream-O1-Video-1.0 在 Artificial Analysis 的 Image to Video 排行榜进入全球前四[2]。xAI 的 Grok Imagine Video 1.5 也以近 2 倍速度和原生音频冲击榜首[9]。
四、视频→世界模型:空间智能与物理 AI
最前沿的跃迁,是从"生成视频"走向"理解并重建世界"的世界模型。李飞飞团队 World Labs 发布的 Atlas(2026-09),被称作"首个能以像素级相机控制生成图像与视频帧、并将其重建为 3D 的全模态世界模型",原生处理文本、图像、视频、3D 四种数据[10][11]。NVIDIA 的 Cosmos 3 则是首个完全开源的全模态物理 AI 模型,把物理推理、世界生成、动作生成放进单一开放模型,供机器人等 Physical AI 场景使用[12][13]。消费侧,PixVerse R2 把实时世界模型推进为"可玩的游戏引擎",Murea-Pro 则在交互视频世界模型评测 WBench 中以 81.1 分登顶(交互能力 82.6、物理合理性 74.4)[14][15]。
五、技术底座:原生架构与流式 token
支撑上述跃迁的底层技术,集中在两点:原生架构与流式 token 化。LLaVA-OneVision-2 展示了这一方向:基于原生视觉编码器与 Windowed Attention,其关键创新是"codec-stream tokenization"——把压缩视频当作连续的比特成本流处理,在保持原生分辨率的同时高效完成局部计算,显著提升视频理解能力[16]。这意味着模型对视频的理解不再是把帧当独立图片,而是像读语言一样"流式"地处理连续视觉信号——这是视频生成与世界模型共同依赖的地基。
六、2026 判断:产业落地与商业化
能力跃迁之外,商业化同样在提速。行业研报指出,国内科技大厂在视频、音频/音乐生成等细分领域已实现局部反超,图像(Midjourney)、视频(快手可灵)、音频(ElevenLabs)等 AI 原生应用的年度经常性收入(ARR)已达数亿美元量级[3]。对从业者与使用者,2026 年的务实判断是:多模态已跨过"能不能"的门槛,进入"好不好用、贵不贵、能不能稳定交付"的工程与商业阶段。挑工具时别只看演示,要结合生成质量、可控性、成本与合规(尤其涉及真人肖像、版权素材时)综合评估——能力跃迁再快,落地仍需人把关。
免责声明
本文基于公开资料、权威媒体(新华网、新浪财经、36氪等)、厂商官方公告与第三方评测平台 2026 年公开发布的信息整理,仅供多模态大模型技术趋势科普与行业研究参考,不构成任何投资、商业或技术选型建议,亦不构成对任何模型、产品或厂商的推荐或背书。文中涉及的模型能力、评测分数、榜单排名、发布时间与商业化数据(如 Gemini Omni Flash、Cosmos 3、Atlas、Kling 4.0、Wan2.6、HiDream-O1、LLaVA-OneVision-2 等)均以相关机构与发布方公开发布为准,可能随版本与时间变化,请以官方信源核实。多模态生成在涉及真人肖像、版权、虚假信息与内容安全等场景存在合规与伦理风险,使用请遵守所在地法律法规并审慎评估。作者与发布方不对因使用本文内容产生的任何直接或间接后果承担责任。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。
评论列表