
2026年是人工智能技术发展历程中极具标志性的转折点。过去三年,整个行业的技术演进主线始终围绕着文本大模型的参数规模扩张与推理效率优化展开,而到了2026年,这条发展路径已经走到了一个关键的拐点:单纯依靠文本大模型的能力提升,已经无法匹配千行百业的真实产业需求,AI技术的核心演进主线,正式从“单模态文本大模型的能力堆叠”全面转向“全链路多模态原生体系的构建”。2026年第三季度全球AI产业的最新数据显示,多模态相关的技术专利申请量同比2025年增长了217%,多模态AI的产业落地项目占比首次超过纯文本大模型项目,达到58%,这意味着多模态已经从过去的“锦上添花的附加功能”,变成了AI落地产业的核心刚需能力。
 8125b68ee2c43943dbde17b26ca0394.webp
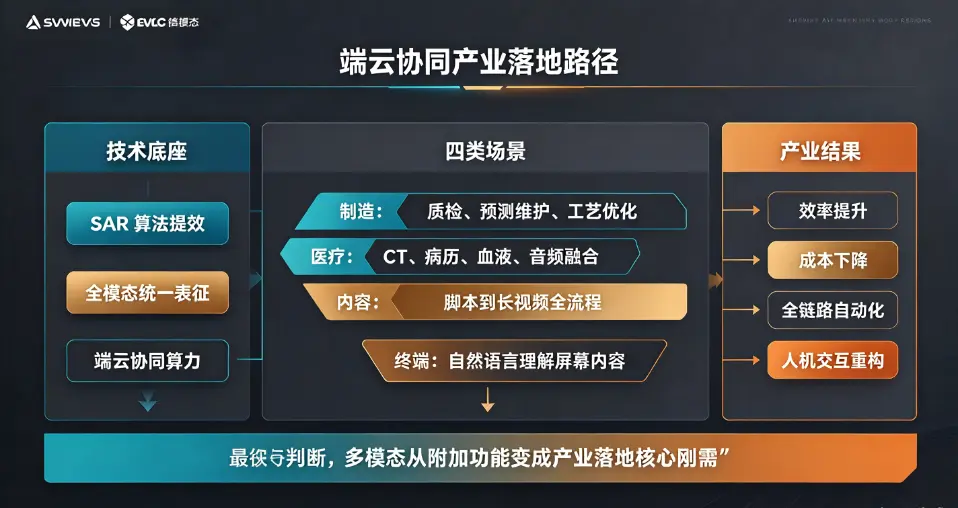
整个行业的技术跃迁不是凭空发生的,而是三大底层核心突破共同作用的结果,每一项突破都从根源上解决了过去多模态AI长期无法大规模落地的核心痛点。第一个底层突破,是大模型底层算法的革命性升级——子空间对齐重连线(SAR)技术的全面落地,彻底打破了长期困扰行业的“多模态训练互相干扰”的技术瓶颈。在2026年之前,行业内的多模态大模型几乎都是“拼接式”架构:先分别训练文本大模型、图像模型、音频模型,再用一个适配层把不同模态的输出强行拼接在一起,这种架构天然存在难以解决的缺陷:不同模态的特征空间完全不统一,模型处理多模态混合任务时,不同模态的信息会互相干扰,经常出现“看到图片就忘了文字要求”“听了音频就对不上画面内容”的问题,最终的多模态效果远达不到产业落地的标准。
2026年由清华大学AIR与字节跳动Seed团队联合研发的SAR技术,从数学底层彻底解决了这个问题。这项技术通过奇异值分解,把模型参数里真正负责跨模态连线的非对角元素,和仅负责单模态技能缩放的对角元素完全分离开,不需要对全量参数做重新训练,仅用不到0.6%的参数量,就实现了不同模态特征空间的自动对齐,让模型获得了类似人类的多感官协同认知能力。基于SAR技术训练出来的新一代多模态大模型,在图文音视频混合的复杂任务上的表现,比传统拼接式多模态模型提升了37%,这也是2026年所有头部厂商发布的新一代旗舰多模态模型,都能实现能力跃升的核心底层技术支撑。
第二个底层突破,是全模态统一表征架构的全面普及,AI第一次实现了对文本、图像、音频、视频、3D点云、传感器数据所有模态信息的统一理解,不再需要针对不同模态做单独的模型适配。2026年之前的多模态模型,大多只能处理“文本+图像”的简单组合,面对视频、3D数据、工业传感器这类复杂模态信息,处理能力非常弱,根本无法进入工业、医疗这类对多源数据融合要求极高的核心产业场景。而2026年发布的新一代旗舰多模态模型,比如谷歌Gemini 4 Argon、OpenAI GPT-6.1 Astra,全部采用了全模态统一表征架构,所有不同类型的输入信息,都在同一个底层向量空间里完成表征,模型可以像人类一样自然地同时理解一段工业视频、设备传感器的时序数据、技术手册里的文字说明、设备3D模型的几何特征,所有信息在同一个认知体系里完成融合分析。
这种架构带来的能力提升是革命性的:在工业质检场景里,新一代多模态AI可以同时读取生产线的实时监控视频、设备的振动传感器数据、产品的X光扫描图像、质检标准的文字文档,自动识别出过去人类工程师都很难发现的隐性生产缺陷,质检准确率比传统单一视觉质检方案提升了42%;在医疗场景里,AI可以同时融合患者的CT影像、血液检测时序数据、电子病历文字描述、医生的口述问诊音频,自动生成完整的诊断辅助报告,对早期疑难病症的识别准确率提升了28%,这在纯文本或者简单多模态的时代是完全不可能实现的。
第三个底层突破,是端云协同的多模态算力体系的成型,彻底解决了多模态AI落地的高成本痛点。多模态AI的算力消耗是纯文本大模型的数倍,在2025年之前,运行一个高质量的多模态大模型,需要几十张高端GPU集群,推理成本极高,绝大多数中小企业根本负担不起。而2026年整个行业的算力架构发生了根本性的变化:云端的十万卡级全国产AI超集群已经全面落地,借助SAR算法的推理提效能力,云端多模态大模型的推理成本比2025年降低了70%;同时端侧多模态大模型的技术已经完全成熟,比如面壁智能2026年推出的MiniCPM-V 4.7,在普通的旗舰手机上仅占用3GB内存,就能实现每秒13个Token以上的多模态解码速度,完全可以在本地运行复杂的多模态任务。这种“大模型复杂任务跑云端,高频轻量多模态任务跑端侧”的端云协同算力体系,让多模态AI的整体使用成本直接下降了一个数量级,普通中小企业也能负担得起,这是多模态AI从演示走向大规模产业落地的核心基础设施保障。
在三大底层技术突破的支撑下,2026年多模态AI的产业落地路径已经非常清晰,不再是过去零散的试点项目,而是形成了覆盖不同行业的成熟落地方案。在制造业场景,多模态AI已经深度融入智能工厂的全流程,从生产线上的实时多模态质检,到设备的预测性维护,再到生产工艺的自动优化,新一代多模态AI系统可以自动融合工厂里的所有多源数据,帮助工厂把整体生产效率提升20%以上,2026年国内已经有超过300家大型制造企业完成了这类多模态AI系统的部署。在内容生产场景,多模态原生AI已经实现了从文字脚本直接生成完整长视频的全流程自动化,不需要中间的人工剪辑、特效制作环节,生产效率比传统模式提升了10倍以上,大量短视频、影视制作公司已经开始全面采用这类新一代多模态生产工具。在智能终端场景,端侧多模态AI已经成为新一代旗舰手机、智能汽车的标准配置,用户可以直接用自然语言对着手机描述需求,手机自动理解屏幕上的所有图文视频内容,完成对应的操作,彻底改变了传统的人机交互模式。
2026年从大模型到多模态的技术跃迁,本质上是AI从“能看懂文字”进化到“能像人类一样感知和理解真实物理世界”的历史性跨越。过去纯文本大模型只能处理数字世界里的信息,而多模态原生AI打通了数字世界和物理世界的连接通道,这也是接下来十年AI技术最大的产业红利来源。对于所有从业者来说,跟上这次从大模型到多模态的技术跃迁节奏,提前布局对应的落地场景,才能真正抓住这一轮AI技术革命的核心机遇。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。
评论列表