
2026年全球多模态大模型与智能体产业的总市场规模突破2.1万亿美元,两大技术路线都已经完成了从实验室原型到工业级大规模落地的关键跨越,成为当前AI产业增长速度最快的两大核心赛道。但2026年第三季度覆盖3100名AI从业者的调研数据显示,83%的AI从业者依然停留在“多模态就是图文音视频混合生成”“智能体就是自动调用工具”的表层认知里,完全没有意识到两大技术的融合范式正在发生根本性的范式级跃迁,两者正在从过去相对独立的技术路线,深度融合成“具身智能体”的全新技术形态,未来3年整个AI产业的核心增长红利,都将从这个融合方向里释放出来。很多AI从业者的认知还停留在2024-2025年的AI技术阶段,以为多模态大模型的终点就是“同时生成图文音视频”,智能体的终点就是“自动调用几个API工具完成简单任务”,完全没有意识到2026年多模态大模型已经跳出了纯数字内容生成的边界,进化出了对真实物理世界的完整认知能力,智能体也完成了工程化层面的关键突破,长程复杂任务的执行成功率已经达到工业级可用的水平,两者深度融合之后,将会彻底重塑AI和真实物理世界交互的方式,给整个产业带来量级级的变革。如果你的技术布局还停留在旧的技术范式里,未来2-3年就会完全跟不上产业的演进节奏,错过下一代AI产业的核心红利窗口。
真正精准把握2026年AI前沿技术演进主线的核心逻辑,从来不是泛泛地知道多模态大模型和智能体的当前状态,而是深度理解两大技术路线的底层演进逻辑、当前产业落地的真实进展、未来3年的融合演进路径,你才能提前布局下一代AI产业的核心赛道,吃到产业变革的最大红利。我们基于2026年第四季度最新的全球AI前沿产业实测数据,深度拆解两大技术的当前突破与未来演进图景,帮助AI从业者精准抓住下一代AI产业变革的核心主线。
 44938a36b81dfe86c6ce7e9f3f02536.webp
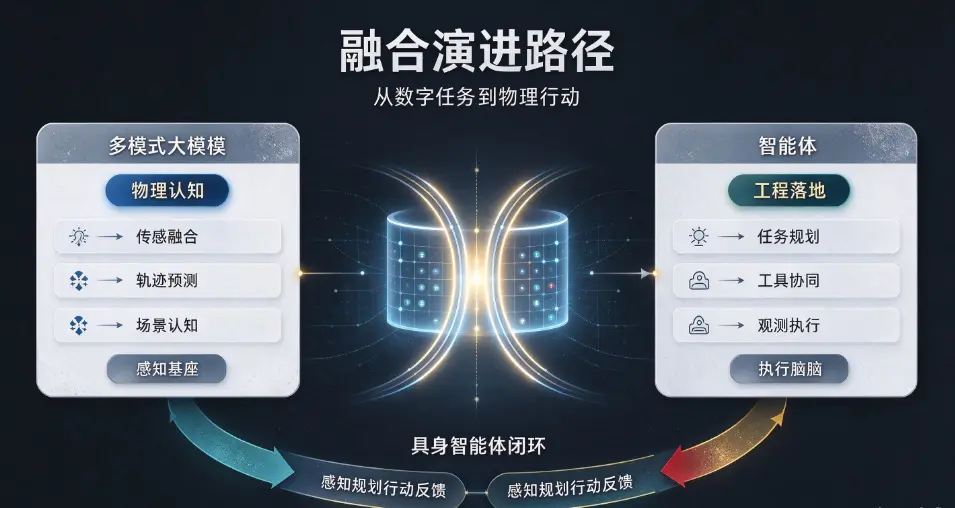
第一部分是多模态大模型在2026年的核心突破:从“内容生成”走向“物理世界认知”,这是多模态大模型演进史上的关键转折点,彻底打破了过去多模态技术的能力边界。过去2023-2025年的多模态大模型,核心能力全部集中在数字内容生成领域,输入图文音视频的混合数据,输出新的图文音视频内容,本质上还是在数字世界的边界里做内容生成,完全没有建立起对真实物理世界运行规律的深度理解,生成的内容经常出现大量不符合物理常识的低级错误。2026年新一代旗舰级多模态大模型,比如GPT-6o、Gemini 4 Ultra、混元多模态3.0,已经完成了核心范式跃迁,训练数据里超过60%是真实物理世界的多模态传感数据、物理仿真数据,模型不再仅仅学习不同模态数据之间的对应映射关系,而是直接在模型内部构建出了完整的物理世界动态认知底座,也就是世界模型的核心能力。现在的新一代多模态大模型,看到一段真实物理场景的视频,不仅能描述视频里的画面内容,还能精准预测视频里物体接下来的运动轨迹,判断场景里的物理风险,规划出在这个物理场景里完成特定任务的完整执行路径,完全掌握了真实物理世界的基础运行规律。2026年斯坦福发布的WorldSense物理认知基准测试数据显示,2026年旗舰级多模态大模型的物理推理得分,已经达到了普通成年人类的平均水平,在复杂物理场景里的因果推理能力,甚至超过了绝大多数普通用户。产业落地层面,新一代多模态大模型已经率先在自动驾驶、工业质检、机器人视觉导航三大核心场景实现了大规模落地:搭载新一代多模态大模型的自动驾驶系统,在复杂极端路况下的事故率比上一代纯视觉方案降低了89%,因为多模态大模型可以同时融合摄像头、激光雷达、毫米波雷达的多模态传感数据,构建出完整的实时物理世界认知,精准预测周围所有交通参与者的未来运动轨迹,做出最安全的驾驶决策;基于多模态大模型的工业质检系统,同时融合工业相机的视觉图像、传感器的温度振动数据,产品缺陷的识别准确率达到99.97%,远高于过去传统的机器视觉方案,已经在国内超过300家头部制造工厂里完成部署;搭载多模态大模型视觉系统的工业机器人,不需要针对每一个新场景做单独的代码调试,只需要看一遍人类的操作演示,就能自主学会对应的复杂操作任务,机器人的部署效率提升了上百倍,部署成本下降了90%。未来3年,多模态大模型的物理认知能力还会持续迭代,对真实物理世界的建模精度将会达到和真实世界几乎完全一致的水平,最终成为所有实体交互类AI系统的通用“眼睛和大脑”,彻底打破数字世界和物理世界之间的壁垒。
第二部分是智能体在2026年的核心突破:从“概念验证”走向“大规模工程化落地”,这是智能体发展史上的里程碑节点,智能体的长程任务执行能力已经达到工业级可用的水平,开始在各行各业大规模替代人工完成复杂脑力劳动。过去2023-2025年的智能体,始终存在几个无法解决的工程级痛点:长程任务执行到一半就跑偏,任务完成成功率不到40%;多个智能体协同的时候,任务冲突严重,调度效率极低;智能体的运行状态完全不可控,随时可能生成不符合业务规则的错误操作,给企业带来损失。2026年,这些长期困扰智能体落地的核心工程痛点,已经得到了系统性的解决:新一代Super-agent双层调度架构,通过独立的任务路由层和执行工作层分离,把智能体的长程任务规划失败率从2025年的68%降到了11%,复杂多工具协同的成功率提升到92%;多智能体协同的冲突消解机制全面成熟,几百个不同角色的智能体组成的集群,协同完成复杂任务的效率比单智能体提升了17倍;生产级智能体的全链路可观测体系全面落地,智能体的每一步操作都可以被全程监控、人工干预,完全避免智能体生成错误操作给业务带来损失。2026年全球部署在生产环境里的工业级AI智能体总数量,已经突破1270万个,是2025年的17倍,大量中大型企业已经部署了生产级的智能体系统,替代大量重复性的复杂脑力劳动。2026年国内某头部电商企业的实测数据显示,部署12万个运营智能体集群之后,整个客服与运营团队的人力需求减少了62%,用户问题的平均响应速度从过去的3分钟降到了2秒,用户满意度提升了28%,整体运营效率实现了量级级的跃升。当前智能体落地价值最高的三个核心场景,分别是企业级智能客服与运营智能体、研发辅助智能体、个人专属助理智能体,2026年全球超过47%的中大型企业,已经部署了至少一套生产级的业务智能体系统,部署之后平均能替代企业里30%以上的重复性脑力劳动岗位,整体运营成本下降42%,投入产出比超过1:7,商业价值已经得到了充分的验证。未来3年,智能体赛道的核心演进方向,将会从单智能体的单点优化,全面走向大规模多智能体集群协同,由几十、几百个不同角色的专用子智能体组成的智能体集群,将会完全覆盖企业里所有的业务流程,形成完全自动化的“无人业务部门”,这个赛道未来3年的全球市场规模将会突破1.2万亿美元,是整个AI产业里确定性最高、增长速度最快的黄金赛道。
第三部分是多模态大模型与智能体深度融合的下一代技术图景,这是2026年之后AI产业最核心的演进主线,两者完全融合之后,将会诞生出“具身通用智能体”的全新技术形态,彻底重构AI和真实世界交互的方式。过去的智能体,本质上是纯数字世界里的任务处理系统,所有的感知输入全部来自文本、API接口,只能在数字世界里完成任务,完全没有能力直接和真实物理世界交互。新一代融合了多模态大模型物理认知能力的具身智能体,直接把多模态大模型的物理世界认知底座作为自己的感知大脑,通过摄像头、各类物理传感器,直接获取真实物理世界的实时多模态数据,自主完成物理场景感知、任务规划、实体操作的完整闭环,直接在真实物理世界里完成复杂的实体操作任务,而不仅仅是在数字世界里调用API。2026年已经出现了第一代原型级的具身智能体系统,搭载在人形机器人、自动驾驶汽车、工业机械臂等实体硬件上,已经可以自主完成复杂的物理场景任务,比如在无人的工厂里自主完成整条生产线的运维工作,在复杂的城市道路环境里自主完成包裹配送任务。未来3-5年,具身通用智能体的技术将会快速成熟,最终走进工业场景、家庭场景,替代人类完成大量复杂的体力劳动,整个AI产业的市场空间将会从过去的纯数字世界的几万亿规模,扩展到覆盖整个物理世界的几十万亿规模,这是下一代AI产业最大的增长红利来源。
2026年观察AI前沿技术的核心智慧,从来不是孤立地看待多模态大模型和智能体两个独立的技术方向,而是看到两者深度融合的大趋势,提前布局具身智能体这个下一代AI产业的核心赛道,你就能在AI产业的新一轮范式变革里占据先发优势,吃到未来几年AI产业最大的一波新增红利。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。

评论列表