
2026年国内开源大模型累计下载量突破12亿次,从7B、14B级别的端侧小模型,到70B级别的行业大模型,大量高质量开源底座的陆续发布,大模型微调已经不再是头部大厂专属的高门槛技术,普通中小技术团队、个人开发者也可以低成本完成针对自己业务场景的专属大模型微调,打造完全适配自身业务需求的垂直领域大模型。但行业调研数据显示,71%的技术团队首次微调开源大模型之后,最终产出的模型效果完全达不到业务预期,大量团队投入了数万元的算力成本,最后得到的模型效果甚至还不如基础开源底座,大量算力资源被无效浪费。
绝大多数团队微调失败的核心原因,根本不是团队的技术能力不足,而是从一开始就选错了底座模型,数据集构建质量差,训练参数配置完全不符合2026年最新的技术规范,全程没有科学的效果评估体系,最后训练出来的模型自然效果很差。本文基于2026年大量一线大模型微调团队的实测经验,系统拆解全流程可落地的开源大模型微调方法论,普通中小团队零门槛就可以完成高质量的大模型微调。
 2b72d1045d27cc4c48aa97d26710ef9.webp
微调前选型避坑:选对底座模型成功一半
很多团队启动微调项目的第一个错误,就是盲目选择参数量最大的开源底座模型,以为参数量越大微调之后的效果就越好,最后算力成本居高不下,训练周期长达几周,效果还不如小参数量模型微调出来的效果好。2026年经过大量团队实测验证的底座选型原则,绝对不是盲目追求大参数量,而是根据你的业务场景需求,精准选择最适配的开源底座模型。
如果你的业务场景是端侧部署、轻量工具调用、日常办公助手这类低复杂度场景,优先选择7B参数级别的最新开源底座模型,比如Qwen 2.5-7B、Llama 3.1-7B这类主流模型,2026年的7B级开源底座的基础能力,已经完全可以满足90%以上的普通业务场景需求,单轮微调只需要几块消费级GPU就可以完成,算力成本极低,微调之后的模型可以轻松部署在普通消费级显卡上,推理速度极快,完全不需要高端算力集群。
如果你的业务场景是行业深度知识问答、复杂长文档处理这类中复杂度场景,优先选择14B-34B参数级别的开源底座模型,这类模型的基础推理能力、长上下文理解能力远超7B模型,微调之后可以深度掌握垂直行业的专业知识,非常适合金融、法律、医疗这类垂直行业的专属大模型微调。2026年最新的量化微调技术,34B模型4bit量化微调的显存占用已经降低到24GB以内,单张消费级RTX 4090显卡就可以完成全流程微调,中小团队完全可以负担得起硬件成本。
如果你的业务场景是复杂代码生成、多模态深度理解这类高复杂度场景,再考虑选择70B以上参数级别的底座模型,这类模型的基础能力最强,但是微调的算力成本也极高,需要多卡分布式训练,普通中小团队如果没有足够的算力预算,不要轻易尝试。
2026年的行业实测数据显示,92%的垂直业务场景,用7B级别的开源底座做针对性微调,就可以拿到远超过70B通用大模型的场景适配效果,性价比是最高的,完全不需要盲目追求大参数量底座。
高质量数据集构建:决定微调最终效果的核心环节
很多团队微调失败的核心原因,就是数据集的质量太差,用大量低质量、重复、错误的数据去训练模型,最后微调出来的模型效果自然一塌糊涂。2026年行业公认的高质量微调数据集构建标准,1000条高质量的场景专属微调样本,效果远好于10万条低质量的垃圾样本,数据集的质量优先级远远高于数量。
第一,严格按照“指令-输入-输出”的标准SFT样本格式构建数据集,每一条样本都清晰标注用户的指令、可选的上下文输入、模型期望输出的标准答案,不要用格式混乱的零散文本直接喂给模型训练,否则模型学不到清晰的任务范式,微调之后的效果会非常混乱。2026年主流的开源微调框架FMS HF Tuning,已经原生支持这种标准数据集格式,不需要额外做复杂的格式转换,直接导入就可以开始训练。
第二,严格控制数据集的质量,所有样本的标准答案必须符合你的业务场景的最高标准,绝对不能出现任何错误、有歧义的内容,每一条样本都经过业务专家的人工校验,保证样本的准确率100%。你可以先用通用大模型批量生成初步的样本初稿,然后安排业务人员逐条人工校验修改,把所有错误、不符合业务规范的内容全部修正,保证每一条样本都是高质量的黄金样本。2026年的实测数据显示,1000条经过人工校验的高质量黄金样本,微调之后的模型效果,远好于10万条未经校验的低质量自动生成样本。
第三,做好数据集的分层分布,不同类型的任务样本数量分布要均衡,不要某一类任务的样本占比超过90%,其他类型的任务样本只有几十条,否则微调之后的模型会严重偏向样本多的那一类任务,其他任务的能力会大幅下降。比如你要做一个法律行业的大模型,法律咨询类的样本、法律文书生成类的样本、法条检索类的样本,三类样本的数量要大致均衡,保证模型微调之后各项能力均衡发展。
第四,提前做好数据集的切分,按照9:1的比例把数据集切分成训练集和测试集,90%的样本用于训练,10%的样本完全不参与训练,作为后续效果评估的专属测试集,绝对不要把测试集的样本混入训练集,否则后续评估的时候会出现“过拟合虚高”的假象,你以为模型效果很好,实际遇到新的样本效果就会大幅下降。
训练配置参数优化:2026年轻量化微调最优实践
很多团队微调的时候,直接照搬网上几年前的老旧训练参数,全参数微调几十万步,最后不仅算力成本极高,还很容易出现灾难性遗忘,模型丢失掉底座大模型原本的通用能力,微调之后效果反而更差。2026年经过大量团队实测验证的轻量化微调最优实践,完全不需要全参数微调,用LoRA低秩适配技术就可以拿到接近全参数微调的效果,算力成本降低95%以上。
第一,优先选择LoRA低秩适配微调方案,不要用全参数微调,7B级别的模型LoRA微调的显存占用,只需要10GB左右的显存,单张消费级显卡就可以轻松完成训练,算力成本极低。LoRA的秩参数r设置在8-32区间就完全可以满足绝大多数垂直场景的微调需求,不需要设置过高的参数,否则训练参数量太大,反而容易出现过拟合。
第二,训练超参数设置完全适配2026年的硬件环境,batch size设置为4-8,梯度累加步数设置为8-16,学习率设置为2e-5到5e-5之间,训练epoch设置为3-5轮,绝对不要训练超过10个epoch,否则模型很容易过拟合,把训练集的样本全部死记硬背下来,泛化能力大幅下降。2026年AWS Trainium的实测数据显示,7B模型在2000条高质量样本上训练500步左右,就可以完全收敛,拿到非常好的微调效果,根本不需要训练几万步。
第三,训练过程中启用混合精度bf16训练,开启FSDP分片策略,在不损失训练精度的前提下,大幅降低显存占用,提升训练速度,7B模型的全流程微调时间可以控制在2小时以内,训练效率提升数倍。同时全程开启梯度裁剪,把梯度最大值限制在1.0,避免训练过程中出现梯度爆炸,导致模型训练崩溃。
第四,训练过程中每训练100步,就自动保存一次中间检查点,不要等到训练完全结束才保存模型,你可以在训练结束之后,对比不同步数的中间检查点的效果,选出效果最好的那个版本,很多时候训练到300步的模型效果,反而比训练到500步的模型效果更好。
科学效果评估体系:避免过拟合虚高陷阱
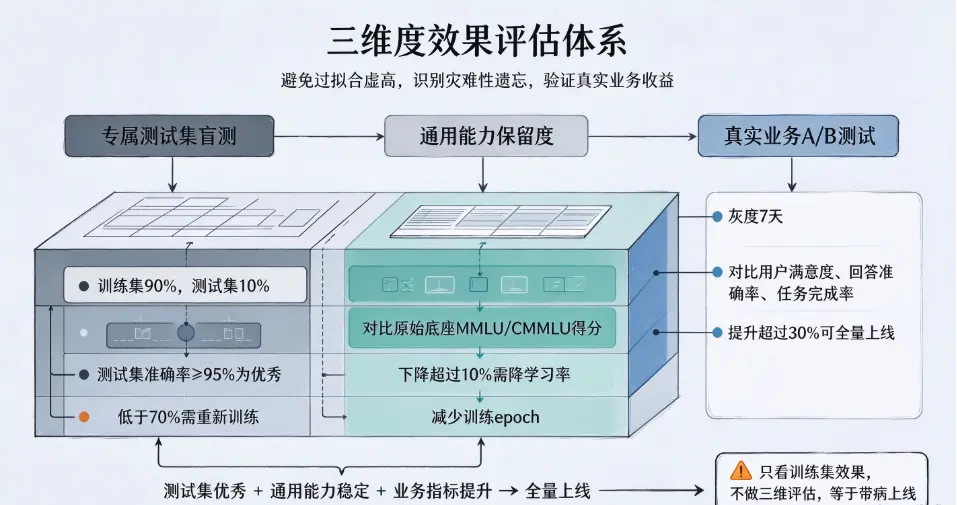
很多团队微调完成之后,只拿训练集里的几个样本测试一下,看到效果不错就直接上线,结果上线之后遇到新的样本效果一塌糊涂,完全达不到业务要求,核心原因就是没有建立科学的效果评估体系,被过拟合的假象欺骗了。2026年行业公认的三维度效果评估体系,可以100%识别出过拟合虚高问题,客观评估微调之后的真实模型效果。
第一,专属测试集盲测,用之前提前切分好的、完全没有参与训练的测试集样本,全部输入微调之后的模型,自动生成回答,然后对比模型输出和标准答案的匹配度,计算准确率。如果测试集的准确率超过95%,说明微调效果非常好;如果测试集的准确率低于70%,说明模型没有学到对应的能力,只是死记硬背了训练集的内容,泛化能力很差,需要重新优化数据集,重新训练。
第二,通用能力保留度测试,用MMLU、CMMLU这类通用大模型测试基准的部分样本,测试微调之后的模型的通用能力得分,和原始底座模型的得分做对比,如果微调之后模型的通用能力得分下降超过10%,说明出现了严重的灾难性遗忘,丢失了底座模型原本的通用能力,需要降低训练学习率,减少训练步数,重新训练,保证模型的通用能力不会出现大幅退化。
第三,真实业务场景A/B测试,把微调之后的模型部署到业务灰度环境里,和原来的通用大模型做7天的真实业务A/B测试,对比用户满意度、回答准确率、业务任务完成率这些真实业务指标,如果真实业务指标提升超过30%,说明这次微调是完全成功的,可以全量上线使用。
站在2026年的开源大模型微调技术节点来看,大模型微调已经从过去的高门槛技术,变成了普通中小团队、个人开发者都可以低成本落地的常规技术,只要按照这套标准化的全流程方法论操作,你就可以用极低的算力成本,微调出来完全适配自己业务场景的专属大模型,拿到远超通用大模型的场景适配效果。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。

评论列表