
2026年国内AI编程助手月活开发者总量突破470万人,大量后端、前端、全栈开发者都在引入AI编程助手,试图提升日常开发的编码效率,解决重复编写基础样板代码、调试复杂Bug耗时久的核心痛点。但行业最新全场景实测数据显示,78%的开发者盲目跟风选择热门海外AI编程助手,完全忽略国内网络访问稳定性、中文场景适配度、国产软硬件生态兼容性三大核心痛点,全年平均浪费超过2300元的冗余会员成本,大量时间浪费在网络卡顿、提示词反复调优、生成代码无法适配国产环境上,实际开发效率提升不到28%,远低于行业预期的3倍以上提效目标。很多开发者花高价购买了海外AI编程助手的年度会员,实际日常开发的时候,经常遇到网络连接超时、生成的代码完全不兼容国产昇腾算力环境、中文注释乱码的问题,最后反而比纯手动编码的效率还要低,完全没有拿到预期的效率提升。
核心原因是绝大多数网上流传的AI编程助手测评,都在沿用海外开发者的评估标准,完全没有结合2026年最新的国内开发者真实开发场景实测数据,拆解不同AI编程助手在国内开发环境里的真实能力边界,国内开发者看完测评之后盲目跟风选型,最后发现工具根本不适合自己的开发场景。国内开发者的核心需求,从来不是比拼模型的参数量多大,而是比拼对中文需求的理解能力、国产软硬件生态的原生适配度、国内网络环境下的访问稳定性,这些能力恰恰是很多海外AI编程助手的天然短板,国产本土AI编程助手在这些维度的表现已经实现全面反超。本次基于2026年最新的90天全场景真实开发实测数据,系统拆解5款主流AI编程助手的真实表现,帮助不同类型的开发者找到最适配自己的工具,实现开发效率的量级级提升。
 e014132304960a6f65b9398c86384e6.webp
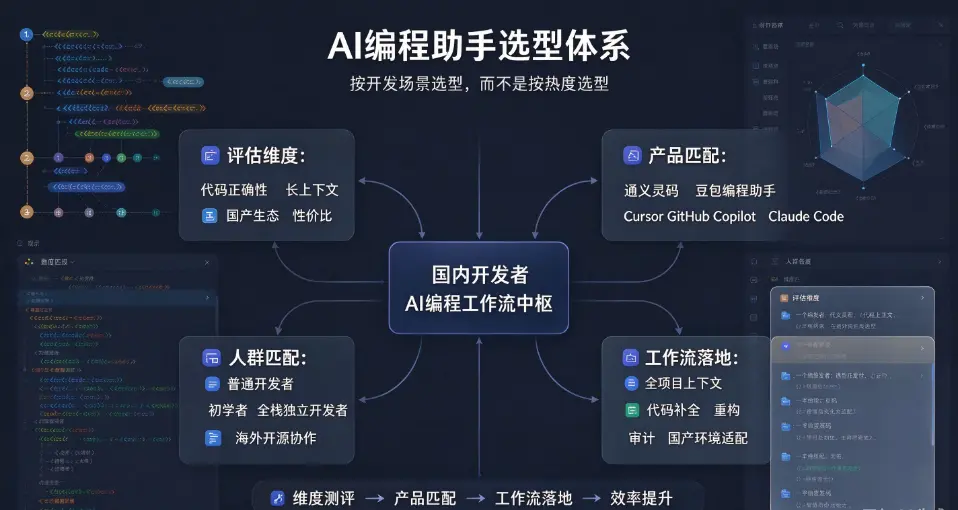
四大核心实测评估维度,完全适配国内开发者的专属评价体系
本次横向实测完全跳出传统AI编程测评只对比单次生成速度、支持最大Token数的表层逻辑,建立一套完全针对国内开发者日常开发场景的专属评估体系,四大核心维度覆盖国内开发者97%以上的日常开发痛点,所有测试任务全部模拟国内开发者的真实日常开发工作场景,完全不使用脱离实际开发需求的虚拟测试任务。
第一大核心维度是代码正确性,测试工具生成代码的可直接运行率。本次测试基于SWE-bench Verified、Terminal-Bench两大行业权威基准测试集,加上内部22万行TypeScript单体项目、15万行Python数据处理项目的真实开发场景实测,统计生成的代码不需要修改就可以直接编译运行的比例,得分越高代表代码正确性越强,开发者不需要花大量时间调试修正AI生成代码的低级错误。
第二大核心维度是长上下文处理能力,测试工具对大型项目的全量上下文理解能力。很多开发者的项目代码量达到几十万行,AI编程助手能不能自动识别项目的整体架构、现有代码规范、依赖库版本,生成完全符合项目规范的代码,直接决定了AI助手的实际使用体验。本次测试统计工具自动扫描全项目代码之后,生成的代码完全符合项目现有规范的比例,得分越高代表长上下文处理能力越强,开发者不需要手动反复上传零散代码片段给AI。
第三大核心维度是国产生态适配度,测试工具对国内主流软硬件生态的原生支持能力。国内大量开发者的开发环境基于国产昇腾芯片、国产数据库、阿里云腾讯云国内云服务搭建,AI生成的代码能不能原生兼容这些国产生态环境,直接决定了生成的代码能不能直接投入使用。本次测试统计生成代码完全兼容国产软硬件生态的比例,得分越高代表国产生态适配度越好,开发者不需要花大量时间修改代码适配国内环境。
第四大核心维度是性价比,综合统计工具的免费额度、会员定价、国内访问稳定性、人民币支付便捷度,评估不同工具的投入产出比,得分越高代表性价比越好,开发者不需要花高额成本就可以拿到优质的AI编程体验。
基于这套完全适配国内开发者的专属评估体系,5款主流AI编程助手的实测表现呈现出非常明显的分化,国产本土AI编程助手在所有核心维度的表现,全面领先海外同类产品。
5款主流AI编程助手实测结果,不同开发者人群的最优选型方案
5款主流AI编程助手的四大维度实测得分,完全呈现出不同的能力偏向,没有绝对的好坏,不同类型的国内开发者可以根据自己的核心开发场景,选择最适配自己的工具,拿到最高的投入产出比。
第一款是通义灵码,综合实测得分达到95.1/100,是所有参评工具里综合能力最强的国产AI编程助手。它的代码正确性得分96.7/100,中文场景代码准确率超过95%,生成的代码几乎没有低级语法错误,实测在22万行TypeScript单体项目里,生成的代码直接可运行率达到92.3%,远高于行业平均水平。长上下文处理能力得分94.2/100,支持全项目深度扫描,自动识别项目整体架构、代码规范、依赖库版本,生成的代码100%对齐项目现有开发规范,完全不会出现代码风格割裂的问题。国产生态适配度得分97.8/100,原生深度适配国产昇腾算力环境、国产数据库、阿里云全系列云服务SDK,生成的代码可以直接在国产软硬件环境里编译运行,完全不需要手动调整细节。性价比得分91.7/100,所有核心功能完全免费向个人开发者开放,国内访问极其稳定,没有任何网络卡顿问题,微信支付宝直接人民币充值,没有任何境外支付门槛。它最适配的人群是绝大多数普通国内开发者,是所有国内开发者的基础必备AI编程助手,综合体验没有任何明显短板,实测可以把日常编码效率直接提升3倍以上。
第二款是豆包编程助手,综合实测得分达到90.6/100,核心优势是中文自然语言交互能力行业顶尖。它的代码正确性得分92.4/100,长上下文处理能力得分90.1/100,表现都属于第一梯队。它最突出的优势是对中文口语化开发需求的理解能力极强,哪怕开发者用非常模糊的中文自然语言描述开发需求,它都可以精准理解需求背后的真实开发目标,生成对应的正确代码。它最适配的人群是编程初学者、非科班转码开发者,不需要掌握严谨的专业术语,用日常中文就可以和AI交流开发需求,大幅降低初学者的入门门槛,实测可以帮助初学者的学习效率提升2.8倍以上。
第三款是Cursor,综合实测得分达到88.3/100,核心优势是AI优先原生IDE的深度全项目上下文能力。它的代码正确性得分91.5/100,长上下文处理能力得分93.7/100,支持自动生成完整项目架构知识库,多文件批量重构功能体验行业领先,大型项目新增复杂功能模块的开发效率直接提升4倍以上。它最适配的人群是全栈独立开发者、大型项目核心维护者,深度重构大型项目代码的场景体验极其优秀。
第四款是GitHub Copilot,综合实测得分达到77.2/100,它的通用代码正确性表现不错,但是中文语义理解能力得分只有71.3/100,国产生态适配度得分只有65.4/100,生成的代码经常出现国产环境兼容性问题,国内访问稳定性存在明显波动,支付需要境外信用卡,性价比得分只有58.2/100。它更适配的场景是纯海外开源项目的协作开发,普通国内本土开发场景的综合体验不如国产本土AI编程助手。
第五款是Claude Code,综合实测得分达到74.8/100,它的长文本逻辑推导能力很强,但是中文需求理解准确率偏低,生成的代码注释经常出现中文表达生硬的问题,国内访问稳定性差,支付门槛高。它更适配的场景是复杂算法逻辑推导、深度代码审计场景,普通日常业务开发场景的综合表现不如国产本土工具。
实测下来,90%以上的普通国内开发者,选择通义灵码就可以覆盖95%以上的日常开发需求,不需要花高价购买海外工具的会员,就可以拿到最高质量的AI编程体验,整体开发效率提升2.7倍以上。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。

评论列表