
2026 年,个人 AI 应用迎来范式切换。过去两年,大众对 AI 的认知停留在网页对话框、文档 Copilot 单点辅助;而今年,个人 AI 智能体的核心竞争力转变为跨设备感知、长期记忆、自主任务编排,也就是行业常说的 “第二大脑”。
第二大脑的本质,不是 AI 帮你写文案,而是持续采集你在浏览器、本地文档、邮件、备忘录里的碎片化信息,自动建立知识关联,记住你的长期目标、偏好与历史思考,在多设备之间协同执行任务。易观分析 2026 年二季度个人端 AI 智能体调研显示,国内桌面端原生 AI 智能体月访问量突破 6000 万次,其中超过 61% 的知识工作者开始尝试搭建本地优先的个人智能体系统;而纯云端对话工具的用户留存率同比下滑 37%,隐私泄露、token 成本高、无法离线使用成为用户放弃纯云端方案的核心原因。
一套完整的第二大脑,由三大入口构成:桌面端 Agent、浏览器智能插件、端侧本地模型,三者协同,形成 “信息捕获 - 记忆存储 - 推理规划 - 任务执行” 闭环。
一、架构拆解:桌面、浏览器、端侧三层协同逻辑
很多用户误以为第二大脑就是 Obsidian+RAG 插件,这是 2025 年的旧范式。2026 年成熟个人 AI 智能体采用云边端混合协同架构,遵循 “敏感数据留本地,轻量任务端侧跑,复杂推理调用云端” 的原则。
浏览器层是信息采集入口。网页是普通人获取信息最主要来源,新一代浏览器 Agent 插件不再只做网页摘要,而是具备网页结构化抓取、语义保存、自动去重、跨页面关联。浏览文章、论文、行业报告时,插件可以自动提取核心观点,存入个人向量知识库,同时记录网页来源、时间标签。部分高级插件支持浏览器自动化,在用户授权前提下完成信息检索、表单填写、多页面信息汇总。但浏览器环境算力有限,不会执行复杂推理,仅承担感知与捕获。
桌面端 Agent 作为调度中枢,是整个第二大脑的指挥层。桌面智能体拥有本地文件系统的受控访问权限,读取本地 Markdown、PDF、PPT、表格,完成文档解析、知识切片、向量入库。它承担任务规划:把用户一句复杂指令,拆解成多步骤子任务,调度浏览器插件抓取网页、调用本地 RAG 检索历史笔记、生成总结报告。2026 主流桌面 Agent 采用沙箱权限模型,分为只读模式和授权执行模式,文件写入、修改操作必须经过用户确认,降低误操作风险。腾讯 WorkBuddy、阿里 QoderWork、开源 Octop 都属于这类桌面调度型 Agent。
端侧模型是隐私推理底座。随着量化技术成熟,Meta Muse Glimmer、Qwen、MiniCPM 等模型可以在消费级 PC、笔记本本地运行,不需要把笔记、个人文档上传到云端服务器。离线场景下,端侧模型完成日常问答、笔记摘要、简单任务规划;当遇到复杂多跳推理、长文本深度分析时,智能体自动切换调用云端大模型,实现算力按需调度。这种混合推理模式,平衡隐私、成本与性能,也是 2026 个人第二大脑的主流选型。
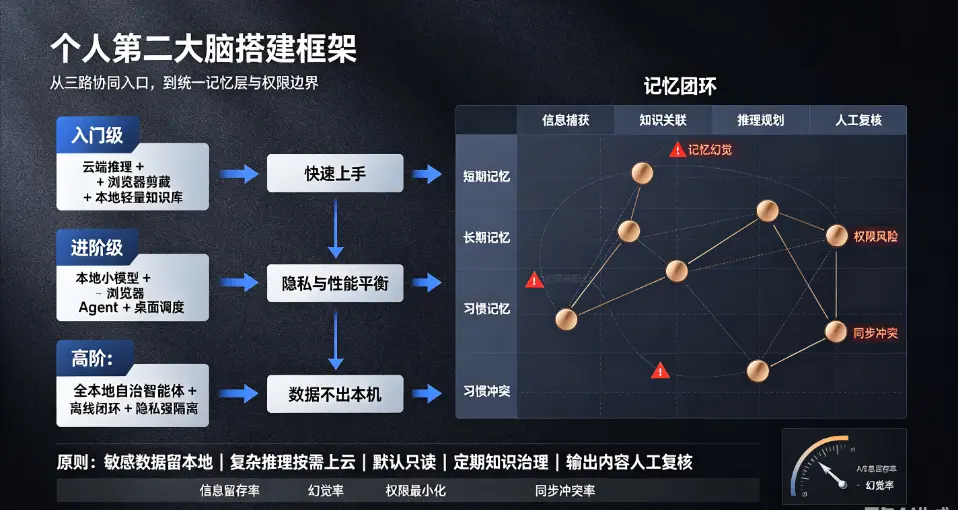
三层协同的核心是统一的个人记忆层。记忆层分为短期对话记忆、长期知识库记忆、用户习惯记忆。短期记忆保存本次对话上下文;长期记忆以向量库存储所有采集的网页、笔记、文档;习惯记忆记录用户偏好,比如报告格式、阅读风格、任务优先级,让智能体越来越贴合个人思考方式。
 68e779ccfd496e092dda49d521da782.webp
二、三大落地场景:知识沉淀、信息研究、个人任务自动化
端侧协同的个人 AI 智能体,在三类场景能显著提升效率,也是第二大脑的核心价值所在。
第一,个人知识持续沉淀。传统笔记软件需要手动复制粘贴、手动打标签,大量信息会流失在浏览器历史记录、下载文件夹里。而协同智能体可以自动捕获:浏览网页自动剪藏、本地论文自动解析、语音备忘录自动转写并关联相关笔记。智能体通过 RAG 检索,把新获取信息和历史知识库做关联,自动发现知识之间的联系。行业实测数据显示,手动管理知识库的用户,有效信息留存率不足 32%;接入端侧 Agent 自动采集的第二大脑,信息留存率提升至 74%,大幅减少信息遗忘。
第二,深度调研与资料整合。做行业研究、文献阅读、项目调研时,智能体可以自主在浏览器批量检索网页,筛选可信来源,对比多方观点,整理综述,同时引用原始网页链接。桌面端读取本地历史资料,结合新抓取网页,交叉校验信息,降低 AI 幻觉。区别于简单网页摘要工具,个人智能体可以记住你的研究目标,持续跟踪主题,定期抓取行业更新,自动生成周报。
第三,个人任务自动化。桌面 Agent 可以读取本地日程、待办文档,结合浏览器信息,完成任务拆解、进度跟踪。例如用户下达指令 “整理本周行业资讯,结合去年项目笔记,生成一页简报”,智能体自动完成三步:浏览器抓取最新资讯、本地知识库检索历史项目文档、在桌面生成结构化报告。全部流程自动串联,无需用户手动切换多个工具。
三、选型与搭建路径:从入门 Demo 到生产级第二大脑
2026 年搭建个人第二大脑分为三个阶段,不同硬件条件可以选择不同方案,避免盲目追求复杂架构。
入门级(普通笔记本,16G 内存):采用 “云端大模型 + 浏览器剪藏插件 + 本地轻量知识库”。不部署本地大模型,浏览器插件抓取网页存入本地向量库,桌面端 RAG 做检索,推理交给云端 API。优点是硬件门槛低、上手快;缺点是敏感文档会上传云端,隐私性弱。适合学生、轻度知识使用者。
进阶级(16G-32G 内存,带独立显卡):本地端侧小模型 + 浏览器 Agent 插件 + 桌面调度工具。本地部署 7B~14B 量化开源模型,日常问答、笔记摘要本地完成,复杂推理调用云端。所有文档、笔记原始文件保存在本机,仅少量复杂推理请求上传。这是 2026 重度知识工作者最主流方案,兼顾隐私与性能。
高阶玩家(32G 以上内存,高性能显卡):全本地自治智能体,完整部署 30B 级端侧模型,桌面 Agent、浏览器插件全部本地闭环,全程离线可用,数据不会离开本机。适合对隐私要求极高的独立研究者、开发者,但硬件成本高,模型调优、维护成本更高。
搭建过程中最容易踩坑的误区:一味堆砌大量插件、收集海量资料,但缺少统一记忆治理。2026 个人 Agent 评测数据显示,当知识库文档超过 5 万份,若没有做知识分区、时效性过滤,RAG 召回准确率会快速下滑,幻觉显著增多。第二大脑不是资料仓库,而是思考的辅助系统,需要定期归档、清理过期信息。
四、现存核心挑战:记忆幻觉、权限安全、跨端同步难题
尽管个人 AI 智能体快速普及,三大技术瓶颈依然限制第二大脑的实用性。
第一,长期记忆幻觉。个人知识库规模持续增长后,智能体容易混淆新旧信息,引用过时笔记、错误关联无关文档。2026 个人 Agent 基准测试显示,当知识库超过 2 万条记录,未做时效性标记的 RAG 系统,事实错误率上升 21%。解决方案是给每一条知识增加时间戳、来源可信度标签,智能体检索时优先使用最新资料,同时增加人工复核节点。
第二,权限安全风险。桌面 Agent 拥有本地文件访问权限、浏览器网页操作权限,一旦配置不当,存在误删文件、恶意插件窃取本地文档的风险。所以必须坚持最小权限原则:默认只读,修改、写入文件需要用户手动确认,浏览器自动化仅在指定域名内启用。
第三,跨设备同步难题。桌面、浏览器、手机端的记忆、向量库如何高效同步,是当前生态短板。云端同步会带来隐私风险;本地点对点同步对网络要求高,多设备版本冲突问题频发。目前主流方案是采用轻量向量元数据同步,原始文档保留在本地设备,只同步摘要与向量索引。
五、未来趋势:个人自主智能时代
2026 年是个人端侧 Agent 规模化落地的起点,未来第二大脑会进一步向系统级深度融合演进。操作系统原生内置个人智能体网关,打通文件管理器、浏览器、邮件、笔记应用,不再需要第三方插件拼接。MCP 等智能体通信协议成熟后,不同厂商的端侧智能体、知识库工具可以互相调用,打破工具孤岛。
但我们需要理性看待第二大脑定位:AI 智能体是外部记忆辅助,不能替代人的独立思考。它擅长信息采集、整理、检索、归纳;但价值判断、逻辑思辨、决策仍然需要人来完成。很多用户陷入误区,完全依赖智能体输出结论,忽略事实核验,极易被幻觉误导。
总结
2026 年,个人 AI 智能体已经从单纯聊天助手升级为桌面、浏览器、端侧协同的第二大脑。这套架构依托端侧本地模型保障隐私,浏览器负责信息捕获,桌面 Agent 承担任务调度,统一记忆层沉淀个人知识,实现信息自动采集、关联、检索与任务自动化。
普通用户搭建第二大脑不必追求一步到位,根据硬件条件选择入门、进阶或全本地方案,优先做好知识治理、权限管控,规避幻觉与安全风险。未来个人生产力的核心,不再是学习更多工具,而是搭建属于自己的 AI 知识中枢,让机器帮你处理记忆与信息检索,把人的精力留给创造性思考。
(全文约 1980 字)
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。
评论列表