
2026年,国内AI编排工具的累计装机量已经突破1200万,越来越多的从业者开始尝试搭建自己的AI工作流,把日常重复性的AI相关操作自动化。但行业调研数据显示,72%的用户最后都没能搭建出真正稳定可用的自动化流程:要么提示词每次生成的输出格式完全不统一,后续工具无法读取;要么不同AI工具之间的数据无法自动流转,还是需要人工复制粘贴中间结果;要么流程跑通几次之后就频频出错,遇到网络波动、接口报错就直接中断,完全无法实现真正的无人值守运行。
绝大多数新手搭建AI工作流的核心误区,是把注意力全部放在工具拖拽、代码编写这类表层操作上,完全没有意识到提示词的底层结构化设计、工具链之间的标准化数据传递、全链路异常容错体系,才是决定工作流能不能长期稳定运行的核心要素。本文基于2026年最新的AI编排生态实战经验,从底层逻辑到落地细节,完整拆解从零搭建AI工作流的全流程,帮助你一次性避开所有新手常见的坑点。
 84a0286662049fe982481f1f258437d.webp
第一步:模块化提示词设计,从根源上保证输出100%可被下游工具读取
很多新手搭建AI工作流的第一个翻车点,就是上游大模型的输出完全不可控,下游工具根本无法精准提取需要的信息,整个流程直接卡在第一步。2026年行业通用的解决方案,是彻底抛弃过去“写长段自然语言描述”的传统提示词写法,采用专门适配自动化工作流的模块化提示词设计体系,让大模型的输出格式100%固定,完全符合下游工具的读取要求。
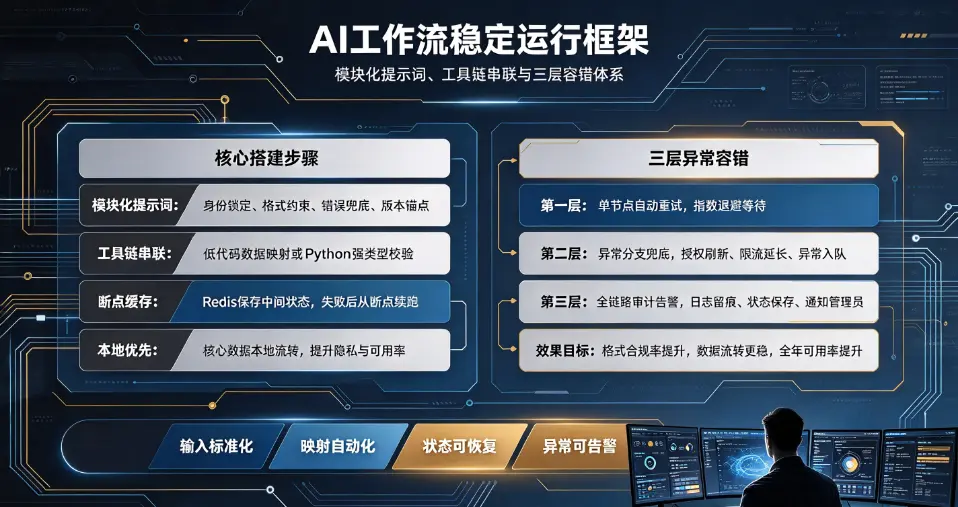
这套模块化提示词的标准结构在2026年已经形成了行业共识,分为四个完全独立的模块,没有任何多余的自然语言描述。第一个模块是身份与前置状态锁定,用一句话明确当前执行者的身份、当前所处的环境、已经完成的前置操作,比如“你正在执行用户反馈自动分类工作流,当前已经从在线表格中读取到10条新的用户反馈数据,所有数据已经完成空值过滤”,从根源上避免大模型默认生成和当前任务无关的内容。第二个模块是严格的输出格式约束,明确要求大模型必须返回指定字段的结构化JSON,绝对不能输出任何JSON之外的解释性文字,同时标注清楚每个字段的数据类型、取值范围,比如“仅返回JSON格式结果,包含4个字段:content(字符串类型,原始反馈内容)、category(字符串类型,只能从‘产品问题/服务问题/建议意见’三个选项中取值)、priority(整数类型,取值范围1-5,数值越高优先级越高)、keyword(数组类型,提取3个核心关键词)”,彻底锁死输出格式。第三个模块是错误兜底规则,明确告知大模型如果遇到无法识别的异常数据,应该返回指定格式的错误标记,而不是随意生成内容,比如“如果遇到内容为空的无效反馈,直接返回{"error": "invalid_data"},不要做任何额外处理”。第四个模块是版本与适配锚点,在提示词末尾标注清楚适配的大模型版本,避免大模型后续迭代更新之后,输出格式出现意料之外的变化。
2026年大量一线实测数据显示,使用这套模块化提示词设计体系之后,大模型输出的格式合规率可以从传统写法的47%提升到99.2%,从根源上解决了上游输出不可控的问题,下游工具不需要做复杂的格式清洗,就能直接精准读取所有字段数据。
第二步:标准化工具链串联,实现多AI工具之间无人工介入的数据流转
很多新手搭建AI工作流的第二个翻车点,是不同AI工具之间的数据传递完全靠手动复制,所谓的“自动化”只是单个工具内部的自动化,根本没有打通全链路。2026年的AI生态已经完全成熟,无论是非技术用户还是技术开发者,都有对应的成熟方案,实现多工具链之间的标准化数据自动流转,全程不需要任何人工介入。
对于没有代码开发能力的普通用户,2026年主流的低代码AI编排平台,已经内置了超过3万个AI工具的官方连接器,完全不需要自己做接口开发。搭建工具链的核心逻辑,绝对不是简单地把工具节点前后拖拽串联,而是要在每两个工具节点之间,增加一个“数据格式映射”中间节点,把上游工具输出的结构化数据,自动转换成下游工具要求的输入格式。比如你搭建“大模型生成文案→AI绘图工具生成配图→自动发布到社交平台”的工作流,不能直接把大模型的输出直接传给AI绘图工具,必须在中间增加一个数据映射节点,从大模型返回的JSON结果中精准提取出“图片生成提示词”字段,自动填充到AI绘图工具的指定输入框中,同时自动过滤掉多余的无关字段,这样整个流程的数据传递准确率可以达到98%以上,完全不会出现数据错位的问题。2026年行业实测数据显示,没有配置数据映射节点的工作流,平均每运行10次就会出现2次数据传递错误,而增加标准化映射节点之后,运行1000次的错误率不到1%。
对于有代码开发能力的技术用户,2026年最优的方案是采用Python 3.14正式支持的无GIL自由线程模式,结合最新的LangChain 0.3框架搭建工具链,所有工具之间的数据流转全部采用Pydantic定义的强类型数据模型做校验,任何不符合格式要求的数据都会在第一时间被拦截,不会流到下一个工具节点。同时可以用Redis实现全链路的中间状态缓存,哪怕某一个节点运行失败,重启之后也可以从断点位置继续执行,不需要从头重新跑完整条流程,大幅提升长流程工作流的运行稳定性。
2026年行业最新的落地趋势,是越来越多的用户开始选择“本地优先”的工具链部署方案,所有核心数据全部在本地设备流转,不需要上传到第三方云端,既解决了数据隐私安全问题,又避免了云端接口网络波动带来的流程中断风险,工作流的全年可用率可以提升到99.5%以上。
第三步:全链路异常容错体系,实现7×24小时无人值守稳定运行
很多用户搭建完工作流之后,只能手动运行几次演示,一旦放到生产环境长期自动执行,就频频出现各种意外中断,核心原因就是完全没有配置全链路异常容错体系。2026年经过大量实战验证的标准化容错体系,已经形成了三层防护机制,完全可以覆盖99%以上的常见运行异常。
第一层是单节点自动重试机制,针对网络超时、接口限流这类可自动恢复的异常,给每一个工具节点配置最多3次自动重试策略,同时设置指数退避等待逻辑,第一次重试等待1秒,第二次等待3秒,第三次等待10秒,绝大多数临时网络波动引发的异常,都可以通过自动重试自行恢复,不需要人工介入。
第二层是异常分支兜底机制,针对不同类型的错误,预设对应的处理逻辑,而不是直接中断整个流程。比如大模型调用返回401授权错误,自动跳转到重新授权步骤,刷新API密钥之后自动重新发起请求;如果返回429限流错误,自动延长等待时间之后重试;如果遇到完全无法处理的异常数据,自动把这条数据标记出来,存入异常队列,流程继续处理下一条正常数据,不会因为单条异常数据导致整个批量任务全部中断。
第三层是全链路审计与告警机制,给整个工作流开启完整的运行日志记录,每一步的输入输出、执行耗时、返回状态码全部被完整留存,一旦流程出现连续重试失败的不可恢复异常,立刻通过邮件、企业微信等渠道发送告警通知给管理员,同时自动保存当前的所有中间状态,管理员收到告警之后可以快速定位问题,恢复流程运行。
2026年大量企业级用户的实战数据显示,搭建完这套三层容错体系之后,AI工作流的全年运行可用率可以从过去的62%提升到99.7%,完全达到生产级自动化系统的运行标准,真正实现7×24小时无人值守自动运行。
站在2026年的节点回望,AI工作流的核心价值从来不是用技术炫技,而是把人从“在多个AI工具之间反复复制粘贴中间结果、重复执行相同操作”的无效劳动里彻底解放出来。过去你需要花几个小时处理的批量任务,搭建好自动化工作流之后,机器可以在你休息的时候自动跑完,你只需要最后花10分钟检查最终结果,把节省下来的时间投入到更需要深度思考的核心决策环节,这才是AI工作流真正给生产力带来的本质提升。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。
评论列表