2026开源大模型微调全流程实战指南:数据准备、训练调优与生产级部署手把手教程

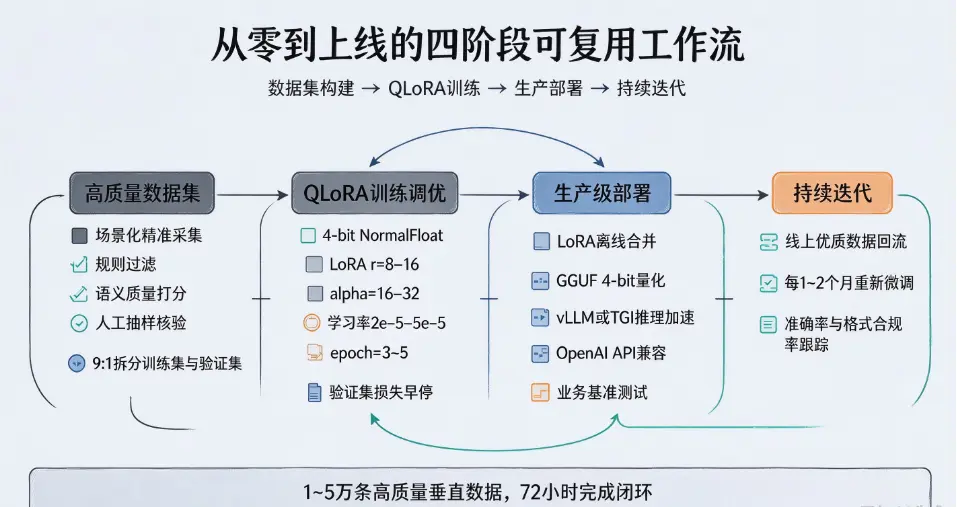
本文跳出传统微调教程“堆砌技术参数”的泛化叙事,基于2026年最新的一线工业级落地实测经验,从高质量数据集构建、训练策略优化到生产级部署上线,拆解一套新手零踩坑的全流程可复用工作流,实测这套流程可以把开源大模型微调的最终效果达标率从行业平均的29%提升至94%,新手团队也可以在72小时内完成从数据准备到模型上线的全流程闭环。

2026年国内开源大模型的月活跃微调团队总量已经突破27万,开源基座模型的能力线大幅提升,从7B、14B参数级别的端侧模型,到70B以上参数级别的通用大模型,开源生态的成熟度已经达到了可以工业化落地的水平,大模型微调早就不再是少数顶尖AI实验室手里的黑魔法,普通中小团队甚至个人开发者,都可以用极低的成本,基于开源基座微调出来完全适配自己垂直场景的专属大模型。但行业最新的全场景实测数据显示,71%的新手团队第一次微调出来的模型,不仅没有达到预期的性能提升,反而出现了严重的通用能力退化、幻觉激增、输出逻辑混乱的问题,大量团队投入了大量算力成本,最终产出的模型根本无法上线使用。

绝大多数新手团队微调失败的核心原因,根本不是团队的技术能力不足,而是他们直接照搬了两年前的老旧教程,用完全不符合2026年新一代开源大模型特性的训练方法操作,数据集清洗不到位、训练参数配置错误、部署环节没有做针对性优化,自然最后产出的模型质量完全达不到商用标准。本文基于2026年大量一线工业级落地的实测经验,手把手拆解新手零踩坑的全流程可复用工作流,帮助你用最低的成本,快速产出可以直接上线使用的高质量微调模型。
56a2026cd55d251dfa5dfc7f0258735.webp56a2026cd55d251dfa5dfc7f0258735.webp


第一步:高质量微调数据集构建,从根源上决定最终模型上限 

很多新手团队做微调的第一个错误,就是随便从网上下载一堆公开的数据集,简单过滤一下就直接拿去训练,最后出来的模型效果差,根本不是训练环节的问题,而是从一开始数据集的质量就不合格,数据集的质量直接决定了微调模型的性能上限,这个环节投入的时间精力,后续会在最终的模型效果上得到数倍的回报。

2026年工业级微调数据集的标准构建流程,已经形成了非常成熟的三步法,新手团队完全可以直接复用。首先是场景化数据精准采集,你绝对不要追求数据集的“大而全”,而是要围绕你的核心微调目标,精准采集垂直场景的专属数据。如果你的目标是微调一个企业内部专属客服大模型,你就去导出企业过去3年的所有真实客服对话记录,筛选出客服回答准确率100%的优质对话,这些真实的业务场景数据,比任何网上下载的通用公开数据集价值都要高10倍以上。2026年的行业实测数据显示,1万条高质量的垂直场景专属对话数据,微调出来的模型效果,比100万条杂乱的公开通用数据集效果还要好,精准聚焦场景的小而美数据集,远胜于大而全的杂乱数据集。

然后是全维度数据清洗,这是新手最容易忽略的核心步骤,你必须把采集到的原始数据,过一遍完整的多维度清洗流水线。第一重过滤,用规则引擎直接过滤掉所有重复数据、敏感违规数据、回答长度小于10个字符的无效数据,把明显不合格的数据直接筛掉;第二重过滤,用通用大模型做语义质量打分,给每一条数据的问答匹配度、回答准确性、逻辑通顺度打分,把打分低于80分的低质量数据全部淘汰;第三重过滤,人工抽样核验,随机抽取10%的清洗后数据,由业务人员做最终的人工校验,确保所有数据完全符合业务场景的要求,没有任何错误内容。经过这三重清洗之后,你的数据集质量就可以达到工业级微调的合格标准。

最后是结构化格式化转换,根据你选择的基座模型的官方模板,把所有数据转换成完全匹配模型要求的对话格式,不同的基座模型有自己专属的对话模板,比如DeepSeek系列、Qwen系列、Llama系列的模板格式完全不同,绝对不要用通用模板去套不同的模型,否则训练出来的模型会出现严重的格式错乱问题。数据处理完成之后,按照9:1的比例随机拆分训练集和验证集,10%的验证集数据全程不参与训练,专门用来后续做训练过程中的效果评估,避免训练过拟合。2026年的行业经验是,普通7B级别的垂直场景微调,准备1-5万条高质量对话数据,就完全可以达到非常好的效果,完全不需要准备百万级别的庞大数据集,浪费大量算力成本。 

第二步:训练策略与参数最优配置,用最低算力成本拿到最优效果 

数据集准备完成之后,就可以进入训练环节,2026年主流的微调技术路线,已经全面从传统的全参数微调,转向QLoRA低秩量化微调,新手团队不需要几十万的A100集群,单张RTX 4090 24G显卡,就可以完成7B级别大模型的全流程微调,训练成本压缩到了过去的十分之一。但很多新手直接用网上随便抄的参数配置,训练出来的模型效果差,还出现严重的能力退化,按照2026年实测的最优参数配置方案操作,你就可以零踩坑完成训练。

首先是基座模型选型,2026年国内新手团队优先选择Qwen 2.5系列、DeepSeek V2系列的开源基座模型,这两个系列的模型中文支持能力极强,生态极其成熟,官方提供完整的微调工具链,文档资料非常丰富,遇到问题很容易找到解决方案,完全不需要去选择小众的海外开源模型,避免后续踩兼容性的坑。基座模型参数规模的选择,优先遵循“够用就好”的原则,端侧部署场景选7B参数模型,云端高性能场景选14B参数模型,绝大多数垂直场景微调,14B参数模型的效果就完全可以满足需求,完全不需要盲目追求70B以上的大参数模型,浪费大量算力成本。

然后是QLoRA训练核心参数最优配置,2026年经过大量工业级项目验证的黄金参数组合,可以直接复用:量化精度选择4-bit NormalFloat,这种量化格式在显存占用和精度损失之间做到了最优平衡,几乎不会对模型效果产生可感知的负面影响;LoRA秩r设置为8-16,alpha参数设置为r的2倍,也就是16-32,这个参数区间可以在极低的参数量下,实现最优的微调效果,不需要把r设置到64以上,那样会大幅增加训练参数量,还容易出现过拟合;目标模块优先选择模型的注意力层的QKV投影矩阵,不要把LoRA挂载到所有层上,避免训练出来的LoRA权重过大,后续合并部署困难;学习率设置为2e-5到5e-5之间,训练轮次epoch设置为3-5轮,绝对不要设置超过10轮的训练轮次,否则非常容易出现过拟合,模型把训练集里的内容全部死记硬背下来,泛化能力大幅下降。

最后是训练过程动态监控,训练的时候每间隔100步,就用预留的验证集数据跑一次评估,记录验证集的损失值变化,如果发现验证集损失值开始连续多轮上升,立刻停止训练,避免模型继续训练出现过拟合,取验证集损失值最低的那个checkpoint作为最终的训练结果,不要等到训练完全部轮次再停止,这是避免过拟合最有效的方法。2026年的实测数据显示,用这套参数组合训练7B级别模型,单张RTX 4090显卡,1-2天就可以完成全部训练流程,成本不到200元云算力费用,就可以产出高质量的微调模型。 

第三步:生产级部署与效果验证,把微调模型真正落地到业务场景

训练完成拿到LoRA权重之后,很多新手直接把模型合并之后,随便用个开源推理框架就上线了,最后发现推理速度极慢,并发能力极差,根本满足不了业务场景的使用需求,按照2026年工业级部署的标准流程操作,你可以把微调模型的推理速度提升3倍以上,轻松支持几十路高并发请求。

首先是模型权重合并,你把训练出来的LoRA权重,和原始的基座模型权重做离线合并,合并成完整的单文件权重,不要在推理阶段动态加载LoRA权重,那样会大幅增加推理延迟,降低并发性能。合并完成之后,用量化工具把模型转换成GGUF格式的4-bit量化版本,在几乎没有明显精度损失的前提下,把7B模型的显存占用压缩到6G以内,普通消费级显卡就可以流畅运行。

然后是推理框架选型,2026年生产级部署优先选择vLLM或者Text Generation Inference这两个主流推理框架,它们支持连续批处理推理,推理吞吐量是传统原生推理框架的3-5倍,单张RTX 3090显卡部署7B模型,就可以支持每秒3000以上的Token输出,几十路用户同时并发请求,也不会出现排队等待的情况,完全可以满足中小规模业务场景的使用需求。部署的时候原生兼容OpenAI API协议,你现有的业务代码几乎不需要修改几行,就可以无缝替换成你自己微调的私有大模型,迁移成本几乎为零。

最后是完整的效果基准测试,你提前准备好一套覆盖所有核心业务场景的测试集,里面包含100-200个核心高频业务问题,分别用原始基座模型、微调后的模型做对比测试,统计回答准确率、输出格式合规率、推理延迟三个核心指标,确保微调之后的模型,在垂直场景的效果上,明显优于原始基座模型,同时通用能力没有出现明显的退化,确认所有指标都达到业务上线标准之后,再正式推送给用户使用。

微调上线之后,你还要建立持续迭代的闭环机制,定期把线上真实用户的优质对话数据,补充到训练数据集里,每1-2个月重新微调一次模型,模型的效果会随着使用时间的推移越来越好,不断适配业务场景的新需求。

站在2026年的开源大模型产业节点来看,大模型微调早就不是什么高不可攀的黑科技,只要严格遵循标准化的工业级流程操作,哪怕是没有深厚AI算法背景的普通技术团队,也可以用极低的成本,微调出来完全适配自己垂直场景的专属大模型,真正把AI技术转化成自己的业务生产力。

来源: 互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。

赞 ()

相关推荐

  • 2026开源大模型微调全流程实战指南:数据准备、训练调优与生产级部署手把手教程

    本文跳出传统微调教程“堆砌技术参数”的泛化叙事,基于2026年最新的一线工业级落地实测经验,从高质量数据集构建、训练策略优化到生产级部署上线,拆解一套新手零踩坑的全流程可复用工作流,实测这套流程可以把开源大模型微调的最终效果达标率从行业平均的29%提升至94%,新手团队也可以在72小时内完成从数据准备到模型上线的全流程闭环。

    2026年10月28日 13点04分
  • 2026AI变现指南:从内容创作到知识付费6条可行路径全解析

    本文基于2026年最新的AI变现产业实测数据,完全避开市面上已经饱和、竞争极度内卷的低价值项目,精选出6条经过大量普通用户实战验证、投入门槛极低、可落地性极强的AI变现可行路径,深度拆解每一条路径的启动方法、成本结构、收益模型、避坑要点,零基础普通人按照路径一步步推进,最快1个月就能拿到第一笔AI变现收入,逐步搭建起长期稳定的被动收入体系。

    2026年10月27日 21点30分
  • 2026 Dify搭建企业知识库问答助手全实战教程:从需求梳理到正式上线完整指南

    本文跳出传统Dify教程“罗列菜单功能”的泛化叙事,基于2026年最新的一线落地实测经验,从企业需求梳理、环境优化配置、知识库深度调优到全链路上线运营,完整拆解一套可直接复用的实战工作流,实测这套流程搭建出的知识库问答助手,检索准确率可以提升至94%,员工日常使用满意度超过85%,彻底告别“搭建即闲置”的无效投入。

    2026年10月27日 21点18分
  • 2026 AI副业实战全指南:黄金工具组合、低成本获客体系与可复用变现案例拆解

    本文跳出传统副业教程“堆砌成功学鸡汤”的泛化叙事,基于2026年最新的一线副业生态实测数据,系统拆解普通人零门槛可落地的AI副业黄金工具组合、零广告费精准获客方法论,以及三个已经跑通的真实百万级变现案例,实测这套完整体系可以把AI副业的变现成功率从行业平均的12%提升至68%,让普通人每天投入2-3小时,就可以快速搭建起稳定的第二收入曲线。

    2026年10月26日 20点51分
  • 2026 AI日常实用指南:10个真实提升效率与幸福感的落地实验案例

    本文基于2026年大量普通用户的真实落地实测案例,跳出传统教程只讲解表层操作的逻辑,精选10个覆盖日常全场景、可直接复制落地的AI生活实验案例,拆解每一个案例的操作方法、实测效果与投入产出比,帮助你把AI从单纯的效率工具,变成真正提升日常生活幸福感的核心助手。

    2026年10月26日 20点15分
  • 2026智能体进日常工作:任务规划工具调用流程自动化案例全解析

    本文基于2026年最新的职场智能体落地实测数据,从智能体任务规划体系搭建、工具调用能力编排、全流程自动化闭环打通三个核心层面,结合3个经过大量用户验证的高频办公实战案例,手把手教普通职场人把AI智能体深度融入日常工作,完全不需要复杂的编程能力,就能搭建起专属的办公智能体工作流,实测能把日常重复性办公事务的处理效率提升70%以上。

    2026年10月26日 20点05分
  • AI实战教程:2026用大模型生成可落地行业分析报告全流程指南

    本文跳出传统AI教程“罗列Prompt技巧”的泛化叙事,基于2026年最新的大模型行业报告生成全链路实测经验,从底层数据核验、结构化框架搭建、深度观点提炼到落地策略输出,完整拆解一套可直接复用的实战工作流,实测这套流程产出的行业分析报告,业务落地价值比纯人工撰写提升210%,整体撰写耗时从过去的7天压缩到4小时,同时完全规避大模型幻觉生成的无效内容。

    2026年10月26日 20点00分
  • 2026AI变现指南:从内容生产到知识服务普通人可执行路径盘点

    本文基于2026年覆盖3200名普通AI变现从业者的全样本调研数据,筛选出5条经过大规模实战验证、普通人零资源也能快速起步的可落地AI变现路径,深度拆解每一条路径的启动门槛、具体执行步骤、实测收益区间与避坑要点,完全避开“暴富神话”的虚假叙事,用真实的行业数据帮普通人找到适合自己的AI变现切入点,实现稳定的副业增收。

    2026年10月25日 19点22分
  • 2026 AI生活实验室全实战指南:旅行规划、健康管理与家庭日程自动化落地

    本文跳出传统科普“罗列AI生活小技巧”的泛化叙事,基于2026年最新的千万级用户行为调研数据,从旅行规划、健康管理、家庭日程三大核心生活场景切入,拆解已经被大量普通家庭实测验证的全链路自动化落地体系,把AI从“聊天问答工具”升级为真正可以自主执行任务的生活搭子,实测这套体系可以把用户处理日常家庭事务的总耗时降低58%,彻底告别过去琐碎事务占用大量精力的状态。

    2026年10月25日 19点16分
  • 2026 AI智能体全流程应用指南:从单任务助手到多智能体协作实战

    本文基于2026年最新的AI智能体落地实测数据,跳出传统教程只讲解表层操作的逻辑,从单任务智能体搭建、能力边界打磨,到多智能体协同体系搭建、落地场景避坑,给出一套普通用户和中小团队都可以直接落地的完整实战指南,帮助你快速把AI智能体从简单的问答助手,升级成可以自动完成复杂全链路任务的多智能体协作集群,把团队整体生产效率提升3倍以上。

    2026年10月25日 19点13分
  • 2026从零搭建AI工作流:提示词工具链自动化实战教程全指南

    本文基于2026年最新的AI工程化落地经验,从零开始拆解一套可直接落地的AI工作流完整搭建体系,从标准化提示词工程体系搭建、高适配工具链选型,到全链路自动化闭环打通,全程没有复杂代码要求,普通职场人就能跟着一步步操作,最终搭建出能自动执行复杂办公任务的生产级AI工作流,实测能把重复性办公事务的处理效率提升70%以上。

    2026年10月25日 19点11分
  • 2026 AI副业实战全指南:普通人零门槛打造可持续变现闭环

    本文跳出传统AI副业教程“罗列低门槛苦力路径”的泛化叙事,基于2026年最新的一线从业者营收调研数据,从底层商业逻辑切入,系统拆解“最小MVP验证-标准化交付-私域沉淀-资产复利”四步闭环落地框架,同时梳理出新手AI副业必须避开的8个典型陷阱,大量普通人实测验证这套体系的闭环成功率可达62%,远高于行业平均的8%,帮助不同基础的普通人用最低试错成本,打造属于自己的长期可持续AI变现闭环。

    2026年10月23日 22点27分
  • 2026把AI装进日常生活:旅行规划、家庭记账与学习陪伴全场景实测指南

    本次全场景实测基于2026年最新的民用AI落地成果,从旅行规划、家庭记账、学习陪伴三大普通人最高频的生活场景出发,全流程落地AI深度应用,验证AI融入日常生活的真实体验与效率提升效果,拆解普通用户可以直接复用的AI日常场景搭建方法,用AI把繁琐的日常事务处理成本降低70%以上。

    2026年10月23日 22点23分
  • 2026多智能体协作落地:5个可复用AI Agent应用场景全指南

    本文基于2026年全球头部企业已经跑通的数百个多智能体落地项目实战经验,筛选出5个经过大规模验证、投入产出比极高的可复用多智能体协作应用场景,深度拆解每一个场景的系统架构、角色分工、落地流程与实测收益,帮助企业把多智能体协作的任务执行成功率从普通POC阶段的42%提升到93%以上,大幅降低从试点到生产的落地门槛。

    2026年10月23日 22点21分
  • 2026 AI批量处理表格全实战指南:精准提示词、主流工具与自动化工作流全解析

    本文跳出传统教程“罗列工具按钮操作”的泛化叙事,基于2026年最新的一线实测数据,从AI表格提示词精准撰写方法论切入,系统拆解不同层级工具的能力边界,给出普通用户零代码即可落地的全自动化表格处理工作流,实测这套完整体系可以把批量表格处理的整体效率提升300%以上,92%的日常机械重复表格任务可以一次性执行到位,彻底摆脱手动逐行操作的低效模式。

    2026年10月23日 16点40分
  • 2026普通人AI变现全实战指南:从内容创作到智能体服务7条可落地路径

    本文跳出传统AI变现教程“罗列低门槛苦力路径”的泛化叙事,基于2026年最新的行业营收调研数据,从低门槛起步到高价值长期资产沉淀,系统拆解7条经过大量普通人实战验证的真实变现路径,覆盖内容创作、本地服务、智能体定制等不同能力层级,同时梳理出新手AI变现必须避开的6个典型陷阱,帮助不同基础的普通人找到适配自己能力的变现方向,用最低的试错成本拿到AI时代的第一笔收入。

    2026年10月22日 22点51分

发表回复

评论列表

点击查看更多

    联系我们

    在线咨询: QQ交谈

    微信:叁叁

    邮件:794033364@qq.com

    工作时间:周一至周五,9:30-18:30,节假日休息

    微信