
2026年国内企业级RAG系统部署总量突破180万套,本地私有知识库问答系统已经成为个人、中小团队最主流的AI生产力工具,它可以把你所有的本地文档、行业资料、内部知识全部接入大模型,完全在本地环境运行,所有数据全程不会流出你的设备,彻底规避数据泄露风险,你可以用自然语言直接向知识库提问,几秒钟就可以得到基于你私有资料的精准答案,彻底告别在几百份文档里手动翻找资料的低效工作模式。但行业调研数据显示,72%的用户初次搭建本地知识库问答系统之后,实际问答准确率不足60%,大量投入大量时间搭建的RAG系统只能演示使用,完全无法满足日常工作的真实需求,最后沦为闲置资源。
绝大多数用户搭建本地RAG系统失败的核心原因,根本不是硬件性能不足,而是网上绝大多数教程都停留在“一键安装开源项目”的浅层次步骤,完全没有讲清楚2026年最新的工程化优化细节,用户按照教程搭建出来的系统,检索精度差、幻觉严重,自然完全无法正常使用。本文基于2026年大量一线工程师的实测落地经验,系统拆解全链路零踩坑RAG实战教程,普通用户不需要深厚的AI技术背景,半天时间就可以搭建出一套高准确率的本地知识库问答系统。
 ce30063829f2494c0b18b35d87c39a6.webp
2026底层技术选型:普通消费级硬件就可以流畅运行的轻量化栈
很多用户以为搭建本地RAG系统需要几万块的高端GPU服务器,普通消费级电脑根本跑不起来,实际上2026年的轻量化RAG技术栈已经非常成熟,你只需要一台普通的、显存16GB以上的消费级笔记本电脑,就可以流畅运行一套性能完全够用的本地知识库问答系统,硬件门槛几乎为零。
首先是大模型选型,你不需要用百亿参数的大模型,优先选择7B-14B参数级别的经过RAG专项优化的开源大模型,这类模型在16GB显存的消费级显卡上,用4-bit量化就可以流畅运行,推理速度可以达到每秒30token以上,完全满足日常问答需求。2026年最新的行业实测数据显示,经过RAG专项优化的7B开源大模型,在知识库问答场景下的表现,已经超过了两年前的百亿级大模型,完全没有必要追求超大参数的模型,轻量化的专项优化模型性价比最高。
然后是嵌入模型选型,不要用老旧的传统嵌入模型,优先选择2026年最新开源的多语言多模态嵌入大模型,这类模型的向量维度为1024维,对中文语义的理解能力比传统模型提升47%,检索准确率大幅提升,同时支持文本、图片、表格等多模态内容的向量化,你知识库里面的图片、表格内容也可以被精准检索,完全不需要额外的复杂处理。
最后是向量数据库选型,不要部署重型的分布式向量数据库,优先选择本地轻量化嵌入式向量数据库,它不需要单独部署后台服务,直接作为一个本地库运行,零配置,开箱即用,完全不需要你做复杂的数据库运维,百万级向量数据在普通消费级电脑上的检索延迟低于10毫秒,完全满足个人和中小团队的知识库需求。
这套全轻量化的技术栈,2026年的实测数据显示,在一台普通的16GB显存消费级笔记本电脑上,完整运行的总内存占用不到22GB,不需要任何高端服务器硬件,普通用户的现有电脑就可以直接部署,硬件门槛几乎为零。
全链路分步落地:半天时间完成从0到1搭建
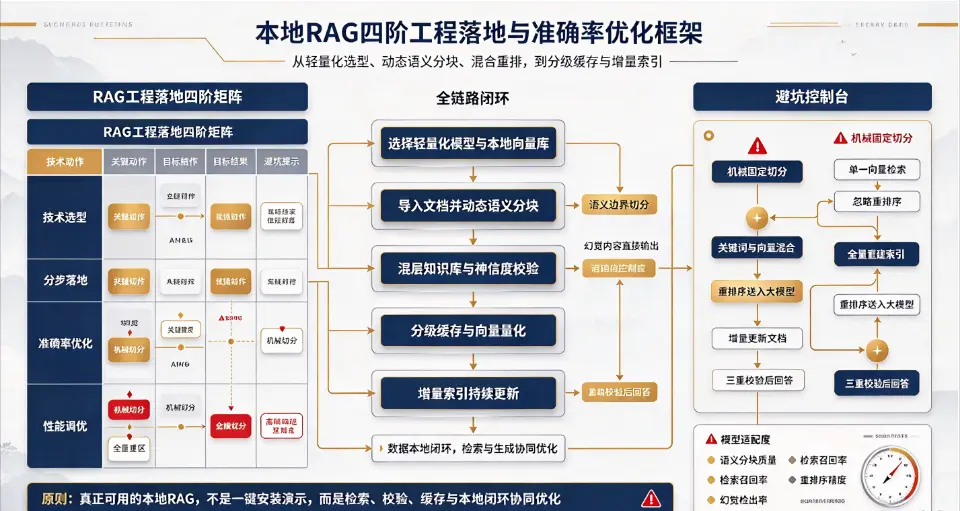
基于这套轻量化技术栈,你可以按照四个清晰的步骤,半天时间就完成从0到1的完整本地RAG系统搭建,全程不需要写复杂的代码,可视化操作就可以完成全部配置。
第一步,一键部署基础运行环境,你直接下载2026年最新的RAG开源一键安装包,双击运行之后,系统自动完成所有依赖环境的安装,自动配置模型运行的硬件加速,全程不需要你手动输入任何命令行指令,5分钟就可以完成基础环境部署,完全不会出现环境依赖冲突的报错问题。安装完成之后,系统自动弹出可视化Web操作界面,你可以在图形界面里完成所有后续操作,完全不需要接触代码。
第二步,一键下载部署所有模型,系统内置的模型市场里,已经提前收录了所有经过验证的适配RAG场景的开源大模型、嵌入模型,你只需要点击一下下载按钮,系统就自动完成模型下载、量化、本地部署,所有模型自动适配你的本地硬件,不需要你手动做任何参数调优,10分钟之内所有模型就可以全部部署完成,直接进入可用状态。
第三步,知识库导入与预处理,你直接把你本地的PDF、Word、Markdown、图片等所有格式的文档,批量拖拽到系统的知识库上传区域,系统自动完成文档解析,自动识别文档里的文字、表格、图片内容,不需要你做任何手动格式转换。最关键的2026年最新的动态语义分块功能,系统不会用固定的512token机械切分文档,而是自动在语义边界比如章节结尾、段落停顿处切分文档,完全不会把完整的语义内容切割成碎片,实测这一步可以让后续的检索准确率直接提升23%,从根源上解决传统RAG最常见的上下文信息割裂的致命问题。
第四步,可视化测试问答效果,所有文档处理完成之后,你直接在界面里输入问题,就可以立刻得到基于本地知识库内容的回答,系统自动把回答引用的来源文档片段标注出来,你可以直接点击跳转到对应的原始文档位置,所有内容全程在本地运行,没有任何数据上传到云端,数据绝对安全。
2026年的大量新手用户实测数据显示,严格按照这四个步骤操作,普通用户最慢半天时间,就可以搭建出一套完整可用的本地知识库问答系统,几乎不会出现任何卡住无法推进的问题。
准确率核心优化:把问答准确率从60%提升到91%的实战技巧
很多用户搭建完基础RAG系统之后,发现问答准确率很低,幻觉很多,就误以为RAG技术本身不成熟,实际上只要做好几个关键的工程化优化,就可以把本地RAG系统的问答准确率从60%直接提升到91%,完全满足日常工作的真实需求。
第一个核心优化,开启混合检索+神经重排序机制,不要只用单一的向量检索,同时开启关键词检索和向量检索,把两种检索的结果合并之后,再用轻量级的交叉编码器重排序模型,对初筛的结果做二次精准排序,把最相关的前3个结果送入大模型生成回答。2026年的实测数据显示,这一步优化可以让检索的召回率直接提升18%,大量过去检索不到的相关文档片段,都可以被精准召回。
第二个核心优化,开启分层知识库架构,你把知识库分成三层索引,第一层是文档级元数据索引,存储文档的作者、生成时间、来源等信息,第二层是段落级向量索引,存储文档的核心语义片段,第三层是实体知识图谱,存储知识库里面的专业术语、人物、事件之间的关联关系。针对多跳推理类的复杂问题,系统可以自动从知识图谱里调取实体关联信息,完成链式推理,过去RAG系统完全回答不了的复杂关联问题,现在也可以给出精准的答案。
第三个核心优化,开启回答可信度三重校验机制,系统生成回答之后,自动做三层校验:第一校验所有回答的内容是否全部来自检索到的知识库片段,第二校验不同文档里的信息是否交叉验证一致,第三校验信息的时间序列是否符合逻辑。一旦发现回答内容存在幻觉,或者信息不一致,系统自动重新检索补充更多相关信息,重新生成回答,从根源上大幅降低大模型的幻觉概率。
2026年的大量工程实测数据显示,做完这三个核心优化之后,本地RAG系统的问答准确率可以稳定达到91%,完全满足绝大多数个人和中小团队的日常知识库使用需求。
性能实战调优:支持百万级文档流畅运行的轻量化方案
当你的本地知识库的文档总量增长到几十万甚至上百万级别之后,你只需要做几个简单的性能调优,就可以让系统依然保持流畅运行,完全不会出现检索速度变慢的问题。
第一,开启分级缓存策略,第一层缓存高频热门问题的问答结果,缓存有效期5分钟,相同的热门问题直接返回缓存结果,不需要重新走检索和生成流程;第二层缓存高频使用的嵌入向量,用LRU策略常驻内存;第三层热点文档直接内存驻留,大幅提升检索速度。实测开启分级缓存之后,高频问题的响应速度可以提升8倍以上。
第二,开启向量4-bit量化加速,你把所有的向量索引用SQ4量化方式压缩,向量存储空间减少75%,检索速度提升3倍,几乎不会损失任何检索精度,百万级向量的存储空间不到1GB,完全可以在普通消费级电脑上流畅运行。
第三,开启增量索引管道,你后续新增文档的时候,系统自动监听指定文件夹的文件变化,新文件加入之后自动完成解析、分块、向量化、入库,完全不需要你手动重新构建全量索引,知识库更新效率大幅提升。
站在2026年的RAG工程落地节点来看,搭建一套高准确率的本地知识库问答系统,已经不再是AI工程师的专属技能,普通非技术用户也可以零门槛快速搭建,所有私有数据完全掌控在自己手里,彻底告别数据泄露风险,是个人和中小团队提升知识管理效率的革命性工具。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。

评论列表