
引言
过去数年大模型竞争,焦点集中在基座模型训练、参数规模、榜单跑分。进入 2026 年,行业范式发生根本性切换:训练成本占比持续下降,推理成本成为 AI 业务长期支出主体;同时端侧芯片 NPU 算力快速提升,让大模型不再只能运行在云端机房,手机、PC、嵌入式设备都可以离线承载轻量化大模型。整个产业正在完成一次迁移:从一次性训练巨型模型,转向在推理阶段动态调度算力、按需激活参数,最终将智能下沉至终端设备。
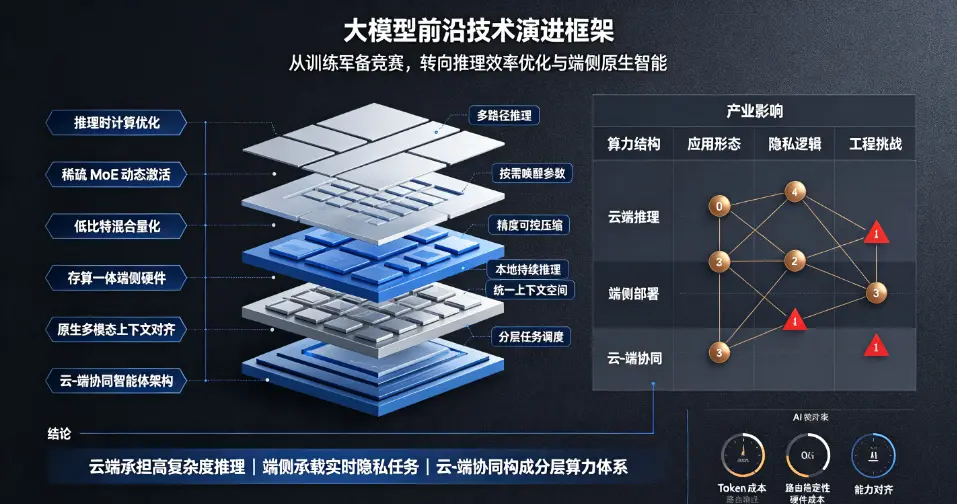
推理时计算(Inference-time Computation),区别于训练阶段的权重学习,是模型在接收用户请求之后,动态执行搜索、自我反思、多路径采样、路径择优等计算,在不扩大模型参数量的前提下提升复杂问题推理能力。而端侧智能,则是把模型推理、记忆、规划能力部署在本地硬件,降低网络延迟,保护用户隐私。二者相辅相成,共同构成 2026 大模型技术迭代主线。综合全球实验室 2026 年公开论文与厂商实测报告,本文归纳六大核心技术突破,逐一解析技术原理、实测效果,并评估对整个 AI 产业的连锁影响。
 17e79bda090d02f2cf41f6e18ddc56c.webp
一、推理时计算优化:不增加模型参数,提升复杂任务推理能力
推理时计算是 2026 年大模型算法领域最重要的范式创新。传统大模型生成属于单次自回归解码,模型权重固定,收到输入后直接输出答案;而推理时计算,是在推理阶段引入多路径采样、蒙特卡洛树搜索、分步自我校验、过程奖励模型,让模型在生成答案的过程中自主尝试多条推理路径,筛选最优结果,对数学、代码、逻辑推理类任务提升显著。
2026 年多家实验室实测数据显示,引入推理时计算框架后,同一基座模型在 MATH、GSM8K 复杂数学数据集上准确率提升 22%~37%,无需重新训练基座权重。这项技术的核心优势,是复用现有大模型基座,不需要投入巨额算力重新训练,大幅降低能力升级成本。但短板同样突出:推理时多路径探索会成倍增加 Token 消耗,简单问答场景下使用该技术会造成算力浪费。因此行业主流做法是任务分级调度,简单查询采用普通解码,复杂逻辑任务才启用推理时计算。
这项技术改变了行业认知:大模型能力天花板不再完全由模型参数量与训练数据决定,推理阶段的计算策略同样可以大幅提升模型表现,产业投入重心开始从训练算力向推理调度系统倾斜。
二、稀疏 MoE 动态激活架构:按需唤醒参数,降低推理算力开销
稀疏 MoE 混合专家模型在 2026 年走向成熟落地,是平衡模型能力与推理成本的核心架构。传统稠密模型每一次推理都要激活全部参数;MoE 模型将模型切分为多个专家子模块,推理时仅根据输入内容激活少量专家,其余参数保持休眠。2026 年新一代 MoE 架构进一步优化路由算法,减少路由错误带来的性能损耗,专家负载均衡能力显著提升。
以 2026 年发布的新一代 MoE 模型为例,总参数量达到 124B,但单次推理仅激活 5.5B 参数,推理成本相比同等能力稠密模型降低 60% 左右。该架构同时适配云端大规模推理集群与端侧 MoE 轻量化部署,旗舰手机端已经可以运行 30B 级别的端侧 MoE 模型,按需加载专家权重。
MoE 架构带来产业层面的变化:厂商不再盲目追求稠密大模型参数竞赛,模型设计转向 “总容量大、单次激活小” 的稀疏架构,算力资源利用效率得到显著改善。但 MoE 架构对调度系统、内存带宽要求更高,路由逻辑缺陷会造成负载倾斜,仍是工程落地的主要难点。
三、低比特混合量化技术:在精度可控前提下压缩模型体积
量化是大模型端侧部署的基础技术,2026 年行业已经从统一 INT4 量化,升级为混合精度量化,对模型不同层、不同权重采用差异化比特压缩。注意力层采用较高精度,FFN 前馈网络采用更低比特,在控制精度损失的同时最大限度压缩模型存储空间,降低内存读取开销。
实测数据表明,采用混合量化方案的 7B 模型,可压缩至 3.5GB 内存占用,在手机 NPU 上运行,基础任务精度损耗控制在 5% 以内,长文本理解、多模态任务表现远优于传统统一量化方案。部分前沿研究落地三值化(TERNARY)量化,权重仅使用 - 1、0、1 三种数值,存储密度进一步提升,适配嵌入式低功耗硬件。
混合量化打通了大模型下沉终端的技术门槛。过去端侧硬件内存不足是最大瓶颈,现在通过量化压缩,3B、7B 基座模型成为手机、PC 端标配。但量化存在边界,高难度推理任务对权重精度敏感,过度压缩会造成模型幻觉增多,因此量化方案需要根据场景权衡取舍。
四、存算一体端侧硬件:缓解内存带宽瓶颈,支撑本地持续推理
传统 GPU、NPU 架构,计算单元和存储单元分离,大量算力消耗在数据搬运,也就是 “访存墙” 问题。存算一体芯片将计算单元嵌入存储介质内部,减少权重数据在内存与计算单元之间反复传输,大幅降低推理时延与功耗,是 2026 端侧硬件的重大突破。
2026 年国内高校与芯片企业发布 ROM 存算一体原型芯片,7nm 工艺下,可完整容纳 2bit 量化的 8B 大模型,推理速度最高可达 20000 token/s,同等任务功耗相比传统 NPU 下降超过 40%。这类芯片面向手机、IoT 设备、车载终端,解决端侧持续多轮 Agent 推理带来的功耗过高问题。
存算一体硬件的产业化影响深远:它补齐端侧 AI 硬件短板,让持续运行的本地智能体成为现实。但现阶段存算一体芯片仍存在制造良率、精度误差等工程难题,短期内不会全面替代通用 NPU,更多用于 AI 专用加速场景。
五、原生多模态上下文对齐:文本、图像、音视频统一表征
2026 年的多模态模型告别早期 “文本基座外挂视觉编码器” 的拼接方案,转向原生多模态架构,图像、音频、视频、文本使用统一上下文空间编码,时序信息、空间信息可以直接参与模型推理,实现跨模态深度理解。
新一代原生多模态模型支持百万级长度多模态上下文,可一次性读取数十张图片、长视频片段、文档图文混合内容。在工业质检、本地视频摘要、手机屏幕理解、医疗影像解读场景落地效果突出。手机端侧原生多模态模型可以直接读取屏幕画面,结合用户语音指令完成任务,不需要上传图片到云端。
隐私价值是这项技术的一大亮点:多模态数据全部本地处理,图片、视频原始数据无需上传云端,规避数据泄露风险。挑战在于,多模态向量计算会显著增加端侧内存开销,对终端硬件的存储与算力提出更高要求。
六、云 - 端协同智能体架构:云端负责复杂规划,端侧承担感知与隐私计算
云端协同智能体是 2026 年应用层的核心突破,它不再简单区分 “云端 AI” 和 “端侧 AI”,而是建立分层任务调度框架。端侧模型负责实时感知、本地文件处理、隐私数据运算、简单任务执行;云端大模型负责复杂任务拆解、深度逻辑推理、跨领域工具调用。两端之间传递指令摘要,而非原始用户数据,兼顾能力与隐私。
在手机端 AI 助手场景中,端侧模型实时读取屏幕、语音、本地文件,完成信息预处理,只有高复杂度任务才向云端发起请求,原始隐私信息保留在本地。实测数据显示,云端协同架构下约 70% 的日常用户请求,可以直接在端侧完成,无需调用云端 API,大幅降低云端推理成本,交互延迟明显缩短。
这套架构重塑 AI 产品开发逻辑。应用开发者不再二选一,而是基于任务复杂度做算力分层。同时带来新的工程难题:两端模型能力对齐、任务状态同步、网络中断时的端侧独立兜底机制,都需要复杂框架支撑。
产业综合影响与未来挑战
六大技术组合在一起,正在重塑整个 AI 产业的价值链条。第一,算力需求结构变化,云端算力更多用于复杂推理时计算与大型 MoE 模型,端侧芯片市场迎来爆发,手机、PC、车载、嵌入式芯片全部加入 AI NPU 算力竞赛。第二,AI 应用形态发生改变,AI 从联网网页工具,变成嵌入操作系统、硬件原生的本地智能助手,离线可用成为产品核心卖点。第三,数据隐私逻辑重构,大量个人数据不再上传云端,端侧本地计算成为隐私合规的重要方案。
同时产业依然面临多重约束。推理时计算带来 Token 成本上涨;MoE 模型路由稳定性有待提升;存算一体芯片量产成本偏高;端侧模型能力上限低于云端基座;云端协同架构增加软件研发复杂度。端侧智能不是取代云端,而是构建分层算力体系。
从长期趋势看,2026 年这次技术变革,标志大模型从纯云端中心化服务,走向云、端协同分布式智能。推理时计算挖掘现有模型潜力,端侧硬件与模型压缩技术降低智能落地门槛。未来 AI 的竞争,不再只比拼模型参数,而是推理调度能力、硬件适配效率、云端协同架构、隐私安全能力的综合竞争。
结语
从推理时计算到端侧智能,2026 年大模型六大技术突破,共同完成 AI 产业的一次重心迁移:从训练军备竞赛,转向推理效率优化与终端场景落地。推理时计算在算法层面挖掘模型推理潜力,稀疏架构、量化技术、存算一体硬件降低算力与存储成本,原生多模态与云端协同架构拓展应用边界。
技术演进的底层逻辑,是让智能计算更贴近数据产生的地方。云端承担高复杂度推理任务,端侧承载实时、隐私敏感的本地任务。这套新范式会持续渗透消费电子、工业设备、车载终端等场景,但同时,算力调度、模型精度、硬件成本、安全治理等问题,依然需要行业持续解决。未来大模型产业的创新主战场,将落在推理优化与端侧原生智能之上。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。
评论列表