
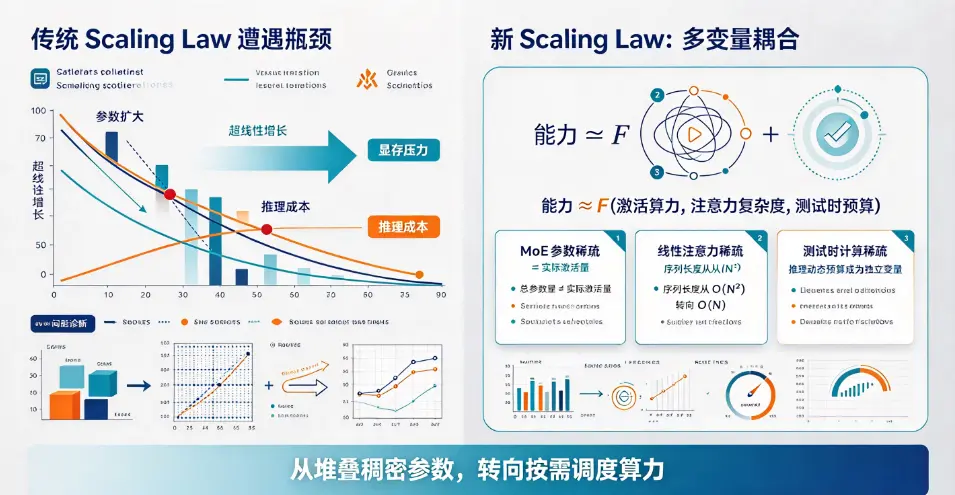
2026 年,稠密 Transformer 的经典 Scaling Law 红利逐步耗尽。在经典 Chinchilla 缩放框架中,模型性能随参数量、训练 token、算力呈平滑幂律提升,但持续扩容带来的显存、通信、推理成本呈超线性增长。单纯堆叠稠密参数已经无法持续获得收益,行业重心转向稀疏化:只在需要时才触发计算,这标志着后 Transformer 时代正式开启。MoE、线性注意力、测试时计算,成为重构 Scaling Law 的三条核心赛道。
MoE 混合专家是稀疏化赛道最成熟的方案。它将模型拆分为大量专家子网络,每个 token 仅路由至少数专家参与计算,总参数量可以做到极大,但单次推理激活参数维持在较低水平。2026 年新一代 MoE 模型进一步优化路由算法,降低负载不均衡的固有缺陷,部分超稀疏 MoE 模型总参数量达到 600B 至 800B,但单 token 激活参数仅 27B\30B,激活率压缩至 3%\4% 区间。传统 Scaling Law 统计总参数量评估模型能力,这套指标在 MoE 体系下完全失真。同等总参数量下,不同激活率、路由策略的 MoE 模型能力差异巨大,新的缩放关系必须把激活参数量、专家负载、通信开销纳入变量。MoE 的短板同样明显:专家路由带来的 GPU 跨卡通信延迟,长尾任务路由失效,这些开销会抵消稀疏带来的推理收益,也是 2026 年 MoE 工程优化重点。
线性注意力则从注意力机制底层打破自注意力 O (N²) 的复杂度瓶颈。原生 Transformer 的注意力需要计算所有 token 两两之间关联,序列变长后算力爆炸。线性注意力放弃精确的 token 间配对,将注意力矩阵分解为低秩形式,把复杂度压缩到 O (N),完美适配百万级超长上下文场景。2026 年主流方案不再全盘替换原生注意力,采用混合架构:底层使用线性注意力处理长序列,顶层保留少量标准注意力捕捉精细关联,兼顾长文本效率与推理质量。线性注意力改变了 Scaling Law 中序列长度的约束项,在长上下文任务下,模型能力随序列长度提升的衰减曲线显著优于标准 Transformer。它的局限在于复杂推理任务上表达能力弱,纯线性注意力模型在数学、逻辑推理基准上存在性能损失,因此多与 MoE 架构组合使用。
 82fe33bf6a8fac742f63cdc24c058cc.webp
测试时计算,是 2026 年稀疏化竞赛中最具颠覆性的方向。传统模型的算力预算全部投入预训练阶段,推理阶段固定权重、固定计算量。测试时计算将算力分配后移,在推理阶段根据任务难度动态分配计算资源:简单问答任务用少量算力快速输出;复杂推理、代码生成任务,允许模型多轮迭代、自校验、调用更多计算单元,在测试阶段追加算力投入。这套思路彻底改写 Scaling Law:能力提升不再只依赖预训练阶段的投入,推理侧动态算力预算成为独立变量。在 2026 年多个公开对照实验中,固定预训练模型权重,仅提升测试时计算预算,复杂任务准确率可以获得 15%~25% 的提升。测试时计算天然适配 Agent 智能体场景,但会带来推理延迟不稳定、成本不可预测等工程难题。
三条稀疏化路线不是互相替代,而是走向融合。MoE 负责参数层面稀疏,线性注意力负责序列维度稀疏,测试时计算实现任务层面动态算力分配。三者叠加之后,原有的 Scaling Law 幂律公式不再适用。过去行业评估模型只看总参数量、训练 FLOPs;2026 年新的评估范式,必须同时考量激活算力、上下文复杂度、测试时动态预算。
稀疏化浪潮也存在不可忽视的边界。MoE 路由偏差、线性注意力的表达缺陷、测试时计算的推理成本波动,都会限制模型落地。稀疏模型的幂律收益存在拐点,当稀疏度过高,模型能力会快速跌落,并非越稀疏越好。研发团队需要在稀疏度、推理延迟、任务能力之间寻找最优边界。
结语
后 Transformer 时代的稀疏化竞赛,本质是算力资源分配范式的变革。经典 Scaling Law 诞生于稠密模型时代,假设所有参数全程参与计算。MoE、线性注意力、测试时计算,共同推翻了这个前提。未来大模型的能力增长,不再依靠无限制堆叠稠密参数,而是按需调度算力。新的 Scaling Law 将是多变量耦合的复杂关系,这将重塑基座模型训练、推理部署与商业成本核算的整套体系。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。
评论列表