
2024-2025 年,多模态大模型的核心能力集中在静态内容解析:上传图片、视频文件、文档,模型完成一次性理解并输出文本答案。这套 “输入 - 处理 - 输出” 的串行模式,本质上是对已经录制完成的静态素材做解读,无法适配动态变化的真实世界。而 2026 年行业最大的变革,就是多模态大模型跨越静态解析边界,走向全场景实时流式交互。AI 不再是等待用户提交素材的离线分析器,而是持续感知环境、动态修正推理结论、支持随时被打断的实时智能体,视觉、音频、文本、时序运动信息在同一个底座中统一编码融合,重构人机交互底层范式。
 97fecd710beab26971dcec6f196c7b0.webp
传统多模态模型的底层痛点,在于模态处理分离与时序割裂。早期方案大多采用 “独立编码器 + 文本大模型” 拼接架构:图像、音频分别通过 ViT、音频编码器转为特征,再拼接送入文本大模型。这种架构在处理静态图片时效果尚可,但面对直播流、实时摄像头画面、连续语音对话时存在明显短板:模型需要等待一整段视频帧全部编码完成后才开始推理,无法边看边思考;当画面内容发生变化,旧的 KV 缓存无法快速更新,导致模型无法感知最新场景,出现信息滞后,无法处理人类对话中常见的打断、插话、环境突变等行为。
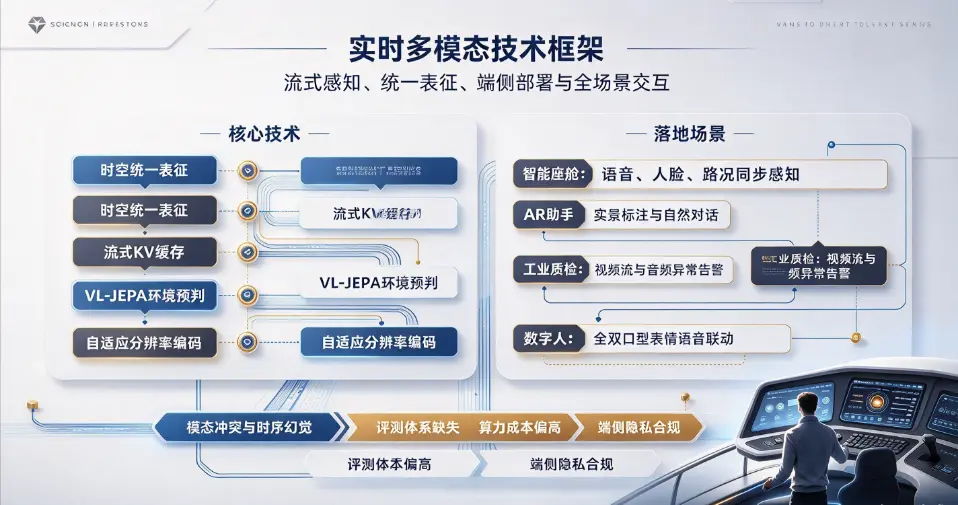
2026 年多模态底层架构革新,核心方向是时空统一表征与全双工流式框架。以 MiniCPM-o 4.5、MOSS-VL-Realtime、StreamingVLM 等开源模型为代表,行业抛弃了传统分帧采样的离线处理思路,采用统一时序轴对视频、音频、文本做联合编码,将时间作为独立维度嵌入模型表征空间,实现视觉运动、声音变化、对话上下文的同步对齐。其中 Omni-Flow、流式 KV 缓存技术是关键突破:模型不再完整保存全部历史视觉 token,而是动态维护轻量化缓存,保留关键场景特征,丢弃冗余像素信息,新的画面帧与音频片段持续流入,实时更新模型内部认知,推理和感知并行执行,做到 “边看边答,边听边改”。
在推理效率层面,2026 年的技术创新大幅压低实时交互延迟。VL-JEPA 这类联合嵌入预测架构,不再完全依赖逐 token 自回归生成,通过嵌入空间预测完成环境预判,在相同参数量下,时序预测能力显著提升,同时降低算力开销;自适应分辨率编码技术让模型自动识别画面重点区域,不重要的背景采用低分辨率编码,目标物体切换高分辨率解析,在不损失关键信息前提下压缩 token 数量,将端到端多模态交互延迟压缩至百毫秒级别,达到人类自然对话的响应阈值。
另一重要趋势是端侧多模态能力规模化落地。此前实时多模态模型高度依赖云端 GPU 集群,网络波动会直接破坏交互连续性。2026 年,量化、蒸馏、稀疏注意力技术成熟,百亿参数级多模态底座可以部署在手机、车载芯片、边缘计算盒子。端侧模型本地完成摄像头画面、麦克风音频的实时解析,仅将复杂规划任务上传云端,大幅降低带宽依赖,在无网络环境下依旧可以完成实时视觉问答、语音交互、场景识别。这一突破直接打开消费电子、车载、工业边缘场景的落地窗口。
从应用场景来看,实时多模态正在渗透到各行各业,完成从 Demo 走向生产级落地。在智能座舱场景,车载多模态模型同时感知车内语音、驾驶员面部画面、道路实时视频流,同步识别驾驶员疲劳状态、语音指令、前方路况,可随时被驾驶员打断,动态调整导航、多媒体、预警提示,不再局限于简单语音指令。AR/VR 实景助手是另一核心赛道:AR 眼镜摄像头持续采集现实环境,模型实时叠加图文标注、物体识别、空间定位,用户可以一边观察现实场景一边自然对话,实现实景翻译、设备检修指引、空间物体检索。
工业质检领域,实时多模态模型接入产线摄像头,持续识别产品外观缺陷,同步读取传感器音频、设备运行参数,一旦发现异常立刻告警,相比传统机器视觉方案,多模态模型可以理解复杂自然语言指令,支持工程师用口语调整质检标准,不需要重新编写大量规则代码。数字人直播与客服场景,全双工多模态模型实现口型、表情、语音实时联动,用户可以随时插话打断,数字人同步调整回答逻辑,解决过去数字人交互生硬、无法实时响应变化的痛点。
尽管技术边界持续拓展,2026 年实时多模态仍然存在不可忽视的技术短板。第一,模态冲突与时序幻觉。当视觉画面、音频信息出现矛盾时,模型容易产生时序幻觉,错误预判物体运动轨迹;长时间连续流式感知下,模型会逐步遗忘早期关键信息,长时序一致性仍然是难点。第二,评测体系缺失。传统多模态评测基准以静态图片、短视频离线问答为主,缺少面向连续动态场景、全双工交互的标准化数据集,很难量化评估模型实时感知、主动响应、抗打断能力,很多 Demo 效果在真实复杂环境下会快速衰减。第三,算力与成本压力。全双工实时多模态持续编码音视频流,算力消耗远高于传统文本对话,大规模商用场景下推理成本依然偏高。第四,安全与隐私风险,端侧实时采集图像、音频数据,带来大量个人环境信息,数据采集、存储、内容审核的合规压力显著上升。
长期演进来看,实时多模态大模型是通向世界模型与具身智能的关键底座。单纯文本模型只能理解语言符号,静态多模态看懂图片,而 2026 年的实时多模态能够持续感知动态环境、预判物理变化,学习现实世界的基础物理规则。未来,多模态模型将进一步和机器人、智能体规划模块融合,AI 不再只是回答问题,而是基于实时视觉听觉感知,在真实环境中完成规划、执行、纠错,实现从 “理解世界” 走向 “在世界中交互”。
从产业落地角度,企业选型不能单纯追求模型参数大小,而要重点关注流式延迟、端侧部署能力、多模态对齐稳定性与幻觉控制能力。对于开发者,实时多模态应用开发的重心,已经从单纯 Prompt 调优,转向构建完整的多模态数据流、缓存管理、时序校验、人工复核的工程体系。
整体而言,2026 年是多模态大模型的分水岭:技术重心从静态内容理解转向实时动态交互。文本、图像、音频不再是独立输入素材,而是统一时序世界的不同观测信号。这一轮技术突破,将彻底改变人机交互形态,把 AI 从屏幕内的文本对话,延伸到现实空间的全场景感知交互。但同时,时序幻觉、评测体系、算力成本、隐私安全等难题仍待持续攻克,距离稳定、可靠、类人级别的全场景智能,行业仍有较长探索周期。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。

评论列表