
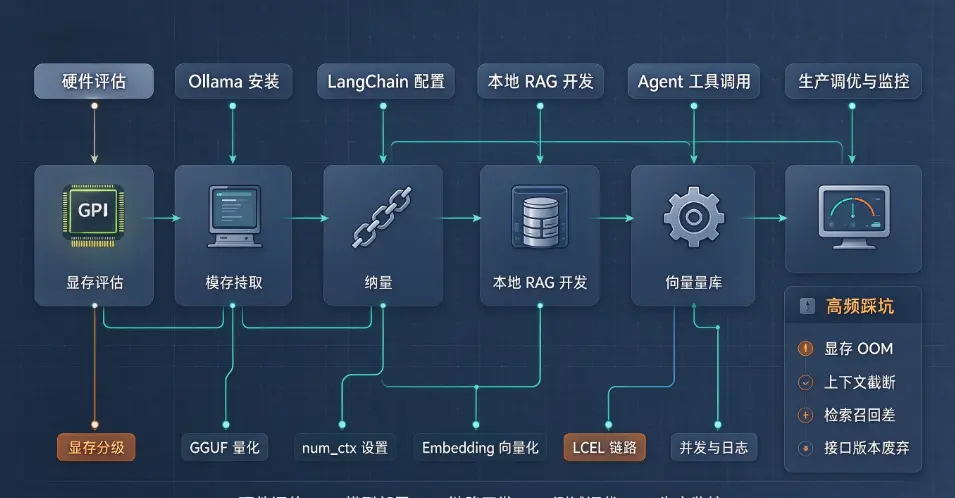
根据 2026 年开源大模型开发者调研,Ollama 已经占据本地大模型运行时 61.7% 的市场份额,超过 llama.cpp、vLLM 等同类工具。但大量初学者只完成 “本地跑通对话”,无法构建可复用的业务链路,在进入生产环境后遭遇显存溢出、上下文静默截断、工具调用失效、向量库版本不兼容等问题。本文从硬件评估、环境安装、模型选型、LangChain 链路开发、RAG 知识库构建、生产调优、故障排查完整落地,打通从单机模型到可用本地 AI 应用的全流程。
 ce39424b91100199ac932239e8b6efc.webp
一、前置评估:硬件选型与模型量化策略(2026 最新标准)
入门级:8GB 显存显卡(RTX3060/4060),可稳定运行 7B 参数 Q4 量化模型,适合文档问答、简单文本处理;
中端:12~16GB 显存(RTX4070Ti),支持 14B 模型,可完成复杂长文本推理、RAG 知识库;
高端:24GB 显存(RTX4090/5090),32B 量化模型可流畅运行,支持多并发、Agent 工具调用;
Mac 用户:M 系列统一内存,16GB 内存可流畅跑 7B 模型,36GB 内存可运行 14B 模型。
ollama pull qwen3:8b-q4_K_M,下载完成后 Ollama 后台自动加载模型,默认服务端口 11434,自带 OpenAI 兼容接口,方便 LangChain 调用。重点避坑:很多新手忽略 Ollama 默认上下文窗口仅 4096token,即使模型原生支持 128K 长上下文,不手动配置num_ctx参数会出现静默截断,不会抛出报错,直接丢失长文档后半段内容,这是 2026 本地项目最高发隐性故障。
二、环境搭建:Ollama 安装 + LangChain 依赖配置
curl -fsSL https://ollama.com/install.sh | sh;macOS 支持 brew 安装brew install ollama,安装完成执行brew services start ollama后台常驻服务。Windows 安装后托盘自动启动 ollama serve 服务。http://localhost:11434,返回 Ollama 服务提示即代表部署成功。langchain-ollama,旧版 community 内的 ChatOllama 接口已经废弃,不能继续沿用旧教程的导入方式。依赖安装命令:pip install langchain langchain-ollama langchain-chroma langchain-community
from langchain_ollama import ChatOllama, OllamaEmbeddings。
OllamaEmbeddings 用来生成本地向量,不需要调用第三方 Embedding 接口,整套链路完全离线,满足数据不出内网的隐私需求。llm = ChatOllama( model="qwen3:8b-q4_K_M", base_url="http://localhost:11434", temperature=0.3, num_ctx=8192 )
三、核心实战:基于 Ollama+LangChain 搭建本地 RAG 检索增强系统
nomic-embed-text,不需要网络请求,将文档片段转为向量。
第三步,向量库存储,选用 Chroma 轻量向量数据库,单机部署无需额外安装服务,直接本地持久化保存向量。
第四步,检索链构建,用户提问后,先将问题转为向量,在向量库检索相似度最高的文档片段,把原文片段 + 用户问题一起送入本地大模型,基于参考资料生成答案。四、进阶能力:本地 Agent 工具调用与生产级调优
OLLAMA_NUM_PARALLEL,控制并发请求数量。并发控制:
OLLAMA_NUM_PARALLEL控制同时推理请求数量,单卡建议设置为 1~2,超过上限请求进入队列排队,不会直接报错;模型卸载策略:Ollama 默认闲置 5 分钟自动卸载模型,可以通过环境变量修改超时时间,高频访问场景延长驻留时间,减少重复加载模型的耗时;
结构化输出:利用 Ollama 支持的 Structured Outputs,传入 JSON Schema,强制模型返回标准化 JSON,用于对接后端业务系统,解决本地模型输出格式混乱的痛点;
监控日志:开启 Ollama 日志,跟踪显存占用、token 吞吐,提前发现内存溢出风险。
五、高频故障排查与落地边界
显存 OOM 溢出:并发请求过高、模型选择过大。解决方案切换更高压缩量化版本,降低 num_ctx,或者开启模型卸载;
上下文静默截断:未设置 num_ctx,长文档被直接截断,没有报错,需要在 ChatOllama 参数显式指定上下文长度;
向量检索效果差:文本切分策略不合理,Embedding 模型选型错误,需要调整 chunk 大小,更换适配中文的 Embedding 模型;
LangChain 接口报错:旧教程使用 langchain_community.ChatOllama,新版本已废弃,必须替换为 langchain_ollama 包。
六、落地总结
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。

评论列表