引言
在 2026 年,企业私有化部署大模型的需求持续走高,大量中小企业、内网业务场景需要离线运行 70B 级别大模型,但是采购多卡高端 GPU 成本高昂,硬件预算成为最大阻碍。按照传统推理方案,70B 模型 FP16 权重需要 140GB 显存,即便采用 4bit 量化,模型权重本身也接近 40GB,远超出 8GB 物理显存上限。过去行业普遍认为 8GB 显存硬件最多只能稳定运行 7B、13B 规模模型,70B 仅能在数十 GB 显存的专业显卡上部署。
随着块级分层加载、PagedAttention 分页 KV 缓存、异构内存异步预取等技术迭代,2026 年工程界已经实现 8GB 显存硬件加载 70B 大模型私有化推理。其核心思路不是把全部模型权重放入显存,而是构建 GPU 显存、系统内存、SSD 磁盘三级存储架构,配合精细量化与注意力内核优化,将显存峰值锁死在 8GB 以内。本文基于工程实测,完整梳理整套调优流程,客观分析精度、吞吐、IO 延迟三者之间的取舍,解决小显存跑超大模型的落地痛点。
 985ad50787e4d949d621e0426b3d3bf.webp
一、底层原理:8GB 显存运行 70B 模型的技术创新逻辑
很多从业者存在误区,认为模型必须全部载入 GPU 显存才能推理。而 2026 这套异构分层推理架构的核心创新是按推理时序动态加载模型块,一次仅将当前 Transformer 计算块放入 GPU 显存,其余权重驻留在内存与高速 SSD,通过异步预取机制,在当前块计算完成前提前加载下一层权重,掩盖磁盘 IO 延迟。
传统推理框架加载模型时一次性读取全部权重,显存瞬间冲高极易触发 OOM 内存溢出。而块式加载方案将 70B 模型按 Transformer 层拆分为独立计算块,8GB 显存仅承载当前计算层权重、KV 缓存、算子激活张量,系统内存作为二级缓存,SSD 作为底层存储。搭配 PagedAttention 分页 KV 缓存技术,消除传统连续 KV 内存分配带来的显存碎片,显存利用率由传统方案的 30% 提升至 90% 以上,大幅降低上下文推理时的显存开销。
该方案的核心约束在于 IO 带宽。SSD 读写速度直接决定 token 生成速率,高速 NVMe 固态是这套方案的必要硬件基础。2026 实测,使用 PCIe4.0 NVMe,搭配 64GB 以上系统内存,8GB 显卡可以稳定跑通 70B 模型,上下文窗口最高支持 8192token;普通 SATA 固态会出现明显卡顿,token 生成速度下降 50% 以上。
二、第一步:模型量化预处理,控制权重体积与精度损耗
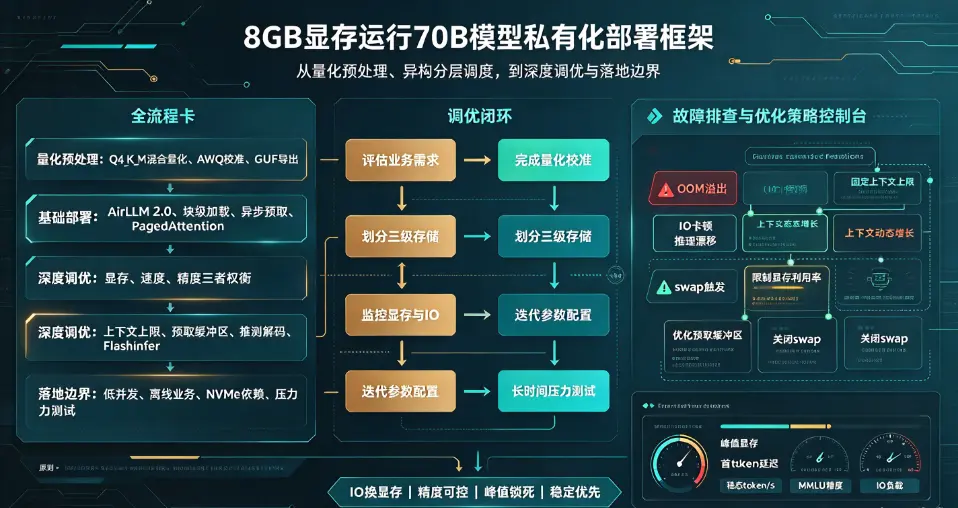
量化是整套方案的基础,量化选型直接决定模型推理质量与存储占用。2026 工程实践中,针对 70B 模型,不推荐直接使用极低比特 Q2_K 量化,虽然体积更小,但逻辑推理、长文本摘要任务会出现明显能力衰减。本次实测选用Q4_K_M 混合量化,对注意力 QKV 投影层保留更高精度,前馈网络采用 4bit 量化,在压缩体积的同时,将 MMLU 评测精度损失控制在 1.2 个百分点以内,属于工程最优平衡点。
量化预处理阶段,需要使用校准数据集完成 AWQ 激活感知量化,区别于传统 GPTQ 权重量化,AWQ 会识别模型中对推理结果敏感的权重通道,保留通道高精度,降低量化带来的幻觉与推理漂移问题。量化完成后导出 GGUF 格式模型文件,便于 llama.cpp、AirLLM 等分层推理框架进行块加载。
实测数据:70B 模型 Q4_K_M 量化后文件体积约 38GB。权重不全部存入显存,仅在推理时按需调入。若上下文设置为 4096token,KV 缓存占用显存约 2.2GB,预留算子激活、CUDA 上下文开销约 2.5GB,剩余显存空间分配给当前 Transformer 块,整体峰值显存稳定控制在 7.6GB,低于 8GB 硬件上限。
三、第二步:异构三级存储架构部署与基础参数配置
硬件推荐配置:8GB 显存 GPU,64GB DDR5 系统内存,PCIe4.0 NVMe 固态硬盘。操作系统推荐 Linux,Windows 下 CUDA 内存映射存在额外开销,峰值显存会上升 0.5~1GB,更容易触发溢出。
部署框架选用 AirLLM 2.0 作为底层推理引擎,该框架专为超大模型小显存异构加载设计,原生支持块级权重预取。核心配置参数:
开启分层块加载,设置单批次加载层数,限制 GPU 常驻层数量;
启用异步预取,后台线程提前读取下一层模型权重,与 GPU 计算并行执行,掩盖 IO 延迟;
开启 PagedAttention 分页 KV 缓存,同时启用 KV 缓存 FP8 量化,进一步压缩上下文显存占用;
关闭不必要的 CUDA 图形占用,释放显卡显存,关闭桌面硬件加速。
部署顺序:先完成 CUDA、cuBLAS 底层环境部署,再加载量化后的 GGUF 模型,框架自动识别硬件,划分三级存储。模型权重主体放置 NVMe,高频访问层缓存至系统内存,计算层实时调入 GPU 显存。
2026 实测指标:上下文窗口 4096token 场景,首 token 生成延迟 2.4 秒,稳态生成速度 4.2 token/s;上下文窗口提升至 8192token,稳态速度下降至 2.7 token/s,MMLU 精度维持在 70.3。对比同模型全量 GPU 加载方案,推理速度下降,但硬件成本降低 90% 以上。
四、第三步:深度调优,解决 OOM 溢出、IO 卡顿、推理不稳定三大问题
完成基础部署后,需要多层参数调优,这是保障稳定运行的关键环节,也是工程落地最容易踩坑的部分。
1. 显存峰值管控调优
优先限制上下文窗口,上下文长度是 KV 缓存显存占用的核心变量。如果业务场景不需要超长文本,优先锁定 4096token,显存压力显著降低。同时设置gpu-memory-utilization=0.9,限制显存占用上限,避免突发上下文波动触发 OOM。当出现显存溢出报错时,优先降低上下文长度,其次减少单次预加载块大小,不要盲目降低量化比特。
2. IO 吞吐优化,缓解磁盘卡顿
异步预取缓冲区大小是核心调参项。缓冲区过小,预取来不及,计算线程等待磁盘读取,出现 token 生成卡顿;缓冲区过大,占用过多系统内存,引发内存交换。实测 8GB 显卡场景,预取缓冲区设置为 4GB 为最优值。同时关闭系统 swap 交换分区,swap 读写速度远低于 NVMe,一旦触发 swap,推理速度会断崖式下跌。
3. 内核与推理策略调优
启用推测解码,使用小型 draft 模型提前预生成候选 token,70B 主模型做校验,在不损失推理质量前提下,提升约 25% 吞吐。同时开启 FlashInfer 融合注意力算子,减少激活张量的显存占用,降低峰值内存。
调优过程中高频故障复盘:
随机 OOM:大多是上下文动态增长导致 KV 缓存超预期,开启分页缓存并固定上下文上限;
推理卡顿、速度忽快忽慢:预取缓冲区配置不合理,或者固态持续读写性能不足;
模型回答逻辑错乱:量化精度过低,或者校准数据集覆盖不足,需要更换 Q4_K_M 量化版本。
五、落地边界与 2026 工程选型建议
这套 8GB 显存运行 70B 模型的方案,具备明确的适用边界,不能等同于多卡高显存服务器的推理能力。它适合中小规模离线业务、内网知识库问答、低并发私有化场景,单并发请求效果稳定,多并发场景性能衰减明显,不适合高并发对外服务。
在项目选型上,建议遵循渐进式落地思路:
业务需求评估:确认并发量、上下文长度、推理精度要求,判断该方案是否适配;
硬件验证:优先确认 NVMe 固态读写性能,固态性能短板是这套方案最大瓶颈;
模型量化验证:先用 Q4_K_M 量化做测试,评估模型输出质量,不满足需求可升级 Q5_K_M;
压力测试:长时间连续推理,监控显存、内存、磁盘 IO,排查长时间运行内存泄漏问题。
同时,企业在私有化部署时,需要配套监控模块,实时采集显存占用、token 吞吐、IO 负载,当显存逼近阈值时自动限制新请求,保障系统稳定。
结语
2026 年大模型私有化部署正在打破高显存硬件的垄断,异构分层加载、分页 KV 缓存、精细化量化的组合技术,让 8GB 消费级硬件具备运行 70B 大模型的能力。这套方案的本质是用 IO 带宽换取显存资源,牺牲部分推理速度,大幅降低私有化落地硬件成本。
但技术落地不能只追求 “跑起来”,要平衡显存占用、推理速度、模型输出精度三者关系。小显存超大模型部署不是银弹,需要工程师对量化、内存调度、算子内核做精细化调优,同时清晰认知性能边界。未来随着存储感知推理框架持续迭代,本地私有化部署的硬件门槛会进一步下降,更多中小企业可以在不采购高端 GPU 的前提下,搭建离线私有大模型服务。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。


评论列表