
2026 年,AI 行业已经告别单纯比拼参数量、文本生成质量的早期阶段,进入 “感知 - 推理 - 仿真 - 行动” 一体化系统构建的新阶段。如果说 2023-2025 年是生成式 AI 爆发期,以文本、图像生成为核心;那么 2026 年的核心主线,是AI 如何理解真实世界的因果规律,在不确定环境中完成长周期任务,并且能够和物理世界交互执行。支撑这场变革的三大底层技术:世界模型、推理增强大模型、多模态智能体(多模态 Agent),不再是彼此独立的研究方向,而是开始深度耦合,共同定义 AGI 的阶段性形态。
 5fe0773aac3a91c30887a67438a3a91.webp
一、推理大模型:从统计拟合走向深度因果思考,推理期计算成为核心创新点
传统大模型依靠预训练学习海量文本里的统计关联,擅长续写、总结、问答,但面对多步骤数学题、复杂逻辑规划、长链条工程问题时,容易出现幻觉、逻辑断层。2026 年推理大模型的核心突破,在于将推理时思考(Inference-Time Reasoning)、过程奖励模型(PRM)、思维链自校验机制深度嵌入模型原生架构,不再依赖外挂提示词技巧来实现复杂推理。
根据 2026 年各大评测基准数据,新一代推理模型在长链式逻辑任务、科学推理、代码工程问题上,相比 2025 年基线模型,综合解题通过率提升 40%~70%。OpenAI、Anthropic、国内智源、百川等团队的前沿模型,普遍采用 “快速草稿 + 多轮自省校验” 机制:模型先快速生成初步思路,然后对推理步骤逐段自检,识别逻辑漏洞、修正错误,再输出最终答案。这种模式模拟人类思考,显著降低幻觉,提升复杂任务可靠性。
推理大模型的另一大变革是推理成本优化。2026 年行业普遍采用 MoE 混合专家架构、动态激活路由、稀疏注意力,实现 “简单任务轻量推理,复杂任务激活专家模块”。同等算力预算下,复杂推理任务的 token 成本相比 2025 年下降 50% 以上,让长任务、多步骤规划的商用落地成为可能。
但推理大模型仍存在明显短板。第一,长程规划稳定性不足,当任务超过数十步、环境变量持续变化时,模型容易出现推理漂移;第二,推理能力高度依赖高质量推理数据集,高质量标注数据供给不足;第三,模型 “思考过程” 仍然是黑盒,中间推理步骤难以审计,带来安全与合规挑战。推理大模型本质解决的是 \\AI “怎么想”\\ 的问题,它负责逻辑拆解、方案规划、自我校验,但缺少对物理环境的感知与预测能力,这正是世界模型要补齐的能力。
二、世界模型:让 AI 在数字虚拟空间 “预判现实”,打通数字世界与物理世界
很多人简单把世界模型等同于视频生成模型,这是典型误区。2026 年产业界共识:世界模型的核心不是生成画面,而是对环境状态、物理规则、物体交互做时序预测。输入当前环境观测(图像、点云、传感器数据),模型可以在内部虚拟模拟器中推演未来多步环境变化,预测动作带来的结果,再选择最优行动方案,这也是具身智能、机器人、自动驾驶仿真的底层底座。
2026 年国内外世界模型项目迎来密集开源。英伟达 Cosmos、智源 Emu3.5、大晓开悟 Kairos、星动纪元 VPP2 世界动作模型等,在 RoboDojo、WorldModelBench 等具身智能评测基准持续刷新成绩。智源 Emu3.5 实现跨文本、图像、视频统一的下一状态预测,原生建模时空关系、物理约束,解决过去生成视频物体穿模、违背物理定律的痛点;星动纪元 VPP2 采用 “预测与动作解耦” 架构,在机器人精细操作任务上取得全球领先成绩并开源,降低具身智能开发者的入门门槛。
世界模型的价值,在于降低现实世界试错成本。机器人训练、自动驾驶场景,如果全部在真实物理世界做实验,成本极高、风险巨大。世界模型可以构建高保真数字孪生环境,让智能体在虚拟环境中反复试错、探索策略,完成预训练之后再迁移到真实硬件。
当前世界模型的瓶颈同样突出。真实世界存在大量未知变量、随机扰动,高保真大规模场景的状态预测误差会随时间累积;三维空间、多物体复杂交互的算力开销巨大,端侧部署难度高;现实世界大量长尾场景数据稀缺,泛化能力受限。世界模型解决 AI\\“想象并预判环境”\\ 的能力,但它缺少自主目标拆解、工具调用的执行框架,这就需要多模态 Agent 作为系统载体。
三、多模态 Agent:三大技术的落地载体,从单模态助手进化为自主任务系统
多模态 Agent,是把多模态感知、推理大模型的思考能力、世界模型的环境仿真、记忆系统、工具调用、动作执行模块封装在一起的完整智能系统。区别于早期只做文本对话的 Agent,2026 年的多模态 Agent 原生接收图像、视频、音频、3D 点云等多模态输入,能够看懂图片、观察环境、理解空间信息,自主拆解目标、规划子任务、调用外部工具,并且根据环境反馈动态调整策略。
2026 年多模态 Agent 出现两大趋势:一是多智能体协同,不再是单个 Agent 独立完成任务,多个具备不同专长的智能体组成团队,分工并行作业。Anthropic 的 Managed Agents 动态工作流测试显示,多 Agent 协同在大规模代码漏洞扫描任务中,检出率远高于单智能体;国内 WorkBrain 6.5 新增协作总线,实现多智能体调度、跨系统集成,面向工业、企业业务场景落地。二是长期记忆与状态持久化,智能体可以跨会话保存项目信息、用户偏好,持续跟进跨时长任务,例如长期项目跟踪、持续科研实验、多步骤工程交付。
在产业落地层面,多模态 Agent 已经进入医疗影像辅助诊断、工业质检、科研数据分析、数字孪生运维等场景。智源 BAAI Cardiac Agent 心脏磁共振诊断智能体,融合多模态影像与文本临床知识,AUC 超过 0.93,复刻专家团队的协作诊疗流程;工业场景的质检 Agent,通过视觉感知 + 推理规划,自动识别缺陷、生成报告、触发工单,替代大量重复性人工检视工作。
多模态 Agent 的核心挑战集中在系统稳定性、安全权限与成本。Agent 一旦具备自主调用工具、访问外部系统的能力,一旦出现指令误判、幻觉,可能触发错误操作;长任务过程中,多模态信息融合、记忆检索、世界模型仿真叠加在一起,系统复杂度急剧上升,故障排查难度大。因此,2026 年行业共识:Agent 落地必须设置权限隔离、人工复核节点、任务熔断机制,不能无限制开放自主执行权限。
四、三者协同:下一代 AI 系统完整架构,以及行业演进的下一站
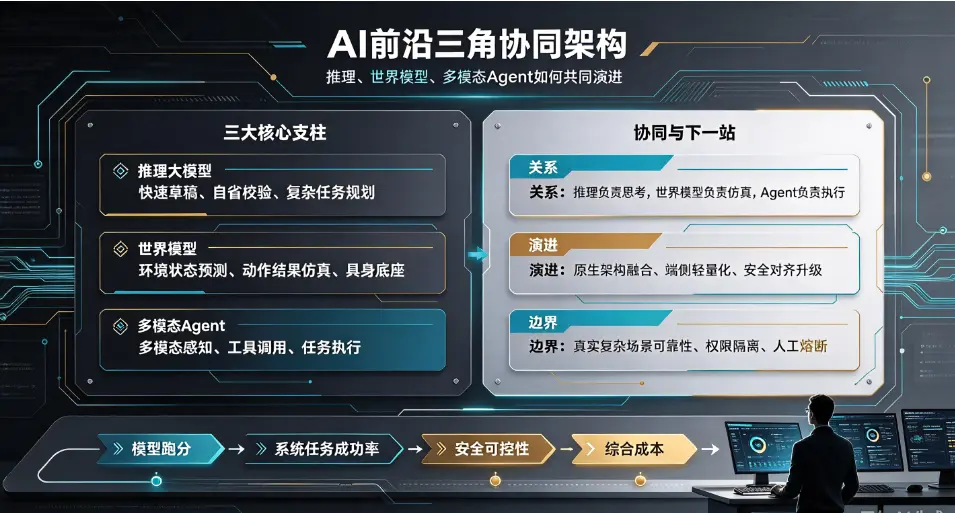
理清三者关系,一句话概括:推理大模型是智能体的大脑,负责思考、规划、逻辑校验;世界模型是内在虚拟模拟器,用来预判环境变化、推演行动后果;多模态 Agent 是整套系统的躯干与执行器,负责感知现实、调用工具、落地执行。三者结合,AI 才从被动回答问题的聊天机器人,变成能够在真实环境中完成复杂目标的自主智能系统。
站在 2026 年的节点预判,未来 3 年技术演进会沿着三个方向推进:
第一,模型架构融合。未来不会是独立的推理大模型 + 外挂世界模型,而是原生一体化基座,同时具备语言推理、多模态感知、环境状态预测能力,减少多模块拼接带来的信息损失与延迟。
第二,端侧轻量化。世界模型、推理模块逐步轻量化压缩,让机器人、边缘设备本地运行仿真与推理,降低云端依赖,提升响应速度、保护隐私。
第三,安全对齐体系升级。随着 Agent 自主能力变强,行业会加速建立任务边界、权限管控、行为审计、风险熔断等安全机制,在能力提升的同时约束 AI 行为。
同时,必须客观看待技术泡沫。当前世界模型、多模态 Agent 仍处于早期阶段,很多演示效果是在受控、简化环境下实现,放到充满不确定性的真实复杂场景,可靠性会明显下降。行业不会一步进入通用人工智能,未来数年的落地形态,会是垂直场景专用智能体:在医疗、工业、科研、运维等限定场景,依托世界模型仿真、推理大模型做决策,解决高价值、标准化的复杂任务。
结语
2026 年 AI 技术的主线,已经从生成内容转向自主行动。推理大模型赋予 AI 逻辑思考能力,世界模型赋予 AI 对物理世界的预测能力,多模态 Agent 把这两种能力封装为可落地的应用系统。三者共同构成下一代 AI 的技术底座。
未来的竞争,不再只看模型在基准测试上的跑分,而是看整套系统在真实不确定环境下的任务成功率、稳定性、安全可控性与综合使用成本。技术创新的同时,数据治理、权限安全、伦理约束、行业合规,将成为决定这项技术能否大规模产业化落地的关键。AI 的下一站,不是无限的参数竞赛,而是打造能够安全、可靠地理解并交互现实世界的智能系统。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。
评论列表