当我们直接向单个大模型下达指令:“调研某行业,输出完整报告并附带数据图表”,最终成品往往存在信息陈旧、数据编造、图表与正文内容脱节、逻辑断层等问题。这是单一模型的天然短板:同时承担检索、分析、写作、绘图多重任务,角色混淆,缺乏独立校验环节。2026 年,多智能体(Multi-Agent)编排技术走向工程化落地,核心思路是拆分专业角色,多个专用 AI 智能体分工协作,按状态机流转,自动完成复杂长流程任务。Gartner 数据显示,2026 年底 40% 企业应用将内置任务专用智能体,多智能体编排已经成为企业自动化报告生产的主流方案。本次实战搭建一套端到端工作流,目标仅输入一个调研主题,系统自动完成文献与网络调研、数据清洗、报告撰写、图表生成、事实核验全流程。
 698bea1aaf6bf77f8dbf18cac13e932.webp
一、多智能体角色架构设计:各司其职的 AI 团队
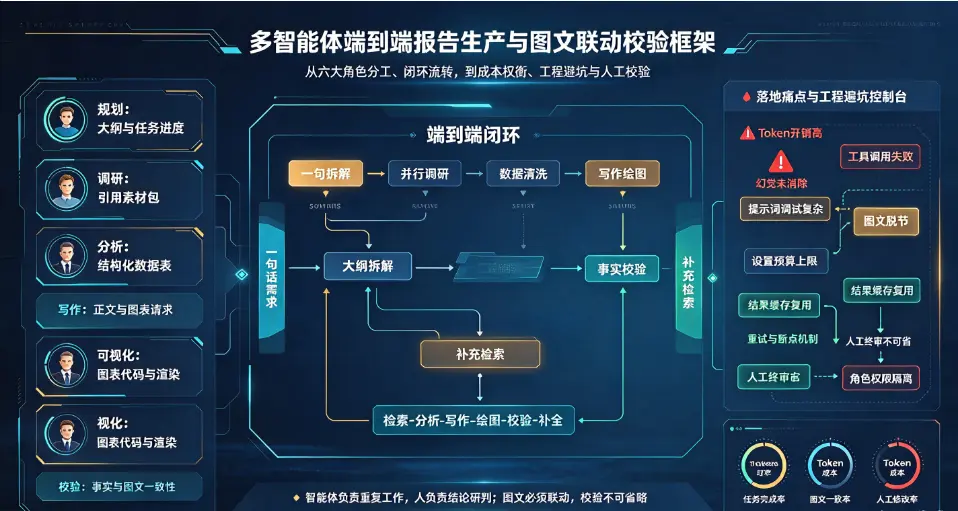
本次实战基于 LangGraph 状态机编排,搭配 CrewAI 角色定义,搭建 6 个独立智能体,形成闭环协作流水线。每个智能体拥有独立的系统提示词、工具权限、目标约束,智能体之间通过标准化消息协议 A2A 传递任务结果,支持断点保存、循环校验。
规划智能体(Planner):接收用户原始需求,拆解调研目标,拆分出若干子调研问题,输出报告大纲,定义需要采集的数据维度与可视化类型。它负责管控整体任务进度,判断子任务是否完成,识别信息缺口并发起二次检索。
调研智能体(Researcher):调用联网检索工具、RAG 私有知识库,并行采集公开行业报告、统计数据、新闻文献,自动提取原文引用来源,过滤无效、低可信度网页,输出带有引用标记的原始素材包。多个调研智能体可并行执行不同子问题,缩短整体耗时。
数据分析师智能体(Data Analyst):从调研素材中提取结构化数据,清洗异常值,识别数据冲突,生成结构化数据表,判断数据是否支撑论点。当数据缺失时,向规划智能体反馈,触发补充检索。
写作智能体(Writer):按照大纲、素材、数据表撰写完整报告正文,在需要数据支撑的位置插入可视化标记,通知可视化智能体生成对应图表,保证图表服务于论点,而不是单纯美化页面。
可视化智能体(Visualization Agent):接收数据表与图表需求,自动生成 Python 绘图代码,执行代码渲染图表,校验图表坐标轴、单位、图例,剔除无效图表,返回图片文件与图表说明。
事实校验智能体(Verifier):全文交叉核验,检查正文、引用、图表数据三者一致性,标记幻觉、无来源数据、逻辑矛盾段落,回传给写作智能体修改,循环迭代直到错误率低于预设阈值。
整套系统采用条件分支流转,不是简单线性流水线。当校验智能体发现数据缺失,流程会回退至调研智能体重新采集,形成 “检索 - 分析 - 写作 - 绘图 - 校验 - 补全” 的闭环迭代,这是单模型无法实现的核心能力。
二、实战过程:从一句话需求到完整带图表报告
本次实战测试任务:调研 2026 国内 AI 办公工具市场现状,输出行业分析报告,包含市场规模、用户增长、赛道格局三张可视化图表。
任务启动后,规划智能体先拆解需求,生成报告大纲,划分市场规模、用户画像、竞争格局、风险预判四大章节,明确需要折线图展示用户增长、柱状图展示厂商份额、表格呈现市场规模数据。
调研智能体并行启动多线程检索,抓取行业第三方报告、公开统计数据,保留原文链接作为引用,剔除自媒体未经证实的观点。在实测中,调研智能体发现部分数据源口径冲突,自动标记数据差异,交由数据分析师甄别,优先采信权威机构公开数据。数据分析师提取整理表格,识别异常数据,剔除估算偏差过大的数值。
写作智能体按照大纲撰写正文,当写到市场规模章节,自动触发可视化请求。可视化智能体读取数据表,生成 matplotlib 代码,渲染图表,校验单位、时间维度,避免图表坐标轴错误。图表生成完成后,自动嵌入报告对应章节。
最后进入事实校验环节,校验智能体逐条核对文中每一处数据,对比原始检索来源,标记两处存在夸大预估的表述,回传给写作智能体修改。经过两轮迭代,最终输出完整 Markdown 报告,附带三张图表与全部参考文献。
本次实测对比单一大模型基线:单模型方案幻觉率 26.8%,图表与正文数据不一致问题多发;多智能体流水线幻觉率降至 4.2%,降幅明显;人工修改工作量减少约 62%,但整体 token 消耗为单模型的 2.7 倍,带来更高 API 调用成本。这也是多智能体落地的核心权衡:用更高算力开销换取更高可信度与自动化深度。
三、核心优势与底层创新:为什么多智能体更适合长文本 + 可视化任务
传统单模型生成报告,是 “一次性生成”,模型很难同时兼顾检索、数据计算、绘图、事实校验。而多智能体本质是模拟人类团队分工,优势体现在三点。
第一,任务解耦,专业能力隔离。调研智能体专注检索溯源,可视化智能体专注代码绘图,校验智能体专门抓事实错误,避免一个模型同时处理多种任务带来能力稀释。
第二,支持循环迭代与自我纠错。当发现素材不足、数据冲突,系统可以自动回退、补充调研,而不是输出一篇存在硬伤的成品。
第三,图文联动生成。EvidFuse 等 2026 新框架支持写作过程中动态生成图表,写作智能体写到需要数据佐证段落时,即时调用可视化模块,保证图表和正文论点完全匹配,解决传统方案 “先写文字,后配图,图文脱节” 的痛点。
同时,多智能体工作流可以接入私有知识库,企业可上传内部业务数据,智能体基于内部数据 + 公开网络数据联合生成分析报告,适合市场、运营、战略部门高频产出行业简报。
四、落地痛点与工程避坑指南
尽管多智能体自动化报告能力大幅提升,2026 年落地依然存在四大核心瓶颈,也是本次实战中遇到的真实问题。
第一,智能体通信与状态管理复杂。多智能体之间传递大量上下文,token 开销会快速上涨,长任务下成本显著高于单次单模型调用。企业落地时需要设置 token 预算上限,加入缓存机制,复用检索结果,减少重复调用。
第二,工具调用稳定性不足。联网检索、代码绘图存在失败概率,网络超时、网页解析失败会中断流程,需要增加重试、异常捕获、人工断点介入机制。
第三,幻觉无法彻底消除。即使配备独立校验智能体,面对缺少公开权威资料的小众细分领域,依然会出现编造数据,人工终审不可省略,多智能体是高效助手,不是替代分析师。
第四,提示词工程成本高。角色定义、流转规则、校验标准都需要精细化调试,简单复制开源框架,很容易出现智能体越权、任务循环无法终止等问题。
选型层面,个人轻量场景优先低代码多智能体平台,无需编写大量代码,可视化拖拽编排任务;企业生产级场景推荐 LangGraph,状态管理能力强,支持私有部署、数据隔离;快速原型验证可以选用 CrewAI,角色定义简单,上手门槛更低。
五、应用边界与未来演进方向
2026 阶段,这套多智能体工作流最适合标准化调研类任务:行业简报、竞品分析、市场数据复盘、季度业务报告等,任务目标清晰、可验证。不适合高度创意、强主观判断、需要深度行业洞察的专业咨询报告。
从技术演进看,下一阶段 A2A 智能体通信协议标准化,不同厂商模型开发的智能体可以跨平台协同;多模态智能体可以直接读取 PDF、表格、截图,进一步降低前置数据准备工作量。但无论技术如何迭代,人机协同的模式不会改变:人类定义目标、审核结论、把控业务判断,多智能体流水线负责海量资料检索、数据整理、初稿撰写、图表生成等重复性工作。
总而言之,本次实战证明,多智能体协作已经实现调研、写作、数据可视化的端到端自动化。它不是简单的 AI 工具叠加,而是重构报告生产流程。对于内容、市场、数据分析从业者而言,掌握多智能体编排,将大幅压缩资料搜集、绘图、初稿撰写的时间,把精力聚焦在洞察提炼、结论研判等高价值工作上。但从业者必须清醒认知智能体的能力边界,做好人工校验,防范数据幻觉带来的决策风险。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。

评论列表