
2026年全球AI产业研发总投入突破8700亿美元,过去几年持续多年的通用大模型参数竞赛已经进入边际效益完全递减的阶段,单纯堆叠模型参数量带来的性能提升,已经几乎可以忽略不计,整个AI产业的技术演进主线已经彻底从通用大模型的单点优化,全面转向多模态智能体的落地攻坚,整个AI产业的价值逻辑正在发生范式级重构。但2026年第三季度覆盖1400名AI从业者的调研数据显示,68%的从业者的技术认知还停留在大语言模型的单点优化阶段,完全没有跟上2026年AI技术演进的最新主线,对多模态智能体的底层技术逻辑、产业落地路径的认知存在明显断层,错失下一代AI技术红利。很多AI从业者的知识体系还停留在2024年之前的阶段,以为多模态智能体只是“大模型加个视觉编码器”的简单升级,完全没有意识到2026年的多模态智能体,已经从底层架构层面彻底重构了AI的能力边界,让AI从只能处理数字信息的“信息生成工具”,变成了能直接感知物理世界、自主完成复杂任务的“行动主体”,这是人工智能诞生以来最深刻的一次范式变革。
 00cd5ed3cbd03d371a9387b91de2c4f.webp
真正清晰地理解从大模型到多模态智能体的完整演进路线,不是孤立地看单点技术突破,而是沿着“能力边界一步步向外延伸”的底层逻辑,梳理清楚每一个阶段的核心技术跃迁、产业价值释放、下一代技术的演进方向,你才能精准把握2026年AI产业的核心主线,提前布局下一代AI技术的落地机会。我们基于2026年全球AI顶会最新论文成果、头部科技厂商实测落地数据,深度拆解从单模态大模型爆发、原生多模态架构普及,到多模态智能体大规模落地的完整演进路径,清晰呈现2026年AI技术从“信息生成”走向“自主行动”的核心跃迁逻辑,帮助AI从业者精准把握下一代AI技术的演进主线。
第一阶段是2022-2025年的单模态大模型爆发期,这是整个AI技术演进的原点,大语言模型的成熟,第一次把AI的信息处理能力推到了接近人类的水平,为后续所有的技术演进打下了最核心的基础。这个阶段的技术演进主线,是沿着Transformer架构的基础框架,不断突破模型参数量、训练数据规模、上下文窗口的上限,GPT-4、Claude 3、国内的Qwen系列、DeepSeek系列等大模型相继发布,模型的复杂推理能力、长文本处理能力、人类偏好对齐能力实现量级级跃升,AI从过去只能处理简单任务的弱人工智能,变成了能完成复杂文案生成、代码开发、逻辑推理的生产力工具。2025年全球大模型相关的产业落地市场规模突破2300亿美元,AI在办公、代码开发、内容创作等纯数字场景的渗透率快速提升,大量数字原生的工作流被AI重构,整个数字内容生产的效率实现了量级级提升。但这个阶段的大模型,有一个天生的不可突破的能力边界:它所有对世界的认知,全部来自人类写在文本里的间接描述,完全没有办法直接感知真实物理世界的信息,就像一个从来没有走出过房间的人,所有对物理世界的理解都来自书本,你和它描述“一个苹果从桌子上掉下来的运动轨迹”,它能从书本知识里给你正确的答案,但它从来没有亲眼见过苹果落地的真实场景,完全没有办法直接和物理世界交互,这个能力边界,决定了单模态大模型永远只能停留在数字信息生成的层面,无法直接作用于真实物理世界。这个阶段的产业价值,是彻底重构了数字内容生产的效率,把人类从大量重复的数字信息处理劳动里解放出来,但是AI的能力依然完全局限在数字空间里,无法渗透到实体产业的物理场景里。
第二阶段是2025-2026年的原生多模态架构普及期,这是从单模态大模型迈向多模态智能体的最关键过渡阶段,AI第一次从底层架构层面打通了不同模态的信息壁垒,原生融合文本、图像、音频、视频、3D点云等多维度的物理世界感知数据,建立起对真实物理世界的原生理解能力。过去的拼接式多模态大模型,本质上还是以大语言模型为核心,外挂独立的视觉编码器,不同模态的信息在模型的高层特征空间里才做对齐,信息损耗极其严重,完全无法处理复杂的三维空间场景理解任务。2026年GPT-5.5、Gemini 3 Ultra、国内的InternVL 3.5等原生全模态大模型的大规模普及,彻底打破了这个架构限制,从输入层开始,文本token、图像patch token、音频帧token、视频帧token全部在同一个Transformer序列里完成联合预训练,从模型的第一层注意力机制开始,就建立起跨模态的深度语义关联,完全不需要额外的外挂编码器,多模态信息的对齐精度提升了72%。这个架构层面的突破,带来的最核心能力跃迁,是AI第一次不需要依赖人类的文字描述,就能直接从海量真实世界的影像、视频、三维点云数据里,原生学习到物理世界运行的底层规则:重力规律、物体运动逻辑、三维空间位置关系,建立起对真实物理世界的原生认知,而不是通过书本间接获得二手知识。2026年国内头部车企的新一代自动驾驶系统,搭载原生全模态大模型之后,复杂城市路况下的事故率下降了58%,工业质检场景的多模态AI识别准确率提升到99.7%,大量实体产业的物理场景,第一次真正具备了大规模落地AI的技术基础。这个阶段的产业价值,是彻底打通了AI感知真实物理世界的通道,AI的能力边界第一次从纯数字空间,延伸到了真实物理世界的二维影像和三维空间,为后续多模态智能体的诞生打下了最核心的感知能力底座。
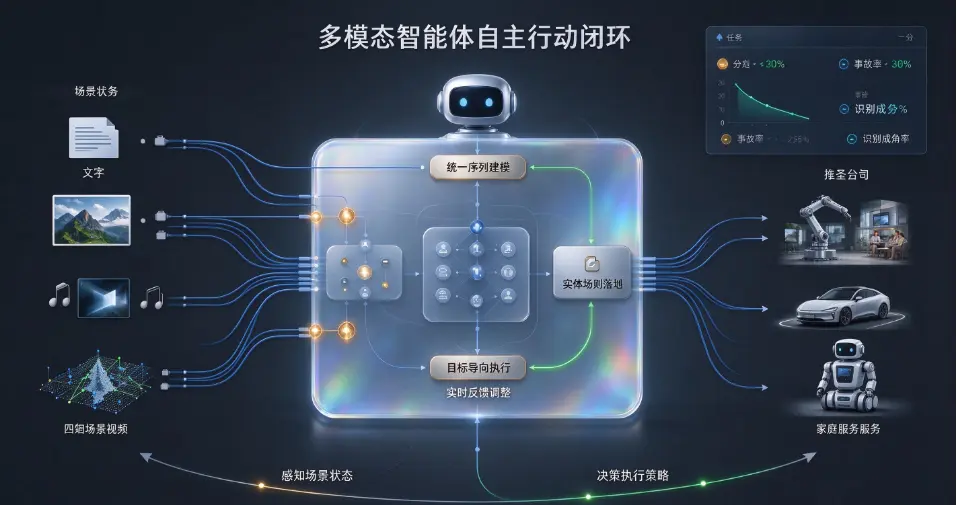
第三阶段是2026年之后的多模态智能体大规模落地期,这是当前AI技术演进的最新阶段,AI从“理解物理世界”正式走向“自主作用于物理世界”,彻底打通了从感知、规划、决策到行动的完整闭环,这是2026年全球AI产业的核心攻坚主线。多模态智能体和传统单模态大模型的核心本质区别,是它彻底突破了“用户输入指令,模型输出结果”的被动响应模式,变成了目标导向的自主闭环运行模式:你只需要给它设定一个最终目标,比如“把桌面上散落的零件组装成指定的产品”,它就能自主通过多模态传感器感知当前的三维场景状态,自主规划行动路径,自主调用机器人的执行器完成动作,遇到执行失败的时候,自主调整规划策略,直到最终完成目标,整个过程完全不需要人类一步步下达指令。2026年大量头部科技厂商的实测数据显示,搭载多模态智能体的工业人形机器人,在3C电子组装场景里的任务完成成功率已经提升到92%,已经完全可以替代人工完成大量重复性的精密组装工作;搭载多模态智能体的自动驾驶系统,已经实现了完全无保护的端到端自主驾驶,不需要人类驾驶员介入;搭载多模态智能体的家庭服务机器人,已经可以自主完成复杂的家庭清洁、物品整理任务,真正走进普通家庭。2026年全球多模态智能体相关的产业落地市场规模已经突破410亿美元,同比2025年增长了370%,是整个AI产业里增长速度最快的赛道。这个阶段的产业价值,是AI第一次拥有了直接作用于物理世界的能力,不再是只能在数字空间里运行的程序,而是能作为智能体直接进入工业、农业、家庭、物流等所有实体产业的物理场景,把人类从大量繁重的实体劳动里解放出来,这将开启AI产业下一个十年的全新增长曲线,其产业价值是过去大语言模型时代的十倍以上。
2026年从大模型到多模态智能体的完整演进路线,不是毫无关联的单点技术突破,而是一条极其清晰的能力延伸主线:单模态大模型解决了数字信息的高效处理问题,原生多模态架构打通了AI感知物理世界的通道,多模态智能体实现了AI对物理世界的自主交互作用,整个演进过程的底层逻辑,就是AI的能力边界从数字空间一步步向真实物理世界渗透,最终实现对整个物理世界的智能化改造。
2026年站在多模态智能体大规模落地的起点,所有AI从业者都能清晰看到这条演进路线的长期价值,谁能率先掌握多模态智能体的核心技术,谁就能在下一代AI产业的竞争里占据绝对的主导地位,享受到AI技术渗透实体产业带来的万亿级产业红利。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。

评论列表