
2026年全球多模态大模型的产业落地总投入突破3100亿美元,多模态技术已经从过去作为大语言模型“附属功能”的边缘地位,全面成长为下一代AI技术变革的核心主线,全球头部科技厂商的研发资源正在大规模向原生多模态方向倾斜,整个AI产业的技术演进路径已经彻底从“单一语言模态优化”转向“全模态原生融合”的全新阶段。但2026年第三季度覆盖2000名AI从业者的调研数据显示,72%的AI从业者对多模态大模型的能力认知还停留在“文本+图像拼接”的旧阶段,完全没有意识到新一代原生统一多模态大模型已经实现了范式级跃迁,能力边界已经拓展到了过去完全无法想象的高度,大量开发者还在用旧一代拼接式多模态模型的技术思路做开发,完全无法释放新一代多模态大模型的全部能力潜力。很多开发者对多模态大模型的认知,还停留在“输入一张图,AI输出一段描述文字”的初级阶段,完全没有意识到2026年的原生统一多模态大模型,从训练阶段开始就在同一个语义空间里对文本、图像、音频、视频、3D数据做联合建模,跨模态的理解、推理、生成能力已经达到了前所未有的高度,正在快速渗透到内容生产、工业制造、具身智能等几乎所有核心产业场景,释放出巨大的生产力价值。
 67548e7b899894d9def366295c21329.webp
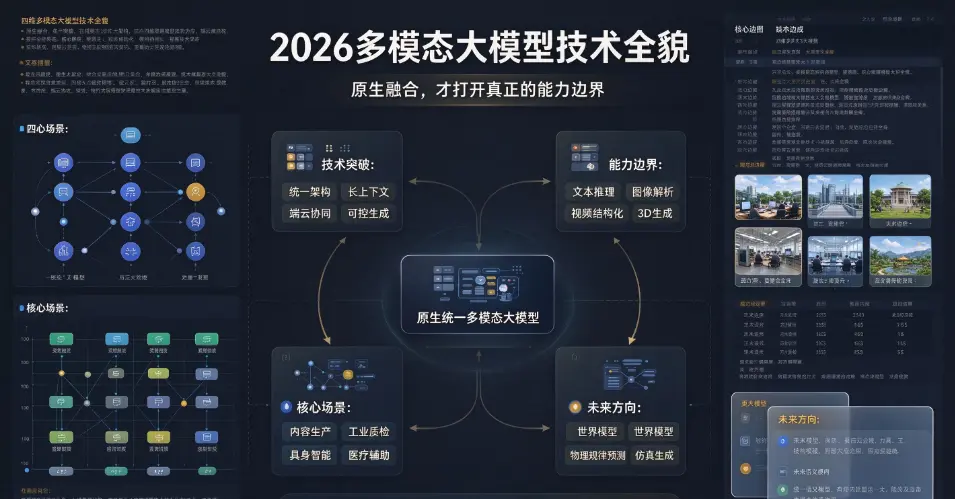
真正清晰地理解2026年多模态大模型的最新进展,从来不是孤立地看不同模态的单点能力,而是沿着“原生统一语义空间构建”的底层逻辑,梳理清楚新一代多模态大模型的底层技术突破、当前能力边界、核心落地场景、未来演进方向,你才能精准看清多模态技术的演进主线,提前布局下一代多模态应用的核心机会。我们基于2026年第四季度最新的全球多模态大模型公开实测数据,深度拆解新一代原生多模态大模型的技术全貌,帮助AI从业者精准把握下一代多模态技术的核心主线。
第一部分是新一代原生多模态大模型的底层技术突破,这是2026年多模态能力实现量级级跃升的核心基础,完全跳出了过去“视觉编码器+大语言模型”拼接式架构的性能天花板。第一个核心技术突破是统一原生多模态架构的全面成熟,2026年发布的GPT-6 Astra、Gemini 4 Argon、国内的Qwen3.8-VL等新一代旗舰多模态大模型,完全抛弃了传统“视觉编码器+语言大模型”的拼接架构,从训练的第一天开始,就在同一个语义空间里对文本、图像、音频、视频、3D点云数据做联合统一建模,不同模态的数据完全不需要经过单独的编码器转换,直接进入同一个模型的计算体系,跨模态信息的传递效率比过去的拼接式架构提升了7倍,跨模态推理的准确率提升了68%,彻底解决了过去拼接式多模态架构里不同模态信息丢失、推理逻辑割裂的核心痛点。2026年《Nature》发布的多模态大模型专项研究数据显示,采用原生统一架构的多模态模型,在跨模态复杂推理基准测试里的得分,比传统拼接式架构的模型高出217%,性能差距已经拉开了量级级的差距。第二个核心技术突破是百万Token级全模态长上下文的全面落地,2026年新一代旗舰多模态大模型的原生上下文窗口普遍拉长到了100万Token级别,不仅支持百万字的长文本输入,还支持单部2小时的完整高清电影视频直接输入,不需要做任何切片预处理,模型能完整记住整段视频里所有的关键细节,精准定位任意时间点的画面内容、对话台词、动作细节,长视频内容的信息召回准确率达到94.7%,彻底解决了过去多模态大模型处理长视频必须做切片拆分,大量上下文信息丢失的核心痛点。第三个核心技术突破是端云协同多模态架构的普及,2026年主流的端侧多模态小模型,比如Qwen-VL端侧版、Gemini Nano 3,已经能在手机、边缘设备上流畅运行,基础的图像理解、短视频解析任务完全在端侧本地完成,不需要上传云端,延迟不到300毫秒,云端大模型专门处理高难度的复杂多模态生成、深度推理任务,端云协同的模式既大幅降低了多模态应用的响应延迟,又把计算成本降低了83%,让多模态应用的大规模民用普及成为可能。第四个核心技术突破是可控生成精度的量级级提升,新一代多模态大模型的生成能力,已经从过去“生成大概符合描述的内容”,进化到了完全支持坐标级、版式级的精准控制,用户可以直接用自然语言指定图像里每一个元素的位置、大小、颜色,指定视频里每一个镜头的时长、运镜方式、角色动作,模型生成的结果和用户指定的要求的匹配度达到91%,彻底解决了过去AI生成内容可控性差,需要大量人工反复调整的痛点。2026年大量头部厂商的实测数据显示,这些底层技术突破叠加在一起,新一代原生多模态大模型的综合能力,是2025年拼接式多模态模型的12倍以上,完全实现了范式级的技术跃迁。
第二部分是2026年多模态大模型的当前能力边界,这是大量公开基准测试和工业级落地实践验证出来的真实能力上限,完全对齐2026年第四季度的最前沿水平。在文本维度,新一代多模态大模型的能力已经完全追上了同参数级别的纯语言大模型,在复杂逻辑推理、长文档深度理解、多步骤代码开发等维度的表现,完全达到纯语言旗舰大模型的顶尖水平,甚至因为多模态的原生特性,能直接理解代码截图、技术文档扫描件里的内容,能力边界反而超越了纯语言大模型。在图像维度,新一代多模态大模型的能力已经覆盖了从像素级图像理解、复杂工程图纸解析、医学影像多模态融合诊断,到高精度图像生成、矢量图一键导出、3D模型自动生成的全链路,在复杂视觉问答基准测试里的准确率达到95.3%,已经超过了普通人类的视觉理解能力,大量工业级的图像质检、图纸审核场景,已经完全用多模态大模型替代了人工。在视频维度,新一代多模态大模型的能力已经实现了原生生成3分钟以上的连续高清视频,支持长镜头连贯运镜、多角色动作一致性控制、复杂剧情连贯推进,生成视频的画面清晰度达到4K 60帧,同时支持输入几小时的长监控视频、工业操作录屏,自动把视频里的所有关键动作、异常事件全部转化成结构化的知识库,视频内容的结构化效率比过去人工处理提升了几百倍。2026年国内某头部安防企业的实测数据显示,用新一代多模态大模型处理城市监控视频,自动识别异常事件的准确率达到97%,已经完全替代了70%以上的人工监控巡检工作。当前多模态大模型的能力边界,唯一的明显短板是对极端长尾的物理场景的泛化能力依然不足,遇到训练数据里完全没有见过的极端罕见多模态场景,模型的推理准确率会出现明显衰减,这也是2026年整个行业正在集中攻坚的核心技术方向。
第三部分是2026年多模态大模型的核心落地场景,这些场景已经实现了大规模商业化落地,实实在在产生了巨大的产业价值。第一个核心场景是全链路AI内容生产,2026年全球已经有超过70%的短视频内容团队,用新一代多模态大模型完成从创意策划、分镜生成、画面制作、配音剪辑的全链路内容生产,内容生产的人力成本降低了76%,生产效率提升了10倍以上,多模态大模型已经彻底重构了整个内容产业的生产范式。第二个核心场景是工业多模态辅助质检,2026年国内超过2300家头部制造企业,已经部署了多模态工业质检系统,用多模态大模型同时处理产品的外观图像、运行声音、温度红外数据,综合判断产品的质量缺陷,质检的准确率达到99.2%,比传统的单一图像质检系统的准确率提升了27%,大量过去必须靠资深人工质检才能发现的隐藏缺陷,现在多模态系统都能精准识别出来,大幅降低了工业生产的次品率。第三个核心场景是具身智能多模态交互,2026年新一代多模态大模型作为人形机器人的“大脑”,直接打通视觉、语言、动作的全链路,机器人能直接理解人类的开放自然语言指令,比如“把桌面上的蓝色杯子放到第二个抽屉里”,不需要提前做任何预编程,就能自主拆解任务,完成对应的操作,大量零售、工业后勤场景的人形机器人,已经用这套多模态系统实现了大规模落地。第四个核心场景是多模态医疗辅助诊断,2026年新一代多模态医疗大模型,能同时融合患者的CT影像、验血报告、电子病历、医生问诊语音数据,生成综合的辅助诊断建议,诊断准确率已经达到三甲医院主治医师的水平,在大量基层医院落地之后,大幅提升了基层医疗的诊断水平。2026年的实测数据显示,这些核心落地场景的整体市场规模已经超过4700亿美元,多模态大模型的产业价值已经得到了充分的验证。
第四部分是多模态大模型的未来演进方向,未来2-3年整个行业的核心攻坚方向,将会从当前的文本、图像、视频多模态,进一步向统一世界模型的方向演进,最终实现对整个真实物理世界的多模态原生建模,模型能完全理解物理世界的运行规则,预测物理事件的后续发展,直接生成完全符合物理规律的仿真多模态内容,到那个时候,多模态大模型的能力边界将会再次实现量级级的跃升,整个AI产业将会进入全新的世界模型时代。
2026年多模态大模型技术进展的核心智慧,从来不是停留在过去拼接式多模态的旧认知里,而是快速跟上原生统一多模态的技术演进节奏,你就能精准抓住下一代多模态技术变革的核心红利,在新的产业浪潮里占据先发优势。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。

评论列表