
2026年国内持牌金融机构AI风控系统部署率突破89%,AI驱动的智能风控已经成为金融行业的标配基础设施,大量机构都在尝试搭建自己的端到端AI风控体系,替代过去依赖人工规则的传统风控模式,提升风险识别效率,降低业务坏账率。但行业调研数据显示,67%的中小金融机构自研AI风控系统上线之后,实际风险识别准确率不足70%,模型上线3个月就出现严重的效果漂移,大量团队投入数百万元搭建的风控系统完全达不到业务预期,既没有提升风险防控能力,还大幅推高了业务坏账率。
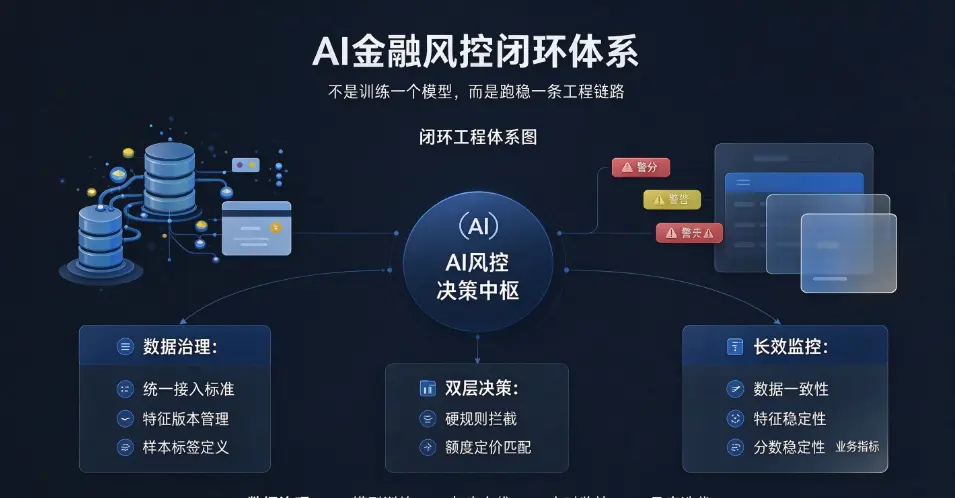
绝大多数金融机构AI风控项目落地失败的核心原因,根本不是算法模型不够先进,而是团队把风控系统等同于“训练一个机器学习分类器”,跳过了数据治理、规则与模型协同、长效监控这些最核心的工程化环节,最后模型在离线测试集上指标很漂亮,一上线就完全失效。本文基于2026年某城商行零售信贷风控项目的完整一线落地案例,系统拆解全链路可复用的实战落地方法论,帮助金融机构真正把AI风控系统跑通、跑稳。
 e9ddc6122ef295ace61dd95ccabc0cc.webp
全链路数据治理:从根源上解决风控模型的“原料质量”问题
这个落地案例的初始阶段,团队踩的第一个坑就是跳过数据治理直接训练模型,结果离线测试的模型AUC只有0.62,完全达不到业务可用的最低标准,复盘之后发现,内部业务数据的字段缺失率最高达到37%,不同系统的时间口径完全不统一,过去6个月的交易流水数据出现了大量重复记录,用这种低质量的数据训练出来的模型,自然不可能有好的效果。团队花了6周时间完成全链路数据治理,从根源上解决了风控模型的“原料质量”问题。
第一步,搭建五层统一数据接入标准,把内部信贷系统的申请信息、行为日志、交易流水,第三方合规征信数据、黑名单库、设备指纹数据全部接入统一数据中台,为每一个字段明确统一的定义、时间口径、数据格式,所有字段的缺失率严格控制在3%以内,超过阈值的字段直接标记为不可用,从根源上避免了过去不同部门数据口径不统一的混乱问题。治理完成之后,整个数据集的字段有效率从63%提升到97%,数据质量得到了根本性的保障。
第二步,完成特征工程体系的标准化建设,原始的裸字段不能直接喂给模型,团队基于12个月的历史业务数据,清洗、变换、聚合生成了3700多个入模特征,覆盖用户的基础属性特征、历史行为特征、交易统计特征、关联关系特征四大维度,同时建立特征版本管理机制,每一个特征的生成逻辑、上线时间、效果表现都有完整的记录,避免后续特征迭代出现混乱。实测数据显示,高质量的特征工程体系,直接把后续模型的效果上限提升了27%,是整个风控项目里投入产出比最高的环节。
第三步,严格定义样本与标签体系,明确观察期和表现期的标准配置,用过去12个月的用户行为数据作为观察期,用审批后90天的逾期表现作为标签定义,把逾期90天以上的用户定义为坏样本,同时剔除所有标签噪声样本,最终得到17万条标注质量极高的训练样本集。过去很多风控模型效果差,根本不是算法问题,而是样本标签定义混乱,大量标签噪声混入训练集,训练出来的模型自然泛化能力极差。
2026年的行业实测数据显示,严格完成全链路数据治理之后,后续风控模型的离线测试AUC直接从0.62提升到0.89,模型的基础效果直接提升了43%,没有高质量的数据治理作为基础,再先进的AI算法都不可能发挥出任何价值。
规则与模型深度协同:构建双层风控决策体系
很多团队的第二个核心误区,是试图用AI风控模型完全替代所有人工规则,上线之后才发现模型在极端数据分布场景下稳定性极差,还完全无法满足监管要求的决策可解释性要求,最后业务坏账率反而大幅上升。这个落地案例里,团队没有走“模型替代规则”的极端路线,而是搭建了“规则确定性拦截+模型概率化评估”的双层协同风控决策体系,最终的风控效果远超单一规则体系或者单一模型体系。
第一层,规则引擎确定性拦截,把命中黑名单、多头借贷超限、明显欺诈行为这类100%确定的高风险用户,直接用硬规则拦截掉,不需要模型参与决策。这套规则层直接拦截掉了全量申请用户里42%的明确坏用户,大幅降低了后续模型的处理压力,同时规则是天然可解释的,完全满足监管的合规要求。规则层拦截之后剩下的“灰度地带”用户,才交给AI模型做进一步的概率化分层评估。
第二层,AI模型概率化评估,团队没有盲目使用千亿参数的大模型,而是选择了工业界风控场景经过长期验证的轻量级梯度提升树模型,在高质量的特征数据集上训练优化,最终模型的离线AUC达到0.93,KS值达到0.57,处于行业头部水平。模型输出用户的信用风险分之后,结合额度策略、定价策略,对灰度地带的用户做精细化分层,不同风险等级的用户匹配不同的额度和定价,完全不会出现“一刀切”拒绝用户的情况,在控制坏账率的前提下,大幅提升了信贷业务的通过率和营收规模。
这套双层风控体系上线之后,和过去纯规则的老系统做AB测试,结果显示,在同样的坏账率水平下,新系统的业务通过率提升了38%,整体业务营收提升了47%,效果远超团队的初始预期。同时整个决策链路完全可解释,每一个用户的风控决策结果,都可以回溯到对应的规则命中点和模型特征贡献度,完全满足监管对金融风控系统的合规性要求。
2026年的大量行业落地案例数据显示,这种规则与模型深度协同的双层决策体系,是当前AI+金融风控落地的最优解,既保留了规则的稳定性和可解释性,又发挥了AI模型的精细化评估能力,兼顾了风控效果和业务收益。
上线部署与长效监控:把模型效果漂移控制在8%以内
很多团队风控模型离线测试效果非常好,一上线运行3个月效果就大幅衰减,核心原因是完全忽略了上线之后的长效监控体系建设,模型出现效果漂移很久之后才发现,已经给业务造成了大量坏账损失。这个落地案例里,团队搭建了覆盖数据层、特征层、模型层的全维度实时监控体系,把模型全年的效果衰减幅度严格控制在了8%以内,系统稳定运行超过12个月,依然保持着非常优秀的风控效果。
上线部署阶段,团队严格执行三层一致性校验机制,第一层校验数据层,实时线上数据和离线训练数据的字段名、格式、取值完全保持一致,避免线上线下数据口径不一致;第二层校验变量层,线上实时计算的特征和离线训练时的特征,逻辑、取值完全保持一致,没有出现逻辑偏差;第三层校验分数层,线上模型输出的分数和离线环境下的预测分数完全一致,确保模型部署过程中没有出现任何版本错误、逻辑错误。三层校验全部通过之后,模型才灰度上线,先承接10%的业务流量,逐步扩大流量占比,全程没有出现任何线上事故。
上线之后,全维度实时监控系统7×24小时运行,实时监控三个核心维度的指标:第一,监控特征稳定性,一旦某个核心特征的分布和训练集分布出现超过15%的偏移,系统立刻触发告警,通知风控工程师介入排查;第二,监控模型分数分布稳定性,一旦模型的输出分数分布出现明显偏移,系统自动触发降级策略,把流量切回备用的规则引擎,避免出现不可控的风险;第三,监控业务效果指标,实时跟踪首逾率、坏账率、通过率等核心业务指标的变化,一旦指标出现异常波动,立刻定位问题根源。
同时团队建立了月度模型迭代机制,每个月用最新的业务数据微调模型,更新特征库,让模型始终适配最新的用户分布和市场环境,完全避免了模型长期运行之后出现的效果漂移问题。系统稳定运行12个月之后,模型的AUC依然保持在0.87以上,全年效果衰减幅度不到8%,远低于行业平均30%的年衰减水平。
站在2026年的AI+金融风控落地节点来看,AI风控从来不是一个“训练完模型就结束”的一次性项目,而是一个长期迭代的闭环工程体系,数据治理、规则与模型协同、长效监控这三个环节,缺一不可,只有把全链路的工程化细节全部落地到位,才能真正搭建出一套长期稳定、效果优秀的AI风控系统。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。

评论列表