
引言
2026 年,大模型行业人才需求结构发生明显变化。两年前掌握提示词技巧就能完成大部分 AI 应用开发,而当下企业招聘大模型工程师,核心考核指标变成系统落地能力:能否搭建稳定的知识库检索、选择合适微调方案、建立自动化评测流水线,并且完成上线后的持续监控与成本管控。单纯会调用 API、写提示词的开发者已经难以满足生产要求。
很多自学开发者陷入碎片化学习陷阱,囤积大量教程与工具,却无法独立交付可上线的大模型应用。其根源在于缺少结构化学习路径,分不清提示工程、RAG、微调各自的适用场景,忽略评测与 MLOps 这两个决定项目能否长期稳定运行的关键环节。
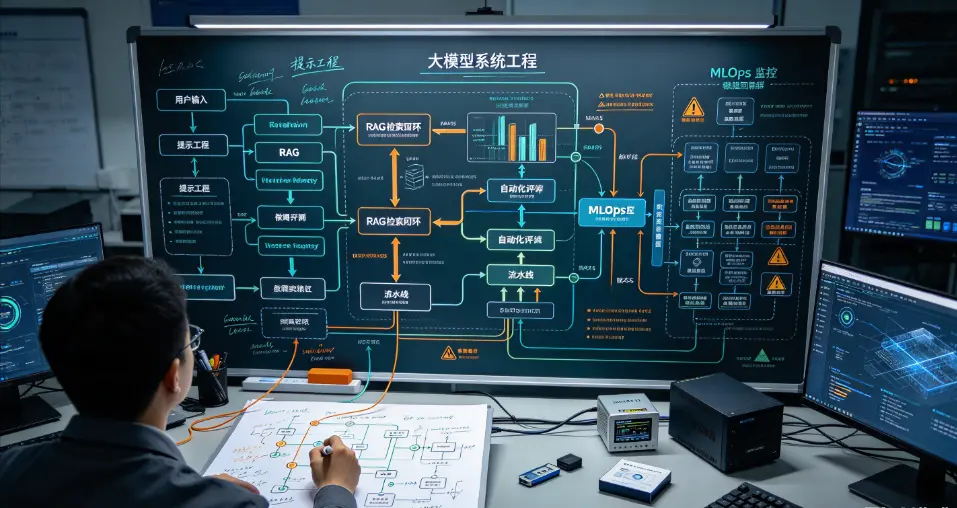
本文基于 2026 年行业落地现状,搭建一套完整的大模型工程师学习地图,按照 “应用层→数据层→模型层→评测层→运维层” 的顺序展开,同时筛选高质量开源项目、框架、数据集资源,给出分阶段学习目标,帮助学习者建立全链路工程能力。
一、提示工程:从 Prompt 模板到上下文工程,应用层的基础能力
提示工程是大模型开发的起点,但 2026 年的提示工程早已不再局限于写一段高质量指令,进化为上下文工程(Context Engineering)。核心不再是 “魔法提示词”,而是上下文窗口管理、指令约束、工具调用、提示注入防护、多轮对话状态管理。
传统提示词技巧,如 Few-shot、CoT 思维链依旧有效,但企业项目更看重鲁棒性。开发者需要掌握结构化输出(JSON/Markdown 格式约束)、Function Calling / 工具调用编排、输入净化、Prompt Injection 注入攻击防御。很多生产故障并非模型能力不足,而是用户恶意输入、超长上下文溢出、上下文信息冲突引发。
学习重点:不要沉迷网上各类万能提示词模板。重点掌握结构化输出、多轮对话状态管理、上下文压缩、输入校验。配套资源推荐:OpenAI Prompt Engineering 指南、Anthropic 提示安全文档、LangSmith 提示调试工具。实战项目:搭建一个带输入过滤、结构化返回的问答机器人,重点测试异常输入下的稳定性。
提示工程的边界要清晰:提示工程只能解决指令引导问题,无法让模型学习大量私有知识,也不能持续稳定固化行业风格,这类场景需要 RAG 或者微调。
 e2970f7fd7d8ac0093d3882d54e129e.webp
二、RAG 检索增强生成:企业落地首选,解决知识滞后与幻觉问题
RAG 是 2026 年企业落地最主流方案,成本可控、迭代灵活,不需要高昂算力,适合私有知识库、文档问答、行业资料检索场景。但很多初学者对 RAG 理解停留在 “文档切片 + 向量库”,真实生产级 RAG 是一套完整检索闭环。
现代 RAG 体系包含文档解析、数据清洗、文本分块策略、Embedding 模型选型、混合检索(BM25 + 向量检索)、重排序 Rerank、上下文压缩、引用溯源、幻觉检测。单一向量检索召回容易出现语义匹配但事实无关的问题,混合检索是 2026 生产环境标配。多模态 RAG 持续普及,支持 PDF 图表、图片、表格文档解析检索,拓展知识库的素材类型。
选型原则:当知识需要频繁更新、需要标注引用来源、禁止模型编造信息,优先选择 RAG。RAG 的短板在于复杂推理、固定输出格式、行业专属风格对齐,这类场景需要微调辅助。
精选资源:LlamaIndex、LangGraph 框架;向量数据库 Chroma、Milvus、Qdrant;评测工具 Arize Phoenix,专门用于 RAG 召回链路调试。实战项目:搭建企业内部文档问答系统,完成召回效果评估、幻觉检测,记录不同分块策略、Embedding 模型带来的召回指标差异。
三、模型微调:高效参数微调为主,掌握场景边界
2026 年,几乎没有企业会从零预训练基座模型,主流方案是高效参数微调 PEFT,以 LoRA、QLoRA 为主,DPO 直接偏好优化逐步替代传统 RLHF,大幅降低偏好对齐成本。微调的核心作用不是灌入海量新知识,而是对齐输出格式、固化行业话术、优化复杂任务推理风格。
很多学习者存在典型误区:遇到知识库需求就直接选择微调。实际上,微调不适合频繁变更的知识,更新知识就要重新训练,成本高、周期长。微调适合:固定输出结构、专业术语风格对齐、复杂工具调用指令优化、特定任务偏好对齐。
学习内容:高质量指令数据集构建、数据清洗与去重、LoRA 参数设置、训练监控、模型合并、量化部署、DPO 偏好优化。算力方面,7B、14B 模型单卡即可完成 LoRA 微调,适合个人练习;70B 大模型微调则需要多卡环境。
精选资源:Hugging Face Transformers、PEFT、TRL 库;开源基座 Qwen3、Llama3;数据集 OpenOrca、UltraChat。实战项目:基于开源基座做行业指令微调,对比微调前后输出格式稳定性,同时评测幻觉率变化。
四、大模型评测:从静态榜单到真实任务自动化评估
评测是 2026 年大模型工程师必备核心能力,也是自学阶段最容易被忽略的环节。传统 MMLU、C-Eval 这类静态榜单只能作为基础参考,静态数据集存在数据污染问题,高分不等于真实业务场景可用。现代评测体系转向业务导向,搭建自动化评估流水线,综合多维度指标。
评测分为四大方向:事实性评测、任务成功率评测、鲁棒性测试、成本与延迟监控。评测手段包含 LLM-as-judge 模型自动打分、人工抽样校验、对抗样本测试、RAG 召回指标、Agent 工具调用成功率。针对 Agent 系统,还需要评估工具调用准确率、任务完整完成率。
学习要点:建立评估集,划分基准版本,每次迭代自动运行评测,记录幻觉率、召回率、响应耗时、Token 消耗。不能依靠单次人工体验判断模型好坏。
精选资源:LangSmith、TruLens、EvalPlus、Helicone;基准数据集 MMMU、SWE-bench、RUT-Bench。实战项目:搭建自动化评测管道,对问答系统批量执行测试用例,自动统计幻觉、召回率指标。
五、MLOps/LLMOps:模型全生命周期运维,支撑规模化生产
当大模型应用进入生产环境,就需要 LLMOps(大模型 MLOps)能力,覆盖版本管理、实验追踪、模型部署、推理优化、可观测性、成本管控、数据漂移监测。2026 年 LLMOps 工具栈持续成熟,推理引擎 vLLM、SGLang 广泛落地,借助 PagedAttention、KV Cache 压缩提升吞吐,降低推理成本。
MLOps 核心工作:数据集版本管理、提示词版本管理、实验记录、模型量化、弹性推理部署、日志追踪、链路可观测、监控 Token 消耗、成本归因、漂移检测。上线后,用户真实对话数据持续回流,需要构建数据回流闭环,迭代优化 RAG 与微调数据集。
很多项目原型效果很好,上线之后因为并发不足、成本过高、无法定位错误链路而失败,根源就是缺少 LLMOps 运维体系。
精选资源:MLflow、Weights & Biases、LangFuse;推理引擎 vLLM、SGLang;容器化 Kubeflow、KServe。实战项目:将前面完成的 RAG 问答系统容器化部署,接入链路追踪,监控延迟、Token 消耗、调用异常。
六、完整学习路线规划与技术选型决策框架
整套学习地图推荐分 4 个阶段推进,循序渐进,避免一开始就啃底层模型理论。
阶段 1(1 个月):基础工程 + 提示工程。掌握 Python、API 调用、结构化输出、提示注入防护,完成简单对话原型。
阶段 2(1.5 个月):RAG 系统开发。学习文档解析、向量检索、混合检索、RAG 评测,交付企业知识库项目。
阶段 3(1.5 个月):微调与评测。学习 LoRA/QLoRA、DPO,搭建自动化评测集,对比 RAG + 微调组合方案效果。
阶段 4(2 个月):MLOps 与项目上线。学习模型部署、推理优化、链路监控,完成端到端可交付大模型应用。
技术选型决策框架(核心判断):
需要频繁更新私有知识、引用资料溯源 → RAG 优先;
需要固定输出格式、行业风格对齐、复杂指令稳定执行 → LoRA 微调;
任务简单、知识量小,仅需要指令约束 → 优化提示工程即可;
上线多用户并发,需要控制延迟、成本、追踪问题 → 配套 MLOps。
2026 年行业主流落地方案,大多是提示工程 + RAG + 轻量 LoRA 微调组合,单一技术很难满足企业复杂需求。
结语
2026 年大模型工程师的核心竞争力,不再是看懂论文、调参技巧,而是系统化工程落地能力。提示工程负责指令约束,RAG 解决私有知识与幻觉,微调优化模型输出风格,评测保证迭代质量,MLOps 保障线上稳定运行。五大模块环环相扣,共同构成完整的大模型应用交付链路。
自学的核心思路,是项目驱动学习,每学完一个模块,就落地一个可运行项目,并且记录指标变化。不要无限囤积教程,脱离项目的理论学习很难转化为求职与工作能力。这套学习地图适配从后端、算法转行的开发者,也适合零基础入门学习者,遵循这套路径,能够避开碎片化学习陷阱,建立企业需要的端到端大模型系统开发能力。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。
评论列表