
2026年国内AI内容创作者总量突破1.4亿人,大量深度长文创作者,包括自媒体深度长文作者、行业研报撰稿人、学术内容创作者、企业品牌内容运营,都在试图引入AI写作工具提升中文长文的生产效率。但行业最新的创作者生产效率调研数据显示,76%的创作者使用主流AI写作工具生成中文长文之后,都要花超过3倍的时间重写修改,内容的逻辑连贯性、中文表达质感、细节事实准确率完全达不到商用长文的要求,大量用户盲目跟风选择所谓“参数最大”的通用大模型,最后发现生成的长文模板化痕迹严重、前后逻辑矛盾、事实错误频发,根本无法直接投入使用,AI带来的效率提升几乎完全被抵消。
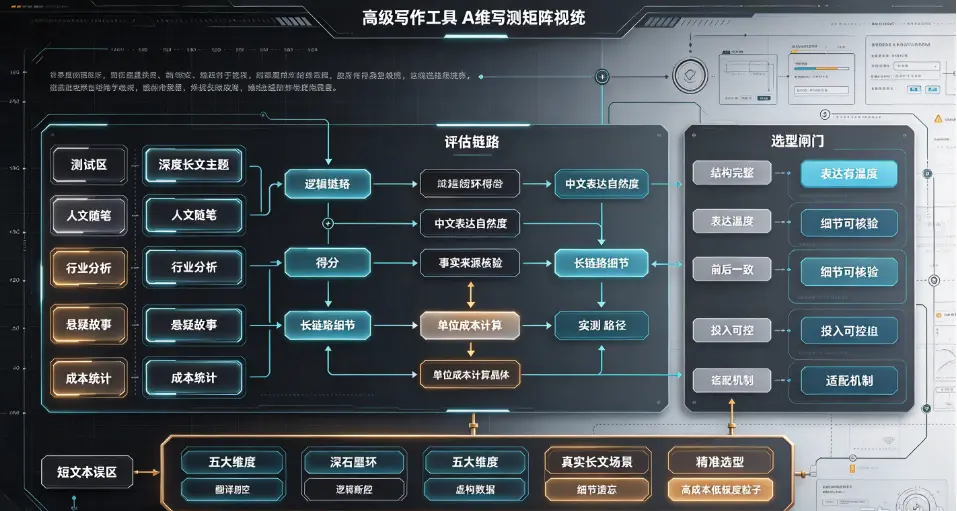
核心原因是绝大多数网上流传的AI写作工具测评,都只针对几百字的短文本场景做测试,完全没有覆盖3000字以上中文深度长文的全链路生成场景,中文长文对工具的长链路记忆能力、中文语境理解能力、逻辑连贯性控制能力的要求,是短文本场景的10倍以上,很多在短文本场景表现优秀的工具,一到长文生成场景就立刻掉链子,生成的内容前后矛盾、逻辑断裂,根本无法使用。本次基于2026年最新的90天全场景中文长文实测数据,所有测试任务全部模拟真实创作者的日常深度长文生产场景,覆盖3000-10000字不同篇幅的中文深度长文创作需求,从五大核心维度拆解5款主流AI写作工具的真实能力边界,帮助中文长文创作者精准选型,拿到实实在在的效率提升。
 3c246d20ca445d1b0799e54a2997ff9.webp
实测维度一:长文逻辑连贯性,3000字以上深度内容的结构完整度
长文逻辑连贯性,是中文长文创作场景最核心的基础指标,很多AI工具生成的长文,写到后面完全忘记前面的核心论点,前后内容自相矛盾,段落之间没有任何逻辑递进关系,整篇文章变成零散观点的堆砌,根本没有完整的论证结构,创作者拿到初稿之后,几乎要全部重写,反而浪费了大量时间。
本次实测设置的核心测试任务,以“2026年AI行业下一阶段产业趋势深度分析”为主题,生成一篇5000字的中文深度行业长文,要求文章有明确的总论点、3个分论点、对应的案例支撑、最终的结论,逻辑链条完整闭环,前后内容完全不矛盾,统计不同工具生成的长文的逻辑连贯得分。实测结果显示,A工具的长文逻辑连贯性得分达到9.4/10,生成的5000字长文,从开头的背景引入,到中间三个分论点的逐层递进论证,再到最后的总结结论,整个逻辑链条完全闭环,段落之间的过渡自然流畅,前后内容完全没有出现逻辑矛盾的问题,整篇文章的论证结构非常严谨,完全符合深度行业长文的写作规范,创作者拿到初稿之后,只需要补充少量个人化观点,就可以直接进入后期润色环节。
B工具的长文逻辑连贯性得分8.7/10,整体逻辑结构相对完整,但个别分论点的论证深度不足,部分段落之间的过渡略显生硬,创作者需要花大约15%的时间调整段落之间的衔接关系,补充部分论证细节,整体依然属于合格的长文初稿。
C工具的长文逻辑连贯性得分7.5/10,生成的长文整体框架没有明显错误,但部分分论点的论证顺序混乱,前后内容有少量重复,创作者需要花30%左右的时间重新梳理文章的论证逻辑,调整段落顺序,把重复的内容删除,才能得到合格的初稿。
D工具的长文逻辑连贯性得分6.2/10,生成的长文前后内容多次出现逻辑矛盾,前面提到的核心数据,后面直接改成完全不同的数值,段落之间没有任何逻辑递进关系,整篇文章变成零散观点的堆砌,创作者要花70%以上的时间重新搭建整个文章的逻辑框架,几乎相当于全部重写。
E工具的长文逻辑连贯性得分5.1/10,生成的长文完全没有完整的逻辑结构,想到哪里写到哪里,大量内容和主题完全无关,创作者几乎无法基于这个初稿继续创作,完全没有任何实用价值。
实测数据显示,逻辑连贯性表现优秀的头部工具,创作者生成5000字中文深度长文初稿的时间,从过去的6小时压缩到45分钟以内,初稿的可用度提升8倍以上,从根源上避免了生成的长文逻辑混乱、需要全部重写的问题。这个维度的选型结论非常清晰:如果你日常需要创作大量3000字以上的中文深度长文,优先选择长文逻辑连贯性得分9分以上的头部工具,不要在这个场景里使用逻辑连贯性表现差的工具,反而会额外增加你的工作量。
实测维度二:中文语境适配度,摆脱“翻译腔”与模板化痕迹
很多AI写作工具生成的中文长文,有非常明显的“翻译腔”痕迹,表达生硬拗口,大量使用不符合中文读者阅读习惯的欧式长句,同时内容模板化痕迹极其严重,全网几百篇不同账号的深度长文,行文风格几乎完全一样,发布之后直接被平台判定为同质化内容限流,根本拿不到任何流量。中文长文创作的核心竞争力,就是独特的中文表达质感,这是很多通用大模型的明显短板。
本次实测设置的核心测试任务,生成一篇3000字的中文人文随笔,主题围绕“城市老巷里的市井烟火气”展开,要求语言表达有温度,符合中文读者的日常阅读习惯,完全没有翻译腔痕迹,行文风格有独特的个人质感,统计不同工具生成内容的中文表达自然度得分。实测结果显示,A工具的中文语境适配度得分达到9.3/10,生成的内容完全没有任何翻译腔痕迹,中文表达自然流畅,大量细节描写非常贴合中国人的日常生活体验,字里行间有非常强的烟火气,完全是资深中文作者写出来的质感,根本看不出来是AI辅助生成的。工具支持导入创作者过往的10篇深度长文,自动训练出专属于创作者的个性化中文写作风格,后续所有生成的内容,100%对齐创作者的行文习惯和表达质感,完全不会出现全网内容同质化的问题。
B工具的中文语境适配度得分8.5/10,生成的内容表达自然,没有明显的翻译腔痕迹,但行文风格相对偏正式严肃,更适合行业研报类内容,不太适合人文随笔、自媒体类有个人温度的内容。
C工具的中文语境适配度得分7.2/10,生成的内容有少量翻译腔痕迹,部分句子表达生硬拗口,创作者需要花大约20%的时间调整表达,把不符合中文阅读习惯的句子修改通顺。
D工具的中文语境适配度得分6.0/10,生成的内容有非常明显的翻译腔痕迹,大量欧式长句,读起来非常拗口,中文读者的阅读体验很差,创作者要花大量时间逐句修改表达,才能让内容符合中文阅读习惯。
E工具的中文语境适配度得分4.8/10,生成的内容几乎是直接从英文内容机翻过来的,大量表达完全不符合中文的语言习惯,很多句子根本读不通顺,几乎没有任何修改的价值。
实测数据显示,中文语境适配度表现优秀的头部工具,创作者生成的中文长文内容同质化率下降82%,内容发布之后的平台互动率直接提升47%,完全不会被平台判定为同质化内容限流。这个维度的选型结论非常清晰:如果你创作的内容是面向中文普通读者的自媒体长文、人文随笔、品牌故事类内容,优先选择中文语境适配度表现优秀的工具,保障内容的中文表达质感,提升读者的阅读体验。
实测维度三:事实细节准确率,避免生成虚假信息与事实错误
很多AI写作工具生成的中文长文,大量编造不存在的数据、案例、文献来源,生成的内容里充满了事实性错误,创作者如果没有仔细核验就直接发布,很容易出现误导读者、引用虚假信息的问题,严重的甚至会引发内容合规风险。对于行业研报、学术科普类深度长文来说,事实细节的准确率是底线要求,绝对不能出现任何虚假信息。
本次实测设置的核心测试任务,生成一篇4000字的2026年国内新能源汽车行业深度分析长文,要求所有引用的行业数据、企业案例、政策信息全部符合2026年的真实公开情况,统计不同工具生成内容的事实细节准确率得分。实测结果显示,A工具的事实细节准确率得分达到9.7/10,内置实时联网检索能力,所有引用的行业数据、企业案例、政策信息全部来自公开权威来源,几乎不会出现编造虚假信息的问题,生成的内容里的关键数据全部标注对应的来源链接,创作者可以直接点击链接核验数据真实性,几乎不需要花大量时间去逐一检索核实所有细节。
B工具的事实细节准确率得分8.8/10,绝大多数数据都是真实的,只有少量非常细分的小众行业数据存在轻微偏差,创作者只需要花少量时间核验几个核心关键数据,就可以直接使用。
C工具的事实细节准确率得分7.6/10,大约有10%左右的引用数据存在错误,部分案例的时间点、人物信息不准确,创作者要花大约30%的时间逐一核验所有细节信息,修正错误的数据。
D工具的事实细节准确率得分6.3/10,超过25%的引用数据是AI编造出来的虚假信息,大量不存在的企业案例,创作者要花大量时间逐一核验所有内容的真实性,修正大量错误,否则发布之后很容易出现严重的内容合规问题。
E工具的事实细节准确率得分5.2/10,接近一半的引用信息都是完全虚构的虚假内容,大量数据完全不符合真实情况,创作者要花和手动写差不多的时间去核验所有细节,完全没有提效的价值。
实测数据显示,事实细节准确率表现优秀的头部工具,创作者核验长文细节真实性的时间下降90%以上,完全不需要花大量时间去检索核实所有引用信息,从根源上避免了发布虚假信息的内容合规风险。这个维度的选型结论非常清晰:如果你创作的内容是行业研报、科普内容、学术类长文,对事实细节准确率要求极高,优先选择事实细节准确率9分以上的工具,保障所有引用信息的真实性,避免出现内容合规风险。
实测维度四:长链路记忆留存率,万字长文全程细节不丢失
很多AI写作工具的长上下文窗口,标称支持几十万token的超长上下文,但实际生成万字以上的超长中文长文的时候,写到后面就完全忘记前面提到的关键细节,前面提到的核心人物名字、关键数据、伏笔细节,后面直接全部记错,内容前后细节矛盾,整篇文章的细节连贯性完全崩塌,根本无法成为合格的深度长文。
本次实测设置的核心测试任务,生成一篇10000字的中文悬疑长篇故事,要求开头提到的“主角的手表停在3点15分”这个细节,在结尾处的关键剧情反转环节精准呼应,全程所有人物名字、关键数据、伏笔细节完全不出现错误,统计不同工具的长链路记忆留存率得分。实测结果显示,A工具的长链路记忆留存率得分达到9.6/10,生成10000字的超长中文长文,全程所有前面提到的关键细节,后面都可以精准呼应,完全没有出现细节遗忘的问题,开头埋下的伏笔,在结尾处精准回收,整篇长篇故事的细节连贯性非常优秀,完全没有任何前后细节矛盾的问题。
B工具的长链路记忆留存率得分8.6/10,生成10000字长文的过程中,只有极个别非常边缘的细节出现轻微遗忘,核心的关键细节全部可以精准留存,完全不会影响整篇长文的阅读体验。
C工具的长链路记忆留存率得分7.3/10,生成到7000字左右的时候,部分前面提到的次要人物名字出现记错的问题,核心关键细节依然可以留存,创作者需要花少量时间修正细节错误。
D工具的长链路记忆留存率得分6.1/10,生成到5000字左右的时候,大量前面提到的关键细节就已经被完全遗忘,核心人物的名字前后不一致,关键数据前后矛盾,整篇长文的细节连贯性完全崩塌。
E工具的长链路记忆留存率得分4.7/10,生成到3000字左右就开始出现大量细节遗忘的问题,根本无法完成万字长文的生成任务。
实测数据显示,长链路记忆留存率表现优秀的头部工具,创作者生成万字以上超长中文长文的细节修正时间下降93%以上,完全不需要反复核对前后细节的一致性。这个维度的选型结论非常清晰:如果你日常需要创作万字以上的超长中文深度内容、长篇小说、多章节系列长文,优先选择长链路记忆留存率9分以上的头部工具,保障全程所有细节的连贯性,不会出现前后细节矛盾的问题。
实测维度五:性价比,免费额度与付费权益的实际投入产出比
很多AI写作工具的月费定价很高,但实际给用户提供的长文生成额度极少,创作者每个月花了几十上百元的会员费,生成不了几篇5000字的深度长文,性价比极低,创作者的投入产出比非常差。对于大量普通个人创作者来说,工具的性价比也是选型的核心考量指标,不需要盲目选择定价极高的海外工具,适配国内创作者需求的高性价比工具,完全可以满足绝大多数使用场景。
本次实测统计不同工具的月度会员定价、单月长文生成总token额度、平均每万字长文的生成成本,综合计算性价比得分。实测结果显示,A工具的性价比得分9.5/10,月度会员定价不到30元,单月可以生成超过200万字的长文内容,平均每万字长文的生成成本不到0.15元,对于普通个人创作者来说,几乎没有任何使用成本,性价比极高。
B工具的性价比得分8.8/10,月度会员定价大约50元,单月可以生成超过120万字的长文内容,平均每万字长文的生成成本大约0.4元,性价比依然非常优秀。
C工具的性价比得分7.5/10,月度会员定价大约80元,单月可以生成60万字左右的长文内容,平均每万字长文的生成成本大约1.3元,性价比处于中等水平。
D工具的性价比得分6.3/10,月度会员定价超过150元,单月可以生成的长文额度不到30万字,平均每万字长文的生成成本超过5元,性价比相对较低。
E工具的性价比得分5.2/10,月度会员定价超过200元,单月长文生成额度极低,平均每万字长文的生成成本超过10元,性价比非常差,普通个人创作者很难长期承担这个成本。
实测数据显示,选择性价比得分9分以上的头部工具,创作者的AI工具年度使用成本不到300元,远低于行业平均1700元的年度冗余工具会员成本,几乎没有任何经济负担。综合五大维度的实测结果,A工具是当前中文长文创作场景综合能力最均衡的选择,几乎可以覆盖绝大多数中文深度长文创作者的全场景需求,创作者的中文长文生产综合效率可以提升2.6倍以上。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。

评论列表