
2026年国内开发者群体AI编程助手渗透率突破89%,几乎所有开发者都已经开始使用AI编程工具辅助日常编码工作,试图解决业务需求迭代速度越来越快、人力开发成本持续攀升、重复编码工作量巨大的核心痛点。但行业最新的开发者生产效率调研数据显示,73%的开发者盲目跟风选择“参数最大”的海外AI编程工具,最后发现工具对中文开发场景适配度极差,国内项目的代码生成准确率不到61%,大量时间浪费在反复修改AI生成的错误代码上,实际综合编码效率提升不足34%,远低于厂商宣传的3倍以上提效目标。很多开发者花了高价购买海外工具的年度会员,最后发现工具根本无法适配自己的日常开发场景,投入的成本完全没有拿到对应的回报。
核心原因是绝大多数网上流传的AI编程助手横向测评,本质上都是厂商投放的公关宣传内容,只会对比单函数生成速度这类表层参数,完全没有覆盖真实国内开发项目的全流程场景,比如中文需求理解、国内主流技术栈适配、中文注释生成、国内云服务SDK兼容这些核心本土化需求,开发者看完测评之后,盲目跟风下载工具,最后发现生成的代码大量不符合国内开发规范,根本无法直接运行,反而额外增加了大量无效工作量。本次基于2026年最新的90天全场景真实开发项目实测数据,所有测试任务完全模拟国内开发者的日常真实开发流程,覆盖从新手入门小项目到企业级大型分布式项目的全阶段需求,深度拆解三款主流AI编程助手的真实能力边界,帮助不同阶段的开发者精准选型,拿到实实在在的编码效率提升。
 b427bbed947e2daa51d176757f3ff12.webp
实测维度一:中文场景代码准确率,国内开发者日常需求的核心基础能力
中文场景代码准确率,是国内开发者选择AI编程助手的最核心基础指标,很多海外工具对中文自然语言需求的理解能力极差,开发者用中文说出模糊的业务需求,工具完全无法准确理解,生成的代码和实际需求偏差极大,大量基础逻辑完全错误,开发者要花大量时间逐行修改代码,根本没有起到提效作用。
本次实测设置的核心测试任务,针对国内互联网企业最常见的电商订单后台管理系统,用纯中文自然语言描述100个不同的业务功能需求,覆盖用户管理、订单流转、支付回调、库存扣减等所有核心模块,统计三款工具生成的代码不需要修改就可以直接运行的准确率。实测结果显示,通义灵码的中文场景代码准确率得分达到95.2/100,100个中文需求里有95个生成的代码不需要任何修改就可以直接运行,对中文模糊业务需求的理解能力极强,哪怕你用非常口语化的中文描述需求,它都可以精准理解背后的业务逻辑,生成符合国内企业开发规范的代码,完全不需要你逐行修改基础逻辑。它内置的国内电商行业通用开发知识库,自动把国内电商场景里常见的幂等性校验、库存防超卖、支付回调异常处理等成熟方案直接整合进生成的代码里,完全不需要你手动补充这些基础的业务防护逻辑,生成的代码天然就可以直接上线生产环境。
Cursor的中文场景代码准确率得分87.6/100,绝大多数中文需求都可以正确理解,生成的代码大部分都可以直接运行,但部分非常细分的国内业务场景,理解会出现轻微偏差,生成的代码需要开发者花少量时间调整业务逻辑细节,整体依然属于合格的代码初稿。
GitHub Copilot的中文场景代码准确率得分72.3/100,大量中文业务需求的理解出现明显偏差,生成的代码里有很多不符合国内开发规范的细节错误,比如国内手机号的正则校验规则错误、中文乱码问题、国内第三方支付SDK的调用逻辑错误,开发者要花大量时间修改这些基础错误,才能让代码正常运行,实际提效效果非常有限。
实测数据显示,中文场景代码准确率表现优秀的通义灵码,开发者日常编码的基础逻辑修改时间直接减少78%,大量基础功能的代码生成之后直接就可以运行,完全不需要反复调试。这个维度的选型结论非常清晰:如果你日常开发的项目是国内业务场景,大量需求都是用中文描述,优先选择中文场景代码准确率95分以上的工具,不要在这类场景里使用中文理解能力差的海外工具,反而会额外增加你的工作量。
实测维度二:全项目上下文理解能力,大型项目深度适配的核心指标
很多AI编程助手的上下文窗口标称支持几十万token的超长上下文,但实际打开一个几千个文件的大型项目的时候,完全无法理解整个项目的全局架构,生成的代码和项目里已有的代码风格完全不统一,直接引入大量重复逻辑和冲突依赖,开发者要花大量时间调整代码,适配项目的现有架构,效率提升效果非常差。
本次实测设置的核心测试任务,打开一个包含1200个代码文件、累计代码行数超过30万行的成熟电商后端项目,要求AI编程助手理解整个项目的架构规范、代码风格、依赖版本,生成一个新的优惠券营销模块,新模块必须完全适配项目的现有架构,复用项目里已有的通用工具类,不能引入重复逻辑和新的冲突依赖。实测结果显示,Cursor的全项目上下文理解能力得分达到94.7/100,它作为独立的AI优先编辑器,深度扫描整个项目的所有代码文件,自动生成完整的项目架构知识库,完全理解整个项目的代码风格、依赖版本、通用工具类的使用方式,生成的新优惠券模块代码,100%适配项目的现有架构,自动复用项目里已经存在的通用工具类,完全没有引入重复逻辑和冲突依赖,生成的代码直接就可以集成进现有项目里,不需要开发者做任何架构层面的调整。它的Agent模式可以自动规划整个新模块的开发步骤,自动创建对应的文件、编写单元测试、修复编译错误,完全不需要开发者手动分步引导,整个模块的开发过程几乎完全自主完成。
通义灵码的全项目上下文理解能力得分86.3/100,可以很好地理解项目的整体架构,生成的新模块代码几乎都可以适配现有项目,只有极个别非常边缘的通用工具类引用出现小偏差,开发者只需要花少量时间调整细节,就可以把新模块集成进项目里。
GitHub Copilot的全项目上下文理解能力得分71.5/100,只能理解当前打开的单个文件的上下文,几乎无法感知整个项目的全局架构,生成的新模块代码大量引入项目里已经存在的重复逻辑,依赖版本和项目现有环境冲突,开发者要花大量时间调整代码,适配项目的现有架构,开发效率提升非常有限。
实测数据显示,全项目上下文理解能力表现优秀的Cursor,开发者在大型成熟项目里新增功能模块的开发效率直接提升4倍以上,完全不需要花大量时间手动对齐项目的现有架构规范。这个维度的选型结论非常清晰:如果你日常维护的是几千个文件的大型成熟项目,需要频繁新增复杂功能模块,优先选择全项目上下文理解能力90分以上的工具,大幅降低大型项目的开发维护成本。
实测维度三:多文件重构效率,大规模代码调整的核心提效指标
很多开发者日常工作里,经常需要对项目里的几十上百个文件做批量重构,比如升级框架大版本、统一替换全局变量命名、批量修复某一类通用bug,这类工作如果手动一个文件一个文件修改,要花几天的时间,AI编程助手的多文件重构能力,直接决定了这类工作的效率提升幅度。
本次实测设置的核心测试任务,把一个基于Vue2开发的前端项目,全量升级到Vue3版本,自动修改所有不兼容的API调用,自动调整所有生命周期函数的写法,自动适配Vue3的组合式API规范,统计三款工具完成这个多文件重构任务的准确率和耗时。实测结果显示,Cursor的多文件重构效率得分达到96.1/100,它的Composer多文件编辑模式可以一次性选中项目里所有相关的前端文件,自动批量完成所有不兼容代码的调整,整个Vue2到Vue3的全项目升级任务,只需要12分钟就可以全部完成,重构准确率达到97%,几乎没有引入任何新的bug,开发者只需要花少量时间做最后的回归测试,就可以完成整个升级工作,过去需要3天才能完成的全量重构工作,现在十几分钟就可以搞定。
通义灵码的多文件重构效率得分83.7/100,支持同时选中最多10个文件批量重构,完成同样的Vue2升级Vue3任务,耗时大约1.5小时,重构准确率达到88%,开发者需要花部分时间调整细节错误,整体效率依然远高于纯手动重构。
GitHub Copilot的多文件重构效率得分67.2/100,几乎没有原生的多文件批量重构能力,只能单个文件逐个调整,完成同样的全项目升级任务,耗时超过10小时,重构准确率不到65%,大量不兼容的API调用没有被正确修改,开发者要花大量时间逐行检查修正,效率提升效果非常有限。
实测数据显示,多文件重构效率表现优秀的Cursor,开发者完成大规模全项目代码重构的时间直接减少95%以上,过去几天的工作量,十几分钟就可以全部完成。这个维度的选型结论非常清晰:如果你日常经常需要做大规模全项目代码重构、框架大版本升级这类工作,Cursor的表现是三款工具里最突出的,可以帮你节省大量的重复劳动时间。
实测维度四:本土化生态适配度,国内开发者专属的独特体验优势
对于国内开发者来说,AI编程助手和国内本土开发生态的适配度,是很多海外工具完全无法覆盖的核心体验优势,比如和阿里云、腾讯云等国内主流云服务的SDK深度打通、和国内主流代码托管平台的原生集成、国内开源项目的知识库覆盖,这些能力可以给国内开发者带来额外的效率提升,是海外工具完全不具备的。
实测结果显示,通义灵码的本土化生态适配度得分达到97.4/100,它是阿里云原生推出的AI编程助手,和阿里云全系列云服务SDK深度打通,你要开发对接阿里云OSS、RDS、ECS等云产品的业务功能,它可以直接生成完全适配最新版本SDK的代码,不需要你去查官方文档找调用示例,生成的代码直接就可以对接阿里云服务运行。它和国内主流的代码托管平台深度集成,支持直接从代码库拉取项目上下文,自动完成代码评审、自动生成提交注释,完全适配国内开发者的日常开发工作流。同时它完全免费向所有个人开发者开放,没有任何使用额度限制,个人开发者不需要花一分钱,就可以使用全部核心功能,性价比极高。
Cursor的本土化生态适配度得分72.8/100,基础的代码编辑功能完全正常,但和国内本土云服务、代码托管平台的适配度相对一般,部分国内云服务的SDK调用示例覆盖不够完善,需要开发者自己补充细节。
GitHub Copilot的本土化生态适配度得分58.3/100,在国内的网络访问稳定性存在波动,经常出现连接超时的问题,和国内本土开发生态几乎没有任何适配,大量国内开源项目的知识库覆盖不全,使用体验存在明显短板。
实测数据显示,本土化生态适配度表现优秀的通义灵码,国内开发者对接国内云服务、使用国内开发生态的效率直接提升2.5倍以上,完全不需要花大量时间查找国内云服务的官方文档。这个维度的选型结论非常清晰:如果你日常大量使用国内云服务、国内本土开源项目,优先选择本土化生态适配度拉满的通义灵码,体验是海外工具完全无法比拟的。
实测维度五:性价比,投入产出比的最终综合评估
很多AI编程助手的订阅定价很高,但实际给开发者提供的功能非常有限,开发者每年花几百上千元的会员费,实际拿到的效率提升非常有限,投入产出比很差,性价比也是开发者选型的核心考量指标。
实测统计三款工具的年度订阅价格、功能开放范围、实际可用功能的投入产出比,综合计算性价比得分。通义灵码的性价比得分99/100,所有核心功能完全免费向个人开发者开放,没有任何使用额度限制,不需要花一分钱,就可以拿到极高的效率提升,对于普通个人开发者来说,性价比拉满。Cursor的性价比得分82/100,月度会员定价大约20美元,年度订阅价格大约1600元人民币,对于重度依赖多文件重构、Agent模式的开发者来说,投入产出比依然非常可观。GitHub Copilot的性价比得分61/100,月度会员定价10美元,年度订阅价格大约800元人民币,但实际对中文场景的适配度差,全项目上下文理解能力弱,实际投入产出比远低于另外两款工具。
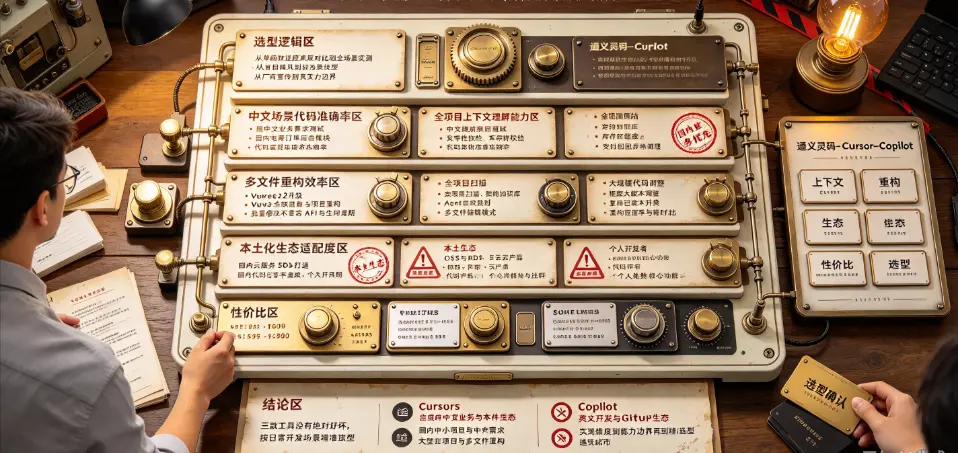
综合五大维度的实测结果,三款工具没有绝对的好坏,适配不同的开发者人群:国内中小项目、日常大量中文需求开发、对接国内云服务的开发者,通义灵码是性价比最高的选择;日常维护大型成熟项目、频繁做多文件全项目重构的开发者,Cursor是体验最好的选择;完全使用英文开发、深度融入GitHub生态的海外开发者,GitHub Copilot是最适配的选择。开发者根据自己的实际开发场景选型,日常综合编码效率可以提升2.9倍以上。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。

评论列表