投研工作是典型的复合型复杂任务:需要搜集行业新闻、财报、券商研报,提取财务指标,做指标测算、图表可视化,交叉验证多方信息,评估风险,最后整合形成结构化报告。传统单大模型 + 提示词的方案,很难同时兼顾资料检索、数理计算、事实校验、逻辑评审,容易出现数据错误、引用缺失、片面结论。而多智能体协作,把不同专业能力拆成独立角色,智能体之间对话辩论、互相校验,模拟真实投研小组工作模式。2026 年 AutoGen(AG2)新版重构底层架构,事件驱动异步群组对话、自动发言人选择、内置代码执行沙箱、可观测追踪能力大幅增强,让搭建投研 AI 团队的难度显著下降。
 bed7b44155c914c596eb220229bcdb6.webp
一、AutoGen 投研多智能体的底层原理与角色架构
AutoGen 核心思想是对话式编程(Conversation Programming),区别于固定顺序的线性工作流,多个可对话智能体在 GroupChat 群组内自由交互,由 GroupChatManager 负责调度,自动判断下一个发言角色,直到满足终止条件。每个智能体拥有独立系统提示词、独立记忆、独立能力边界,各司其职,而非单一模型包揽全部任务。
针对投研场景,我们设计 5 个角色的 AI 团队,搭配用户代理(UserProxyAgent)作为人工介入入口:
规划 Agent(Planner):任务拆解。接收投研需求,把研究目标拆分为子任务清单,定义研究维度、数据清单、报告框架,输出投研执行计划。
信息检索 Agent(Researcher):资料搜集。调用搜索工具、知识库接口,抓取行业公告、财报原文、公开研报,记录原文来源链接,收集原始素材,重点保留可溯源引用。
财务数据分析师 Agent(Data Analyst):数据提取与计算。读取原始财报数据,编写 Python 代码在沙箱内执行,计算营收增速、毛利率、净利率、估值指标,生成可视化图表,输出量化结果。AutoGen 内置代码执行沙箱,隔离运行环境,避免代码执行带来的安全风险。
风控评审 Agent(Critic):交叉核验。这是投研团队最重要的质量把关角色。核对数据来源、检查计算逻辑,查找事实矛盾、信息缺失、片面假设,识别模型幻觉,提出质疑与修正意见,返回给检索和分析师迭代优化。
报告撰写 Agent(Writer):文稿合成。在经过多轮校验的素材基础上,按照标准投研模板,撰写摘要、行业分析、财务分析、风险提示、结论,输出完整 Markdown 报告。
UserProxy 代理:人工入口,支持 HITL(Human-in-the-Loop),在关键节点暂停流程,人工补充信息、审核结论、终止任务,这对于高风险投研场景必不可少。
群组对话管理器 GroupChatManager 负责协调轮次,根据对话上下文动态选择下一个发言智能体,而不是固定顺序执行。当评审 Agent 确认信息充分、无明显漏洞,触发终止词,自动结束对话并输出最终报告。
二、完整工作流:从需求输入到投研报告输出
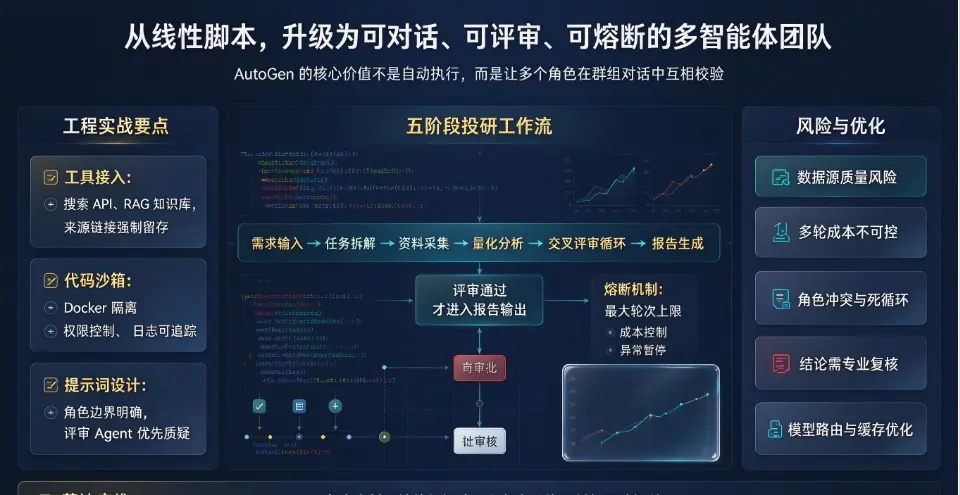
整套投研智能体团队的执行流程分为 5 个阶段。
第一阶段:任务拆解。用户输入投研需求,规划 Agent 输出研究框架,定义研究范围、数据维度、报告结构。如果需求模糊,规划 Agent 会主动提问,确认研究边界、时间区间、重点关注指标。
第二阶段:资料采集。检索 Agent 调用搜索工具、RAG 私有知识库,搜集公开资料,标注来源链接,把原始素材送入群组对话。遇到信息不足时,自动发起二次检索。
第三阶段:量化分析。数据分析师提取素材内财务指标,编写 Python 代码,在沙箱执行计算、绘图,输出指标表格与可视化图表,把计算结果和代码日志返回群组。
第四阶段:交叉评审循环。评审 Agent 逐项核查数据、引用、假设,标记矛盾点、缺失信息、逻辑漏洞。如果发现问题,对话回到检索或分析师环节,补充资料、重算指标,多轮迭代,直到评审 Agent 认可素材可信度。这一步是多智能体相比单 Agent 最大优势,通过内部辩论抑制幻觉。
第五阶段:报告生成。撰写 Agent 整合全部校验后的素材、数据图表、风险评估,输出标准化投研报告,支持 Markdown 格式,包含摘要、正文、数据附表、参考文献。
2026 版 AG2 的新特性极大优化这套流程:异步消息通信提升多轮对话效率;内置 OpenTelemetry 链路追踪,记录每一轮智能体消息、工具调用、token 消耗;增加任务迭代上限与熔断机制,防止无限循环辩论,控制成本。
三、核心工程实战要点:工具接入、沙箱安全与提示词设计
搭建这套投研团队,重点在三个工程环节:工具挂载、代码沙箱配置、角色系统提示词。
工具层面,通过 FunctionTool 给检索 Agent 挂载搜索 API、文档检索 RAG 接口,支持网页、PDF 研报、财报文档读取。所有外部资料必须记录来源链接,方便评审 Agent 溯源核验,这是降低投研幻觉的关键手段。
代码执行部分,AutoGen 推荐 Docker 沙箱运行 Python 分析代码,隔离文件系统与网络权限,防止恶意代码、数据泄露。投研场景大量财务计算、指标可视化,代码执行能力是不可替代的能力,纯文本大模型很容易算错财务公式。
角色提示词设计是成败关键。每个 Agent 的系统提示词必须严格限定角色边界:评审 Agent 必须被强制要求优先质疑,而不是附和,要求逐条核对数据源,识别未验证假设,不能直接接受其他 Agent 的结论。规划 Agent 需要明确任务优先级,控制研究范围,避免无限扩大检索范围,造成 token 成本失控。
同时,配置终止条件:当评审 Agent 确认全部校验完成,输出指定终止关键词,GroupChatManager 终止对话。同时设置最大对话轮次上限,作为兜底熔断,防止无限循环,控制调用成本。
四、性能评估:多智能体 vs 单 Agent 投研方案,以及现存短板
2026 年行业实测数据显示,同等模型底座下,AutoGen 多智能体投研团队在数据错误检出率、引用真实性、逻辑一致性上,相比单 Agent 方案提升 45%\60%;但代价是 token 消耗提升,整体推理成本提升约 30%\80%,取决于迭代轮次。单 Agent 方案速度快、成本低,但在复杂标的研究中,容易出现财务指标算错、引用编造、忽略负面风险等幻觉问题。
但这套投研多智能体方案仍存在明显短板。
第一,依赖外部数据源质量。如果搜索或知识库本身存在错误信息,多智能体依然会采信,评审 Agent 只能校验内部逻辑,无法直接核验原始事实真伪。
第二,多轮对话成本不可控。复杂标的研究可能需要十几轮辩论迭代,token 开销会快速上涨,需要做缓存、检索结果去重、模型路由优化。
第三,角色冲突与死循环。极端场景下,评审 Agent 和分析师持续争执,无法达成共识,需要人工介入干预。
第四,天然无法替代专业投研人员。AI 擅长信息收集、数据计算、文档整理,但行业深度理解、定性判断、重大风险识别,仍然需要人类专家最终复核。
五、调优策略、避坑指南与工程化落地建议
在实战开发中,有几个高频坑点需要规避。
角色职责模糊。多个 Agent 任务重叠,会造成对话混乱,出现重复工作。每个角色的系统提示词必须明确职责边界、输出格式。
不做来源溯源。如果检索 Agent 不强制保存原文链接,评审 Agent 无法核验,幻觉会大幅增加。投研场景,来源引用是强制要求。
关闭沙箱直接执行代码。生产环境绝对禁止,存在安全风险,务必启用 Docker 隔离沙箱。
取消人工复核节点。投研属于高价值高风险场景,不能完全自动闭环,必须保留 HITL 人工介入节点,关键结论人工确认。
落地优化策略:一是轻量化模型路由,简单任务使用低成本模型,复杂评审、规划任务调用更强推理模型;二是检索结果去重,减少重复资料带来的冗余 token;三是增加结果缓存,同一标的重复研究可复用已检索素材,降低成本;四是搭建评估集,用历史投研案例自动化测试,持续迭代角色提示词。
六、总结与未来演进方向
借助 AutoGen 的群组对话能力,我们可以快速搭建一支分工明确、能够自我校验的 AI 投研团队,自动完成资料搜集、财务计算、交叉评审、报告撰写,把投研人员从大量重复性资料整理、简单计算工作中释放出来,将精力集中在深度定性判断、风险研判上。
2026 年多智能体投研方向的演进趋势,会朝着三个方向推进:第一,和私有企业知识库深度融合,接入内部研报、数据库;第二,多智能体记忆持久化,支持跨会话持续跟踪标的,长期更新投研底稿;第三,更强的可观测性,自动记录每一条结论对应的证据链路,方便审计与溯源。
必须清醒认识,多智能体是投研辅助工具,不是投资决策系统。AI 可以高效整理信息、计算指标、生成初稿,但无法替代人类投研专家的专业判断。在实际使用中,坚持 “AI 做素材与初稿,人做最终研判与风险把关”,才是安全、可靠的落地方式。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。

评论列表