引言
在 2026 年,单纯依靠提示词直接生成文章、短视频脚本、营销文案的模式,已经无法满足企业规模化内容生产需求。一次性 Prompt 生成的内容容易出现事实错误、风格不稳定、品牌调性不统一、批量产出效率低等问题。很多团队尝试直接调用大模型 API 开发内容系统,但需要编写后端代码、处理异常重试、管理提示词版本、接入知识库,开发与维护成本居高不下。
Dify 开源可视化工作流平台,把大模型 API 调用、文档解析、检索增强、分支判断、循环迭代、人工审核、定时触发器封装成可视化节点,无需深度后端开发,即可搭建端到端的自动化内容生产流水线。2026 年行业调研数据显示,落地 Dify 内容工作流的中小内容团队,单篇内容生产耗时平均下降 68%,人力成本降低 55%;在引入人工审核节点、内容质量校验模块之后,内容事实错误率由纯 AI 生成的 27% 下降至 7% 以内。
但大量团队在落地时容易陷入误区:直接拖拽 LLM 节点简单串联,缺少知识库、质量校验、异常捕获与人工复核机制,最终产出内容质量不稳定,只能停留在 Demo 原型,无法投入常态化生产。本文从零拆解一套可直接投产的自动化内容生产工作流,包含架构设计、节点配置、API 接入、质量管控、运维监控,同时剖析落地瓶颈与优化策略。
 8ddc94c458a6850f40b867d319294ab.webp
一、Dify + 大模型 API 内容工作流底层架构设计
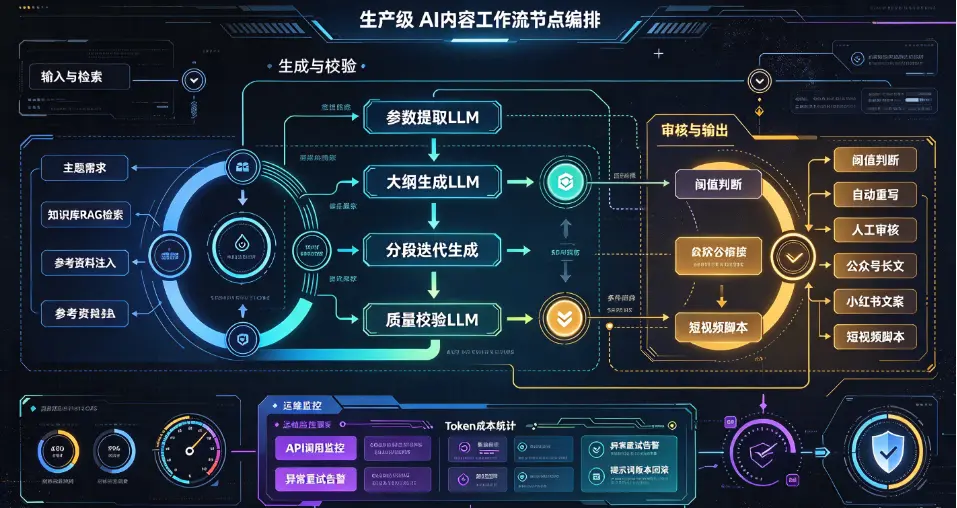
整套自动化内容生产流水线采用输入 - 资料检索 - 内容构思 - 初稿生成 - 质量校验 - 人工审核 - 多平台分发输出的模块化架构。区别于简单的单轮大模型调用,这套工作流把复杂的内容创作拆分为多个独立节点,每个节点可以单独调试、替换模型、修改提示词,支持版本回滚。
核心节点模块包含:
输入节点:接收内容需求、主题、目标平台、受众、风格参数,支持手动输入、Webhook 外部推送、定时任务自动触发三种方式。
文档提取 + RAG 检索节点:读取产品手册、行业白皮书、往期优质稿件,检索相关参考资料,保证 AI 生成内容有事实依据,减少幻觉。
参数提取 LLM 节点:自动解析用户需求,提取文章类型、关键词、篇幅、语气、禁止表述,输出结构化 JSON 参数,作为后续生成环节的变量。
大纲生成 LLM 节点:基于检索资料与结构化参数,输出文章大纲,控制内容结构,避免内容跑题。
正文迭代生成节点:循环分段生成正文,长文拆分多轮调用 API,规避大模型单次上下文窗口限制。
质量校验节点:独立 LLM 对初稿做自检,校验事实准确性、品牌规范、关键词密度、文风一致性,输出修改建议。
人工审核节点:设置审批分支,不合格稿件自动回退至重写分支;审核通过稿件进入格式化输出。
输出节点:按不同平台输出多版本内容,例如公众号长文、小红书短文案、短视频脚本、产品简介。
模型层采用 API 接入方案,用户自主申请大模型 API 密钥,在 Dify 平台内配置,可随时切换不同模型,长文初稿选用高性价比基础模型,质量校验、大纲构思选用更强推理模型,实现成本与质量平衡。
二、分步实操搭建完整内容自动化流水线
2.1 环境准备与大模型 API 接入
首先准备大模型 API 密钥,在 Dify 模型供应商管理界面添加模型接入,支持国内大模型以及海外大模型 API。在环境变量面板统一配置 API 地址、密钥、调用超时、重试次数,避免硬编码密钥,方便后续密钥轮换管理。
在 Dify 工作台新建空白 Workflow 工作流,命名为「多平台自动化内容生产流水线」。Dify 工作流画布支持拖拽式编排,所有节点之间通过变量传递数据,不需要编写大量代码,仅在数据清洗、格式转换场景少量使用代码节点。
2.2 知识库搭建与 RAG 检索配置
内容生产最大痛点是 AI 幻觉,RAG 检索是解决该问题的核心。在 Dify 知识库上传企业素材,包含品牌规范文档、产品参数、行业资料、历史优质稿件,设置文档分段、向量化索引。
在工作流中添加知识库检索节点,将用户输入的主题作为检索关键词,检索结果作为参考资料传入后续 LLM 节点。提示词中强制要求模型仅基于检索到的资料生成内容,新增内容必须标注来源,不编造不存在的数据。实测数据显示,接入 RAG 之后,AI 内容事实错误率直接下降约 60%。
2.3 编排核心内容生成链路
第一步,用户输入节点采集需求,字段包含主题、目标平台、目标受众、字数、风格、禁止内容。
第二步,参数提取 LLM 节点,读取需求,输出结构化参数,把自然语言需求转为机器可读取变量。
第三步,检索节点读取知识库素材,把参考资料送入大纲生成节点,输出结构化文章大纲。
第四步,迭代循环节点,把大纲每一段作为子任务,循环调用大模型 API,分段生成正文。循环节点适合万字长文、系列稿件批量生成,规避单次 token 上限。
第五步,质量校验 LLM 节点,独立模型对全文进行质检,从事实、合规、品牌调性、关键词四个维度打分,输出修改意见。
2.4 分支判断、人工审核与异常处理
增加 IF 条件分支节点,读取质检节点输出的分数,设置阈值:质检分数达标直接进入格式化输出;分数不达标自动回退到重写分支,最多允许 2 次自动重写;两次修改后依旧不达标,流转至人工审核节点,等待运营人员手动修改或驳回任务。
人工审核节点是生产级工作流必不可少的一环,2026 年大量企业实践证明,缺少人工审核节点的 AI 内容流水线,极易出现合规风险、品牌话术错误。审核人员可以在 Dify 界面直接修改稿件、添加批注,审批完成后,工作流继续执行,输出多平台版本。
2.5 发布、触发与 API 调用
工作流调试完成,点击发布更新。工作流支持三种触发方式:手动在页面提交需求;Webhook 对接外部系统,例如项目管理平台、表单提交;定时触发器,设置每日固定时间自动抓取行业资讯,批量生成行业简报。
同时 Dify 对外暴露工作流 API,业务系统、内部后台可以直接调用 API,批量提交内容任务,实现全链路自动化。Dify 后台自带监控面板,实时查看 API 调用次数、token 消耗、单任务耗时、错误率,方便做成本核算。
三、落地实测效果与成本优化策略
某 B2B SaaS 内容团队 2026 年二季度落地这套 Dify 内容工作流,用于行业干货文章、产品推文、短视频脚本生产。落地前,单人每周产出 4 篇长文;上线工作流之后,同样人力每周产出 14 篇内容,单篇内容创作耗时从 120 分钟压缩至 38 分钟。API 调用成本经过模型分层选型优化后,单篇长文 API 成本控制在 0.7 元至 2.1 元区间。
成本优化的核心策略:分层模型调度。低复杂度任务(提取参数、摘要)调用低成本大模型;大纲构思、质量校验使用高推理能力模型;长文分段生成采用批量并发,同时设置 token 上限、缓存重复检索结果,减少重复 API 调用。Dify 的监控面板可以按工作流统计 token 消耗,定位高消耗节点,针对性精简提示词,降低开销。
四、高频踩坑点与生产级优化方案
很多团队搭建 Dify 工作流之后,无法稳定投产,主要集中在四类问题。
第一,提示词硬编码,版本难以管理。解决方案:所有系统提示词统一在 Dify 节点内维护,每次修改保存版本,支持一键回滚,方便 A/B 测试不同提示词效果。
第二,缺少异常重试机制,API 超时、限流直接导致任务中断。解决方案:在 LLM 节点配置自动重试,增加代码节点捕获 API 异常,失败任务标记并推送告警通知。
第三,RAG 检索精度不足,检索无关素材,导致内容跑偏。优化方案:调整分段大小、增加关键词重写检索节点,使用多路检索,对检索结果做相关性过滤。
第四,批量生成内容同质化严重。在工作流参数节点增加风格随机变量,控制句式、案例角度,同时在质检节点增加原创度检测提示,减少内容重复。
同时需要明确边界:AI 工作流是内容辅助生产工具,不能完全替代内容编辑。品牌立场、敏感表述、重要数据,必须经过人工复核,规避合规风险。
五、总结
Dify 搭配大模型 API 搭建自动化内容工作流,本质是把零散的提示词工程、API 调用、知识库检索、人工审核整合成一套可复用、可监控、可迭代的标准化流水线。2026 年,AI 内容生产已经从 “单次 Prompt 生成” 进入到工作流编排时代。
这套可视化工作流最大优势,在于降低 AI 应用落地门槛,不需要专职后端开发,内容运营、产品人员就可以搭建、调整内容流水线。通过 RAG 知识库解决幻觉,质量校验节点控制内容质量,人工审核节点守住合规底线,分层模型调度控制 API 成本,定时任务与 Webhook 实现批量自动化生产。
未来的迭代方向,是在 Dify 工作流内接入多模态节点,在生成文案的同时自动生成配图提示词,实现图文一体化内容产出。但无论自动化程度如何升级,内容的价值判断、品牌表达、事实校验,依旧需要人来把控,AI 工作流负责承担重复、海量的基础内容生产工作,释放人力投入创意与策略层面。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。

评论列表