
2026 年是大模型技术范式切换的关键年份。自 2022 年大语言模型爆发以来,AI 长期停留在被动生成文本、图像内容的阶段,模型仅能基于已有数据做概率化输出,缺乏对物理世界的理解、长链条因果推理能力与自主规划行动能力。进入 2026 年,行业共识发生根本性转变:单一文本基座无法支撑通用人工智能,原生多模态、推理大模型、世界模型三大技术方向协同演进,共同驱动 AI 从 “生成内容” 走向 “理解世界、自主决策、物理交互”。全球科研机构与科技企业围绕这三条主线持续攻坚,在架构设计、评测基准、落地场景上取得一系列标志性突破,一张全新的 AI 前沿技术地图逐渐清晰。
原生多模态大模型是整个智能体系的感知入口,也是 2026 年底层架构革新最显著的赛道。过去两年主流多模态方案普遍采用 “文本大模型 + 独立视觉编码器” 的外挂拼接模式,文本、图像、视频分属不同表征空间,模态之间存在信息壁垒,视频时序理解、3D 空间感知能力薄弱,很容易出现空间错位、物理常识错误等幻觉问题。而 2026 年原生多模态技术的核心变革,就是抛弃独立编码器,在预训练阶段就将文本、图像、音频、视频、点云等所有模态信息映射至同一表征空间,实现统一序列建模。
 9a86c23b995881e958a99c51c2cb9ef.webp
Google 在 2026 年发布的 Gemma 4 12B 采用无编码器统一架构,视觉、音频信号直接接入大模型主干网络,在 16GB 显存的消费级设备上即可本地运行,兼顾多模态理解与多步推理能力,大幅降低原生多模态落地门槛。国内智源研究院 Emu3.5 在《自然》正刊成果基础上完成迭代,将模型目标从 “预测下一个词元” 升级为跨模态 “下一状态预测”,原生建模时空关系与物理因果,能够持续解析长时序视频场景,有效缓解生成画面违背物理规则的经典缺陷。月之暗面 Kimi K3 作为 2026 年发布的超大开源基座,原生集成视觉能力,搭载百万级上下文窗口,在长文档、多图联合理解、复杂工程资料解析任务中达到全球第一梯队水平。Meta Muse Spark 1.1 则面向智能体任务优化,强化 GUI 界面操作、工具调用、多模态规划能力,能够自主浏览网页、操作软件,完成跨模态复杂任务链。
原生多模态的价值不止于看懂图文视频,它为 AI 智能体提供完整的环境感知能力。但仅有感知,AI 依旧无法完成复杂任务,推理大模型承担的正是 “思考决策” 的核心职能。2026 年推理大模型不再局限于简单的思维链提示工程,技术重心转向推理时计算、过程奖励模型(PRM)、分步自我校验三大方向。传统模型一次性输出最终答案,中间推理过程不可控,长链条逻辑极易出现漂移、跳步错误;而新一代推理大模型会分步拆解问题,生成中间推理步骤,借助过程奖励模型对每一步逻辑做正确性评估,发现错误后回溯修正,模仿人类解题时的思考与自查过程。
OpenAI GPT-6 Astra 是 2026 年推理能力标杆模型,在 FrontierMath Tier4 评测达到 97.6%,ARC-AGI-3 基准得分 99.9%,长程规划、计算机操作、漏洞挖掘等复杂任务实现跨越式提升,百万 token 上下文窗口能够稳定保持全程逻辑一致性,不会随着任务长度增加快速遗忘前置条件。微软 Phi-4-reasoning-vision-15B 则证明小参数模型同样可以实现强多模态推理,依靠高质量推理数据、动态分辨率视觉编码器,在科研计算、UI 视觉推理任务上接近大模型性能,为轻量化推理智能体提供可行方案。
2026 年行业研究进一步发现,推理能力并非单纯依靠扩大参数规模。上海人工智能实验室的研究表明,推理性能提升与多样化任务环境数量强相关,当训练任务环境提升两个数量级,模型泛化推理能力能够持续稳定增长,这为推理模型训练提供可复现工程路径。当前推理大模型仍存在明显短板:复杂因果推理稳定性不足,面对训练分布外全新问题时,自我纠错成功率下降;推理时计算会带来显著算力开销,如何平衡推理精度与推理延迟,是商业化落地必须解决的核心矛盾。
如果说多模态负责感知、推理大模型负责思考,世界模型则是 AI 的 “内在想象世界”,也是 2026 年最具颠覆性的前沿方向。世界模型的核心定义,是在隐空间内构建物理世界抽象模拟器,接收当前环境观测信息,预测不同动作输入之后世界未来状态的演化,而不是仅仅预测下一帧图像或者下一段文字。AI 可以在虚拟的内部世界中完成试错、规划、推演,不需要在真实物理世界承担高昂试错成本,这对于人形机器人、自动驾驶、工业控制等场景至关重要。
英伟达 2026 年 5 月发布 Cosmos 3 世界模型,融合物理推理、场景生成与动作生成能力,提供 16B 的 Cosmos 3 Nano 和 64B Cosmos 3 Super 两个版本,开源机器人、自动驾驶、仓储自动化数据集,在多个物理 AI 基准榜单取得领先,支持物理规则约束下的场景仿真与机器人动作规划。国内智源 RoboBrain Orca 悟界世界模型,跳出单模态预测框架,核心目标是预测 “下一个世界状态”,统一融合视觉、文本、动作信号,自主学习物体运动规律、因果关联与时序演变,可推演多种未来可能性,为人形机器人提供认知底座。大晓机器人开悟世界模型(Kairos)在 RoboTwin 2.0、LIBERO-Plus 等四项世界模型权威评测取得第一,采用多模态理解 - 生成 - 预测一体化原生架构,解决传统视频生成类世界模型物理真实性不足、因果缺失的痛点。Meta V-JEPA 2-AC 则走隐表征预测路线,不重建像素画面,仅依靠抽象状态预测,使用少量无标注机器人视频数据,就实现零样本机器人控制,推理速度相比像素生成路线提升约 15 倍,印证 LeCun “理解世界不必重建世界” 的技术路线判断。
当前世界模型赛道分化为两条技术路线:生成式路线,以渲染完整画面为目标,在训练分布内仿真效果优秀,但分布外场景误差会急剧放大;隐状态预测路线,聚焦抽象世界状态推演,不渲染像素,计算效率更高,更适合机器人实时控制。两条路线各有优劣,2026 年的研究热点正是融合两条路线优势,兼顾仿真可视化与物理因果可靠性。但世界模型仍然面临根本性挑战:真实世界物理系统存在大量复杂耦合变量,长时序推演误差会不断累积;真实物理交互数据稀缺、采集成本极高;模型很难泛化到从未见过的新物体、新场景。
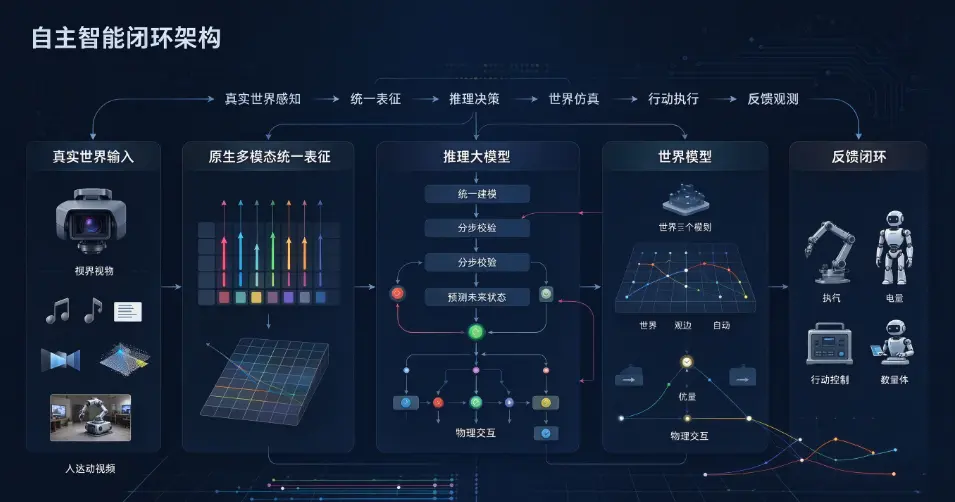
多模态、推理大模型、世界模型三者不是孤立发展,而是形成完整智能闭环:原生多模态负责采集、编码真实世界多维度感知信息;推理大模型接收感知结果,完成任务拆解、逻辑推理、动作规划;世界模型作为内部仿真引擎,模拟执行规划动作之后的环境变化,评估方案风险,优化动作策略;仿真评估完成后,将最终动作指令输出到物理设备,执行之后再把新的环境观测反馈给多模态感知模块,循环迭代。这套 “感知 - 推理 - 仿真 - 行动” 闭环,正是 2026 年 AI 智能体与人形机器人的底层技术架构。
三大技术融合,正在重塑产业落地边界。在科研领域,多模态 + 推理模型可以自动读取论文、实验图表,完成科学计算、实验方案设计;世界模型能够模拟分子运动、材料物理特性,加速新材料研发。在工业场景,世界模型可以搭建工厂数字孪生仿真环境,推理大模型负责产线调度与故障排查,多模态视觉实时识别设备状态。在具身智能领域,人形机器人依靠多模态感知识别环境,推理模型规划任务,世界模型提前模拟抓取、移动动作,规避碰撞风险,降低真实硬件试错损耗。在个人智能体领域,Meta Muse、OpenAI Dots 这类产品依托三大技术,实现自主搜索、软件操作、事务处理,从被动对话助手升级为全天候自主助理。
但站在 2026 年时间节点,我们必须理性看待当前技术边界。第一,幻觉问题没有被彻底根除,即使世界模型强化物理约束,在未知场景依旧会出现违背客观规律的推演;第二,算力、数据成本依然高昂,世界模型与推理时计算的算力消耗远高于传统大模型;第三,安全对齐与可控性难题凸显,具备自主规划与环境仿真能力的智能体,一旦目标对齐失效,潜在风险显著提升;第四,跨场景泛化能力不足,模型在实验室基准测试表现优异,迁移到真实非结构化环境,性能会出现明显衰减。
回望 2026 年 AI 技术演进,行业已经告别单纯比拼参数规模、榜单分数的阶段,转向构建能够感知、思考、想象物理世界的完整智能系统。原生多模态解决 “看见世界”,推理大模型解决 “思考问题”,世界模型解决 “想象未来”。三者协同,构成通往通用人工智能的核心技术底座。未来一段时间,技术创新重心会持续向智能体、具身物理 AI 倾斜,如何提升模型物理真实性、降低推理算力开销、增强系统可控性,将是科研界与产业界持续攻坚的核心命题。AI 不再只是屏幕内的生成工具,正借助这套全新技术体系,逐步走进真实物理世界。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。

评论列表