从Transformer到Mamba:下一代AI架构正在改写哪些技术规则?

自 2017 年 Transformer 凭借自注意力机制开启大模型时代,O (N²) 二次复杂度一直是长上下文场景的核心瓶颈。2026 年 Mamba-3 的正式发布,以选择性状态空间模型(SSM)为核心,采用线性 O (N) 序列复杂度,正在重塑大模型底层技术范式。

2017 年《Attention Is All You Need》提出的 Transformer 架构,奠定了近十年大语言模型的技术基石。自 GPT、Claude 到 Gemini,几乎所有主流大模型都建立在自注意力机制之上。自注意力的核心逻辑是让序列内每一个 token 与其他全部 token 做相关性计算,捕捉长距离语义依赖。但该设计与生俱来的二次复杂度 O (N²),随着上下文窗口拉长,算力、显存开销会呈爆炸式增长。当上下文达到数十万甚至百万 token 级别,KV 缓存占用的显存会成为推理成本的最大枷锁。

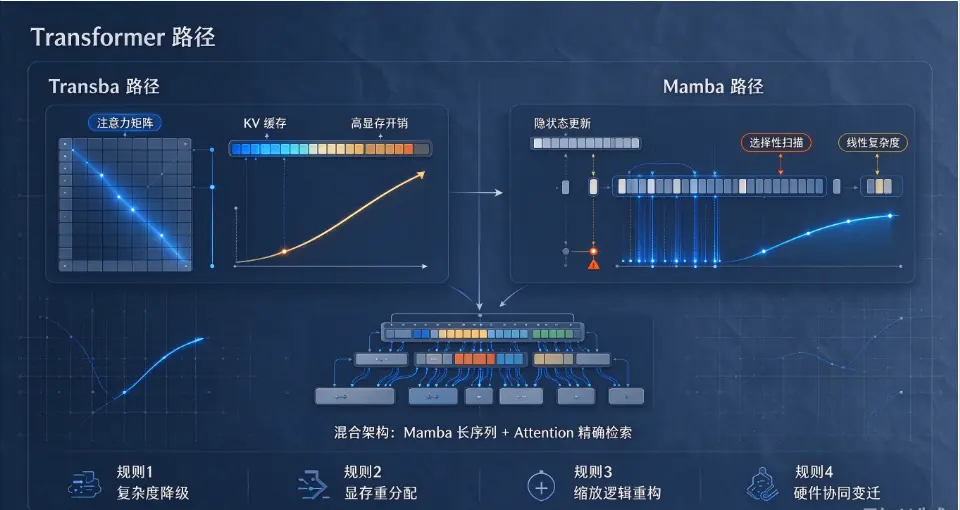
2023 年底 Mamba 架构问世,首次让选择性状态空间模型(SSM)在语言任务上达到 Transformer 级别的能力。2026 年 3 月 Mamba-3 正式发布,在理论、算子、状态表示上完成重大升级,标志着后 Transformer 时代的架构竞争进入产业化落地阶段。它不再依赖显式注意力矩阵,而是维护固定大小的隐状态,逐个读取序列并选择性记忆、遗忘信息,计算复杂度仅为 O (N)。这一底层差异,正在逐条改写过去十年围绕 Transformer 建立的 AI 技术规则。
e3401ca56736f1e065fea7f4abe3f95.webpe3401ca56736f1e065fea7f4abe3f95.webp

一、规则 1:序列复杂度,从二次爆炸转向线性缩放

Transformer 的核心痛点,来自自注意力的 O (N²) 计算复杂度。当上下文窗口从 32K 扩展到 256K,计算量提升 64 倍,KV 缓存占用显存随 token 数量线性增长。在处理百万 token 级别的法律卷宗、完整代码库、基因序列、长音频时序数据时,纯 Transformer 架构推理成本极高,甚至无法一次性加载完整上下文。行业只能依靠滑动窗口注意力、稀疏注意力、检索增强 RAG 等补丁方案缓解,但无法根除二次复杂度的底层约束。
Mamba 架构彻底抛弃显式注意力矩阵,采用选择性状态空间模型,把全部历史信息压缩进固定维度的隐状态向量,每新增一个 token,仅更新隐状态,新增计算量与序列长度无关。2026 年 Mamba-3 引入复数域状态更新与 MIMO 多输入多输出机制,在 15 亿参数规模下,长序列任务端到端延迟仅为同规模 Transformer 的 1/7,吞吐量提升 5 倍以上。在百万 token 长上下文场景,Mamba 不需要持续膨胀的 KV 缓存,显存开销几乎不再随输入长度增加。
但这一优势存在边界。Mamba 依靠隐状态压缩历史信息,在需要精准检索前文细节的 “大海捞针” 任务上,精确关联记忆能力弱于 Transformer 的注意力机制。2026 年行业共识是:短上下文、高精确检索场景,Transformer 依然保有优势;十万 token 以上超长序列场景,Mamba 的线性缩放优势会完全释放。

二、规则 2:显存与推理范式,KV 缓存不再是必选项

在 Transformer 的工程体系中,KV 缓存是落地推理的核心组件。每一轮生成,模型会保存全部历史 token 的 Key、Value 向量,后续生成 token 直接复用缓存,避免重复计算。但上下文越长,KV 缓存占用显存越大,企业部署大模型时,大量 GPU 显存被 KV 缓存占用,而非模型权重。这也是长上下文大模型部署成本居高不下的根本原因。
Mamba 推理过程不存在 KV 缓存。历史信息被压缩到固定大小隐状态,每一步生成只维护状态向量,显存占用不再随上下文持续膨胀。Mamba-3 进一步优化状态存储,用一半的内部状态维度,即可达到 Mamba-2 的表征能力,进一步降低显存开销。IBM Granite 4.0 采用 Mamba-2 为主、少量注意力层为辅的混合架构,实测 256K 上下文场景下,显存占用相比纯 Transformer 降低 70% 以上,推理速度提升 2 倍。AI21 Jamba 同样采用交错式混合架构,少量注意力层负责精确检索,大量 Mamba 层负责长序列压缩,兼顾效率与精度。
这改写了推理部署的核心规则:过去大模型推理的显存瓶颈是 KV 缓存;在 Mamba 或混合架构体系中,显存瓶颈回归模型权重本身。云厂商、AI 智能体开发者可以用更低显存成本运行超长上下文任务,为 AI Agent 持续记忆、多轮长会话、海量文档解析打开新空间。代价是 Mamba 推理属于递推式计算,prefill 阶段并行度弱于 Transformer,短文本场景下硬件优势会被削弱。

三、规则 3:模型缩放定律,参数不再是唯一标尺

Transformer 时代,行业默认的缩放定律:模型能力随参数量、训练数据量、计算量同步提升。过去厂商提升模型能力,最简单的路径就是堆参数、堆 GPU。但随着参数规模逼近千亿、万亿级别,训练成本、推理成本指数级上升,边际收益持续递减。
Mamba 带来了全新的缩放逻辑:模型能力不只依靠参数规模,更取决于状态空间的表征能力、选择性记忆机制与算子优化。Mamba-3 在 1.5B 参数规模下,基准测试平均准确率达到 57.6%,超过同规模 Transformer 模型 4 个百分点。同等参数量下,Mamba 架构可以承载更长上下文,单位算力产出更高的序列建模能力。
2026 年行业研究发现,SSM 架构的缩放曲线和 Transformer 存在明显差异。Mamba 在中等参数规模就能够实现不错的长序列能力,但超大规模参数下,纯 Mamba 架构的复杂逻辑推理、多步数学推理提升速度慢于 Transformer。因此行业不再追求 “纯 Mamba 替代大参数 Transformer”,而是走向混合架构:主体采用 Mamba 层处理海量长序列,稀疏插入少量注意力层,解决精确召回、复杂推理问题。这套混合范式,推翻了 “单一架构一统天下” 的旧思路,模型设计从 “全注意力堆叠” 转向模块化组件拼接。

四、规则 4:硬件协同设计,从适配矩阵乘法走向面向递推算子优化

Transformer 是为 GPU 矩阵乘法设计的架构,整套生态围绕张量核心、矩阵乘算子构建。过去十年,芯片、框架、算子库全部以加速大矩阵运算为目标。而 Mamba 的核心是选择性扫描(selective scan)递推计算,属于序列递推算子,和传统矩阵乘法硬件优化路径完全不同。
Mamba 的高效运行依赖高度定制化 CUDA 算子融合,需要对状态更新做硬件感知优化。2026 年 Mamba-3 的 MIMO 设计,将状态更新改为矩阵乘法形式,让递推计算可以填充 GPU 张量核心闲置算力,在不增加解码延迟的前提下提升表征能力。这改变了 AI 芯片的设计目标:下一代 AI 加速器,不仅要优化矩阵乘法,还需要原生支持 SSM 递推扫描算子。同时,模型开发者需要针对 Mamba 算子做单独的内核调优,传统 Transformer 的训练、微调工具链无法直接复用,整个模型工程体系需要重构。

五、架构变革的边界:Mamba 不是万能替代品

Mamba 带来范式革新,但并非彻底淘汰 Transformer。纯 Mamba 架构存在固有短板:固定隐状态存在信息压缩损失,在需要精确匹配、细粒度关联的任务,如复杂逻辑推理、精准事实召回,表现弱于 Transformer。同时 Mamba 生态成熟度低于 Transformer,微调、对齐、安全评估工具链还在快速建设。
2026 年产业落地的主流路线,不是 “二选一”,而是混合架构。Mamba 负责长序列信息压缩、海量文档预处理、时序信号建模;少量注意力层承担精确检索、复杂推理任务。这一组合方案广泛应用于代码库分析、企业知识库、AI 智能体长期记忆、多模态长视频理解场景。

结语

Transformer 主导的时代,行业的核心矛盾是算力能否支撑注意力机制的二次复杂度。Mamba 架构的出现,把矛盾转移到 “如何用有限隐状态高效压缩、记忆海量序列信息”。Mamba-3 在 2026 年完成的迭代,不是简单的模型升级,而是底层技术规则的重塑:序列复杂度、显存推理策略、模型缩放逻辑、硬件设计方向,全部迎来新的评价体系。
未来不会出现单一架构完全取代 Transformer,而是进入混合架构百花齐放的时代。架构选型不再只看基准跑分,而是基于任务上下文长度、显存预算、推理延迟需求做取舍。对于 AI 智能体、RAG 知识库、长时序多模态应用,Mamba 及混合架构将打开全新的产品空间;而在高精度推理、短对话场景,Transformer 的价值依然不可替代。理解两种架构的取舍,是把握下一代大模型技术演进的关键。

来源: 互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。

赞 ()

相关推荐

  • 2026年AI变现的12条路径:从接单、做课到自动化服务

    本文拆解 2026 年 12 套可落地 AI 变现路径,覆盖个人接单、知识付费课程、企业自动化智能体服务三大层级,结合 2026 最新行业交易数据,区分低门槛副业、中阶产品化、高客单价 B 端服务,分析各路径盈利模型、成本、风险与规模化瓶颈,避开 AI 变现常见误区。

    2026年09月30日 18点16分
  • 我把AI塞进一天生活:起床、通勤、做饭到睡眠的实测记录

    2026 年,AI 智能体不再局限于办公场景,开始完整嵌入普通人 24 小时生活链路。本次实测以普通职场人的完整一日为样本,将全天候 AI Agent 接入家庭设备、手机、车载终端,覆盖起床唤醒、晨间规划、通勤、日间事务、居家做饭、晚间复盘、睡眠监测全流程,连续 7 天对照记录效率、失误率、体验痛点与隐私风险。

    2026年09月30日 18点11分
  • 2026年最值得尝试的8类AI智能体:办公、编程、客服与个人助理全景解析

    2026 年是 AI 智能体规模化落地元年,AI 从被动对话工具转向具备目标拆解、工具调用、多步骤自主执行能力的数字劳动力。本文梳理 8 类最具实用价值的 AI 智能体,覆盖办公协同、编程开发、企业客服、个人助理、科研调研、销售拓客、法律合同、低代码自定义智能体。

    2026年09月30日 18点07分
  • 手把手教你用 Coze 搭建自动写周报的 AI 工作流(2026版)

    本文为 2026 最新 Coze 低代码工作流实操教程,拆解自动生成周报完整搭建逻辑,打通日程、多维表格、会议纪要数据自动归集,配置定时触发、AI 润色、自动推送,解决 AI 周报内容空洞、数据失真问题,附带调试优化方案与落地案例。

    2026年09月30日 16点49分
  • 2026AI内容工作室规模化盈利指南|提示词工程到自动化内容矩阵月入10万搭建方案

    2026 年 AI 内容行业已经告别单账号零散创作的副业模式,成熟工作室依靠标准化提示词资产、多智能体自动化流水线搭建跨平台内容矩阵,实现稳定规模化收益。本文基于国内 17 家 AI 内容工作室调研数据,拆解从提示词资产库搭建、母素材一次生产多平台分发、自动化矩阵运维到多元变现的完整落地路径,量化月入 10 万工作室的收入结构、人力配置与成本模型。

    2026年09月29日 20点30分
  • 个人AI数字分身深度体验:从内容生成到社交代理接管的完整功能测试与边界探索

    2026年个人AI数字分身从静态数字人形象,升级为具备长期记忆、自主规划、跨平台操作能力的个人智能代理。本文通过对照实测,完整验证AI分身两大核心能力:一是图文、短视频、语音类个人内容自动生成;二是社交代理接管,代为处理消息沟通、日程协调、简单商务谈判。

    2026年09月29日 20点27分
  • 2026多智能体协同工作流实战:3个AI代理自动完成项目全流程交付搭建与效果实测

    2026 年多智能体技术从单点对话走向长周期项目自治交付,基于角色分工的 AI 代理团队能够模拟人类项目团队,自动完成需求拆解、方案设计、成果产出与质量校验全链路工作。本文搭建由产品代理、开发代理、测试代理组成的三智能体协同系统,依托 LangGraph 状态图编排、共享全局记忆与质量校验节点,构建端到端项目交付工作流。

    2026年09月29日 20点24分
  • 2026本地大模型私有化部署实战|8GB显存环境70B模型高效运行调优全流程指南

    大模型私有化部署长期受限于硬件门槛,70B 参数模型传统方案需要数十 GB 显存,普通消费级显卡难以承载。2026 年异构内存调度、块级分层加载与轻量化量化技术成熟,8GB 显存单卡硬件可以稳定完成 70B 大模型本地私有化推理。本文结合实测工程案例,完整拆解从模型预处理、混合精度量化、异构显存 / 内存 / 磁盘分层调度、KV 缓存优化到内核参数调优全流程。

    2026年09月29日 20点17分
  • 2026日常场景AI改造实验:用AI智能体实现全场景生活自动化的7天实测记录

    2026年AI智能体从产业办公赛道全面下沉至个人日常生活场景,具备自主规划、异步执行、多工具联动、持续记忆迭代的生活化Agent,逐步替代传统单点AI助手,让全流程生活自动化从概念走向落地。基于斯坦福HAI 2026年实测基准数据,新一代生活类AI智能体日常多步骤任务完成率达66.3%,较2025年12%实现跨越式提升,距离普通人机执行效率差距持续缩小。

    2026年09月28日 17点11分
  • 2026链上AI智能体落地全景:从DEX自动做市到跨链资产调度的13个真实应用场景

    2026年链上AI智能体彻底走出概念试点阶段,全面渗透DeFi核心业务链路,成为去中心化金融自动化运营的核心基础设施。据BlockEden 2026年Q3行业数据显示,当前68%的新晋DeFi协议已原生内置AI智能体模块,传统人工值守、脚本自动化模式逐步被淘汰,AI自治交易、智能做市、跨链调度成为行业主流。

    2026年09月28日 17点09分
  • 2026零代码搭建链上AI智能体完整教程:从环境配置到自动捕获生态激励全步骤拆解

    2026年链上AI智能体彻底告别代码开发门槛,零代码可视化搭建成为普通用户、小微工作室入局Web3自动化的主流方式。行业数据显示,手动参与链上生态激励的用户年均有效参与率不足27%,而标准化零代码AI智能体可将生态任务覆盖率提升至92%,激励捕获效率提升4倍以上。

    2026年09月28日 17点03分
  • 个人AI工作室2026:用多智能体流水线做内容、电商与咨询的盈利模型

    2026年个人AI创业彻底告别单点工具套利、批量内容搬运的内卷模式,依托多智能体流水线的轻量化工作室模式,成为单人低成本、高复利、可持续的核心盈利赛道。行业数据显示,传统零散AI副业淘汰率超85%,而搭建标准化智能体工作流的个人工作室,月均稳定收益可达1.5万-8万元,盈利效率是传统副业的3-5倍。

    2026年09月27日 14点43分
  • AI伴侣与情绪计算:2026年陪伴型智能体的体验、伦理与隐私实验

    2026年是AI陪伴从“对话娱乐”走向“情绪共生”的产业化元年,依托情绪计算大模型的技术突破,AI伴侣可精准识别、模拟、共情人类百级复合情绪,彻底颠覆传统人机交互模式。据2026年行业最新数据,全球AI虚拟伴侣市场规模突破318亿美元,国内情绪经济市场规模超2.7万亿元,Z世代、独居青年、中老年群体成为核心用户,市场潜在需求规模超4亿人。

    2026年09月27日 14点40分
  • AI智能体重塑软件研发:2026年需求、编码、测试、运维闭环实践

    2026年软件研发正式告别碎片化AI辅助时代,AI智能体完成研发全链路渗透,构建起需求解析、智能编码、自动化测试、无人运维的完整工程闭环。据2026年Q3全球软件工程效能报告显示,规模化落地AI研发闭环的企业,版本迭代周期缩短58%,线上故障率下降67%,人力重复工作量削减超70%,传统研发模式“需求偏差、编码低效、测试漏测、运维滞后”的结构性痛点被系统性解决。

    2026年09月27日 14点37分
  • 2026年多智能体工作流实战:搭建可观测、可审计的协作系统

    2026年多智能体工作流全面进入企业生产落地阶段,但行业数据显示,70%以上的自研多Agent项目因流程黑盒、无溯源日志、无法合规审计最终下线。传统智能体协作系统仅追求自动化效率,缺失观测与审计能力,普遍存在决策不可追溯、跨Agent交互混乱、异常无法定位、不合规输出难管控等痛点。

    2026年09月27日 13点50分
  • 2026年AI变现指南:从提示词外包到智能体服务的合规盈利路径

    2026年AI行业彻底告别野蛮变现时代,浅层提示词搬运、无资质AI中转、模板化内容代工等老旧模式全面受限,大量从业者因不合规操作遭遇限流、追责、收益冻结。结合本年度最新监管细则与行业商业化数据,传统C端AI副业淘汰率超82%,而标准化、可溯源、可落地的AI服务模式成为主流盈利赛道。

    2026年09月26日 23点04分

发表回复

评论列表

点击查看更多

    联系我们

    在线咨询: QQ交谈

    微信:叁叁

    邮件:794033364@qq.com

    工作时间:周一至周五,9:30-18:30,节假日休息

    微信