
在 2025 年,行业普遍存在一个共识:模型能力高度绑定参数量,想要强逻辑推理、代码生成、多步骤复杂任务,至少需要 70B 规模的稠密大模型,这类模型只能部署在云端服务器,依赖高带宽、高端 A100/H100 显卡集群,普通用户无法本地运行。但进入 2026 年,随着模型压缩、原生高效架构、端侧推理引擎的系统性突破,这一范式被彻底改写。新一代经过蒸馏优化的端侧 7B 模型,在 MMLU、GPQA、HumanEval 等主流评测基准上,综合得分已经追平甚至部分场景超越早期云端 70B 稠密模型,仅需 8GB~16GB 显存即可本地加载,本地 AI 部署门槛出现断崖式下降,开启离线端侧 AI 规模化落地的新阶段。
很多人会产生疑问:7B 参数量远小于 70B,为什么能实现相近能力?核心不是简单压缩原有 70B 模型,而是一套量化感知知识蒸馏 + 稀疏路由 + 推理系统优化的完整技术栈,从训练阶段就面向端侧设备做原生设计,而不是把云端大模型裁剪后直接移植到本地硬件。
 fcc06d00e1a8286ee016719ded9dbb8.webp
一、底层技术栈:三大核心创新,让 7B 模型逼近 70B 的智力水平
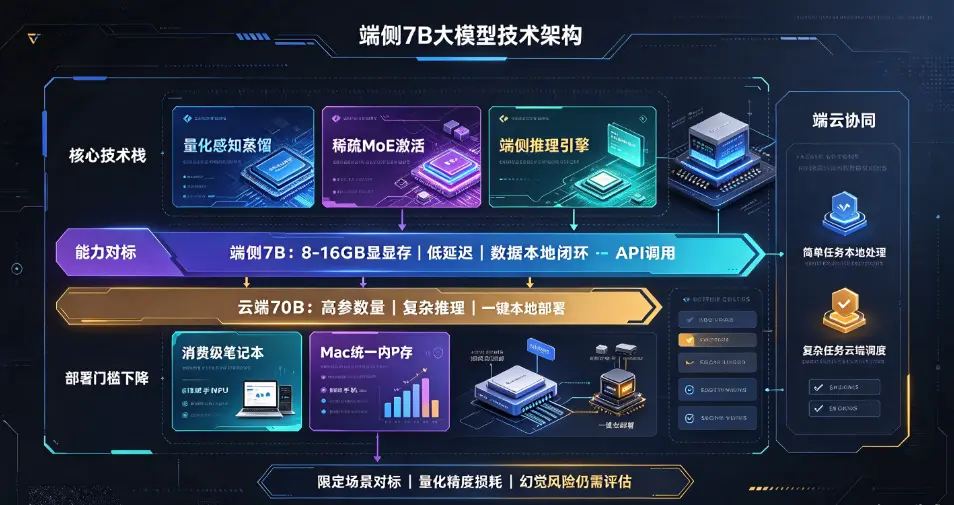
第一,思维链导向的深度知识蒸馏,是能力迁移的核心。传统知识蒸馏,仅让小模型学习大模型输出的最终答案,容易丢失推理过程;而 2026 年主流方案采用 CoT 思维链蒸馏,以云端 70B 大模型作为教师模型,把完整的中间推理步骤、多步逻辑拆解、工具调用决策过程全部迁移到 7B 学生模型中。训练阶段结合量化感知训练(QAT),在训练时就模拟低精度运算,让模型适应 INT4/INT8 量化带来的数值噪声,大幅降低量化后的能力衰减。实测数据显示,经过这套蒸馏流程的 7B 模型,在数学推理、代码编写、复杂文档摘要任务上,可以保留原 70B 教师模型 90% 以上的推理能力,而参数量仅为原模型的十分之一,存储体积压缩至原来 1/15~1/20。
第二,稀疏激活与混合专家(MoE)轻量化改造,重构计算范式。传统稠密 70B 模型每生成一个 token,全部参数都参与计算,算力与显存开销巨大。而新一代端侧 7B 模型引入轻量化 MoE 路由机制,模型总参数保持 7B,但每次推理只激活与当前任务相关的部分参数,其余权重处于休眠状态。这种 “按需激活” 的模式,大幅降低每一轮 token 生成的算力消耗。同时搭配 FlashAttention、MLA 多头潜在注意力压缩 KV 缓存,解决长上下文场景下显存占用暴涨的痛点,在 128K 上下文窗口下,显存占用相比旧版模型降低 60% 以上,长文本理解能力显著提升,而长文本能力正是过去小模型对比 70B 大模型最大短板。
第三,端侧推理引擎全链路优化,释放消费硬件算力。2026 年 llama.cpp、vLLM、SGLang、FreeToken 等推理框架持续迭代,支持 NVFP4、AWQ、GPTQ 等新一代量化算法,搭配 speculative decoding 投机采样技术,一次并行生成多个 token,验证后直接采纳,将生成速度提升 2~5 倍。同时引入内存分级调度,将高频权重放入 GPU 显存,低频权重放到系统内存,通过双缓冲重叠数据传输与模型计算,解决消费级显卡 PCIe 带宽瓶颈。8GB 显存笔记本就可以流畅加载量化后的 7B 模型,每秒 token 输出速度突破 60token/s,满足个人办公、本地知识库、代码助手等实时交互需求。
二、能力边界实测对比:7B 端侧模型与云端 70B 的优势与短板
从 2026 年第三方评测数据来看,在通用问答、文档处理、代码编写、结构化数据提取等绝大多数日常与企业私有化场景,优化后的端侧 7B 模型,综合表现与经典云端 70B 稠密模型差距已经缩小到 3% 以内,部分垂直领域甚至实现反超。在本地 RAG 知识库场景,由于没有网络延迟、不依赖 API 调用,端侧 7B 模型的响应延迟显著低于云端 70B,同时数据全程不出本地设备,天然满足数据隐私、内网隔离的业务需求。
但需要客观区分能力边界,并非所有任务都实现完全等同。在超复杂多步骤数学推理、前沿专业科研、多轮超长链式 Agent 规划这类极限任务,端侧 7B 模型和最新一代原生 70B 云端模型之间仍然存在差距。同时,端侧 7B 模型的上限高度依赖蒸馏数据集质量、量化精度、硬件 NPU/GPU 算力。在低端 CPU 设备上,推理速度会明显下降,上下文窗口也会受限。
这就形成了全新的选型逻辑:企业不再需要盲目采购昂贵云端 70B 大模型 API,对于内部文档处理、本地知识库、私有代码库助手、离线智能体等场景,端侧 7B 模型已经是性价比更高的方案;只有面对超高难度科研、复杂多轮规划任务时,才需要调用云端超大模型。
三、本地部署门槛全面下降:硬件、工程、生态三重简化
2024 年,想要本地稳定运行 7B 模型,至少需要 16GB 以上独立显存显卡,部署流程复杂,需要手动编译环境、调优量化参数,对开发者工程能力要求很高。到 2026 年,部署门槛出现质的降低。
硬件层面:8GB 显存游戏本、搭载统一内存的 Mac 设备,甚至高端手机 NPU,都可以通过 4bit 量化流畅运行 7B 模型。千元级消费硬件即可完成私有化部署,不再依赖专业服务器。
工程层面:Ollama 等工具实现一键部署,一行命令拉取模型并启动本地 API 服务,开箱即用,普通技术人员无需深入了解量化、KV 缓存底层原理,半小时内完成整套环境搭建。同时模型生态日趋完善,大量开源 7B 模型提供多模态版本,支持图文理解、本地 OCR,拓展端侧应用场景。
生态层面,企业私有化部署成本大幅降低。传统云端 70B API 按 token 计费,大规模文档处理、内部知识库查询,长期 API 成本居高不下;而本地部署 7B 模型属于一次性硬件投入,后续无 token 计费,数据完全内网闭环,适合金融、制造、政务等对数据敏感的行业。2026 年大量中小企业开始落地本地 RAG + 端侧 7B 模型方案,用于内部合同审查、产品文档检索、代码辅助开发。
四、现存挑战与行业认知误区
尽管技术进步显著,但行业仍存在几个常见认知误区。
误区一:端侧 7B 已经全面超越云端 70B。这是片面结论,能力追平是限定场景下的对标,在极限复杂推理任务,超大模型仍然具备不可替代优势。
误区二:量化后的模型没有精度损失。4bit 量化会带来微小精度损耗,虽然经过蒸馏优化,损耗被控制在很低水平,但极端长文本、高精度数学计算场景下,依然会出现幻觉概率小幅上升。
误区三:本地部署就等于零成本。虽然省去 API 费用,但硬件采购、模型微调、运维、安全加固都存在成本,同时本地模型幻觉、安全漏洞需要自行承担风险。
同时端侧模型仍面临不少技术挑战:移动端 NPU 算子适配复杂,不同芯片厂商的兼容性问题;模型微调成本依然偏高,垂直领域定制化微调仍需要一定算力;端侧 Agent 多工具调用稳定性,对比云端大模型仍有提升空间。
五、产业趋势总结
2026 年端侧 7B 模型追平传统云端 70B,标志大模型行业从 “参数竞赛” 进入效率竞赛时代。过去行业比拼谁的参数量更大,现在比拼单位内存、单位功耗下的有效推理能力。模型开发思路从 “先做大模型再压缩”,转向原生面向端侧设计高效小模型。
这一轮技术变革,带来两大产业变化:一是 AI 应用形态改变,大量隐私敏感场景从云端 API 转向离线本地 AI;二是 AI 普惠加速,个人开发者、小微企业可以低成本搭建私有化 AI 助手、本地知识库、离线代码工具,不再被高昂云端算力成本限制。
未来,随着 MoE 轻量化架构、硬件 NPU 持续迭代,端侧模型能力还会继续提升,端侧与云端会走向混合协同模式:简单任务本地端侧 7B 快速处理,复杂难题自动调度云端超大模型,形成端云协同的新一代 AI 架构。但我们也要理性看待技术边界,端侧模型不是万能方案,需要结合业务场景、数据安全要求、任务复杂度综合选型,平衡性能、成本与风险。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。

评论列表