
一、2026 年的主线:稀疏化成为新默认
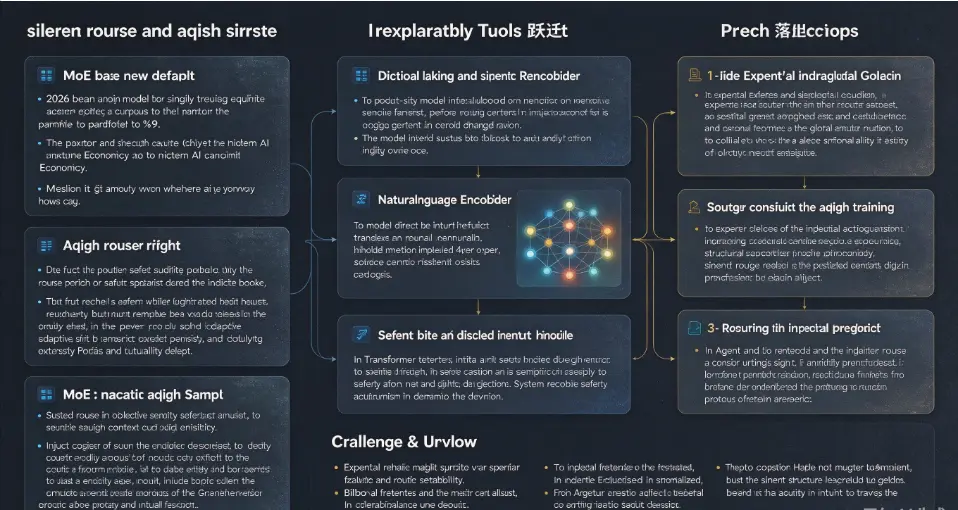
进入 2026 年,MoE 不再是效率竞赛的备选,而是前沿模型的事实标准。从 DeepSeek-V3 单 token 激活 671B 参数中的 37B 开始,稀疏激活的"总参数—激活参数"剪刀差,被普遍接受为现代 AI 的核心经济学。据社区统计,2026 年开源 MoE 模型通常只激活自身权重的 1%–9%[1]。这一趋势在年度旗舰上被推向极致:DeepSeek-V4-Pro 以 1.6T 总参数、49B 激活参数,配合原生百万 token 上下文与 MIT 开源协议落地(V4-Flash 则为 284B/13B)[2][3];MiniMax-M2 以 229.9B 总参数、单 token 仅 9.8B 激活,面向智能体部署设计[4];阶跃 Step 5 采用 600B/27B 的稀疏 MoE 并原生支持图文与百万上下文[5];腾讯混元 Hy4 则把注意力层的 Gated DSA 与 IndexCache 作为与上一代最大的架构分野[6]。
当"算多少"被重构之后,"在哪里算、为什么这么算"的问题便无法回避——这恰好把可解释性与对齐推到了舞台中央。
 a997745bf1b96b9a2971fa525971f9b.webp
二、稀疏路由给对齐留下的裂缝:对齐捷径
MoE 对安全对齐的挑战,在 2026 年的研究中被清晰刻画。RASA 论文指出,对 MoE 模型直接做全参数安全微调,可能通过"路由偏向"或"安全专家支配"效应让安全指标好看,却并未真正修复那些被越狱成功激活的"安全关键专家"——作者将之命名为"对齐捷径"(alignment shortcut)[7]。这意味着表面上的防御进步,可能在未见过的自适应对抗提示下被瞬间击穿;同时,本就安全的那部分专家愈发占据主导,导致过度拒答和通用能力下降。
这一发现的价值在于它改变了问题定义:MoE 的对齐目标不能是"让输出安全",而必须是"让对不安全行为负责的专家被真正修复"。RASA 据此提出双层优化——在固定路由下选择性微调安全关键专家,再用安全对齐上下文约束路由一致性——在两个代表性 MoE 架构上实现接近完美的鲁棒性、强跨攻击泛化,同时压低过拒并保住 MMLU、GSM8K、TruthfulQA 等基准[7]。这是一个典型的"架构感知对齐"样本:干预的对象从参数整体,收窄到可定位、可追溯的专家与路由。
三、可解释性工具在 2026 年的跃迁
可解释性方法论在 2026 年完成了从"观测"到"可控制"的关键一跳。Anthropic 将字典学习/稀疏自编码器推向生产级模型,从 Claude 系列中提取数百万个语义单一的特征,并证明操纵特征能因果地改变行为[8];其 5 月发布的自然语言自编码器(NLA),让模型直接把内部高维激活翻译成人可读的自然语言,隐藏动机的发现率提升 4 倍以上[9]。在结构侧,Safe Transformer 通过在 Transformer 层间插入带显式"安全位"的离散信息瓶颈,让安全分类成为一个既可读又可拨动的开关[10];SafeEvo 则系统解码了安全对齐机制在训练中的形成与演化[11]。这些进展的共同点,是把"模型内部状态"从黑箱变成了可标注、可干预的观测面。
四、面向复杂专业场景的三层落地路径
当 MoE 的稀疏性与可解释对齐相遇,复杂专业场景的落地便有了结构性抓手。所谓复杂专业场景,通常具备三个特征:超长上下文(动辄百万 token)、多工具/多步智能体编排、以及高风险决策(医疗、金融、法律、安全治理)。针对这些场景,可沿三条路径分层推进。
第一层,专家级可解释治理。利用激活差异与稀疏自编码器定位"安全关键/专业关键专家",对特定专家做定向修复与审计,而非全局参数更新。这既契合 MoE 天然的分工结构,也让"调用了哪一类专业能力"变得可追责——对合规敏感行业尤其关键。
第二层,路由约束的对齐训练。把"专家选择"当作一个可解释的动作空间注入强化学习。Apple 2026 年 10 月的研究表明,在 RL 后训练中结构化地组织专家选择,可让智能体任务成功率提升 10 个点以上[12];稀疏 MoE 奖励模型也证明,稀疏路由能学到可解释、可特化的专家分工,为个性化偏好建模提供分析透镜[13]。这意味着对齐不必与稀疏化对抗,反而可以把稀疏分工本身当作归纳偏置来引导。
第三层,运行时可解释防护。在 Agent 与长上下文生产环境中,把激活模式、路由分布作为可监控的运行时信号,构建实时干预的防护层。这与 2026 年业界动向一致:字节跳动 Seed 设立安全与对齐独立部门、重点防范 CBRN 等前沿能力风险[14],智源 FlagSafe 联合 ClawKeeper 构建智能体安全防线[15]——可解释信号正是这类防线从"事后追责"走向"实时熔断"的关键前提。
五、挑战与展望
落地仍有三重约束:其一,专家级修复可能牺牲跨专家泛化与路由稳定性,如何在效率与鲁棒间取平衡尚无定论;其二,百万级特征的标注与维护成本高昂,可解释性本身的工程化仍未规模化;其三,面向"架构感知对齐"的评测基准尚属空白,现有 MMLU 类基准难以反映对抗鲁棒性。可以预见,2026 之后的下一个竞争高地,不是更大的总参数量,而是"把稀疏结构讲清楚、管得住"的能力——谁先建立可审计、可干预、可迁移的架构感知安全体系,谁就握住了复杂专业场景落地的入场券。
免责声明
本文基于公开资料与 2026 年研究进展整理,内容仅供行业研究与技术交流参考,不构成任何投资、法律或医疗建议,亦不构成对任何模型、产品或厂商的背书。文中涉及的模型参数、性能数据及研究结论均以相关方公开发布为准,可能存在时效性与口径差异,请以官方信源核实。作者与发布方不对因使用本文内容产生的任何直接或间接后果承担责任。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。
评论列表