
一、引言:2026 大模型学习的资源困境
随着大模型开源生态持续繁荣,普通开发者已经可以低成本获取模型权重,但是 “看懂模型调用” 和 “掌握底层训练” 之间仍存在巨大鸿沟。2026 年 AI 开发者调研数据显示,74% 的模型研发从业者反馈,在学习 Transformer 进阶改造、多模态端到端训练时,面临资源零散、案例老旧、理论和工程脱节的问题。很多网上教程仍停留在原始 Transformer、CLIP 对比学习的基础版本,无法覆盖线性注意力、滑动窗口注意力、MoE 专家路由、原生多模态统一自回归建模等 2026 年主流技术方向。
传统学习路径大多是先学习基础 NLP,再零散阅读论文,缺少完整的工程落地链路,导致大量学习者能够看懂论文公式,却无法复现模型训练过程。多模态领域变化尤为显著,行业已经从早期 “冻结 LLM + 视觉编码器” 的桥接式融合方案,转向文本、图像、音频、视频共享同一套 Transformer 主干的原生多模态架构,旧资料中的多模态训练范式已经不再适配最新研发实践。因此,本文整合高校公开课、HuggingFace 官方教程、头部开源项目、顶会论文集四类权威资源,按照难度分层,构建一套完整的进阶学习体系。
 4e450c7ed123cf349f01e6d18679083.webp
二、Transformer 进阶专题权威资源
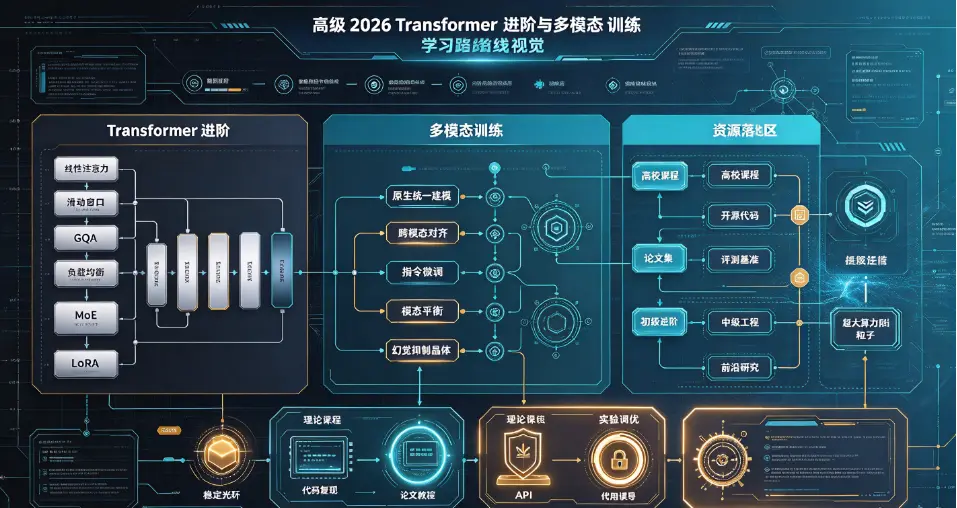
Transformer 是当前所有大语言模型、多模态基础模型的底层骨架,进阶学习不再局限于多头注意力基础公式,重点聚焦注意力优化、MoE 架构、上下文扩展、参数高效微调四大方向。
高校课程资源首选 CMU 2026 春季高级自然语言处理课程,课程后半段专门讲解 Transformer 变体架构,包含线性注意力、稀疏注意力、分块注意力理论推导,配套实验代码,适合研究生和算法工程师深入理解架构改进思路。斯坦福大学 CME295《Transformers & Large Language Models》课程,聚焦工业界落地视角,讲解预训练数据清洗、并行训练策略、MoE 路由负载均衡问题,弱化纯数学推导,强化工程实践,非常适合希望上手训练模型的开发人员。
博客与可视化资源方面,Jay Alammar 系列图解文章依旧是入门进阶的优质材料,《The Illustrated Transformer》衍生更新版本补充了 Mamba、线性注意力、滑动窗口注意力的可视化解析,直观对比不同注意力机制的算力开销差异。Sebastian Raschka 的技术专栏持续更新 2026 年 Transformer 优化方案,包含量化训练、FP8 精度下注意力计算的细节,代码示例全部基于 PyTorch 原生实现,可直接运行。
开源代码仓库推荐 karpathy/nanogpt,极简 Transformer 实现,是理解底层代码逻辑的标杆项目;datawhalechina/self-llm 提供完整的预训练、LoRA、全参数微调全套工程脚本,支持在单卡、多卡环境快速跑通实验,国内开发者社区维护活跃,中文文档完善。Firefly 大模型训练框架整合多种参数高效微调方案,支持 MoE 模型微调,内置训练日志可视化模块,降低大规模实验管理成本。
核心论文阅读清单,重点阅读线性注意力、滑动窗口注意力、MoE 负载均衡相关成果,包括 Mamba 结构化状态空间模型、GQA 分组查询注意力、混合专家路由优化相关顶会论文。学习重点跳出原始 Transformer,理解不同注意力变体在显存、速度、长上下文能力之间的取舍关系,这是 2026 年模型架构优化的核心考点。
三、多模态模型训练权威教程与开源资源
2026 年多模态训练范式发生根本性变革,行业重心从 CLIP 式对比学习、LLaVA 桥接式图文对齐,转向原生多模态统一建模,用一套 Transformer 主干处理文本、图像、音频、视频全部模态,统一使用下一个 token 预测目标。对应学习资源分为理论课程、训练框架、数据集、复现项目。
课程资源:Hugging Face 计算机视觉与多模态专项课程,免费自助学习,包含 CLIP、SigLIP、LLaVA 系列模型训练教程,覆盖图像编码器接入、跨模态对齐、多模态指令微调全流程,配套可直接运行的 Colab 代码。CMU 多模态机器学习研究生课程,讲解模态表征对齐、早融合、中融合、晚融合、原生统一建模四种架构范式,对比不同方案的训练开销与性能上限,适合做底层原理研究。
开源工程资源:LLaVA 系列仓库提供多模态指令微调完整脚本,2026 更新版本支持原生多模态模型训练,支持图文、图表、截图理解数据集训练。Hugging Face Transformers 与 Diffusers 库持续迭代多模态训练组件,支持 SigLIP、Qwen-VL、LLaVA 等主流模型的训练与评估。LAION 在 2026 年发布 BVD 大规模视频数据集,包含千万级带标注视频片段,是视频多模态预训练的核心公开数据资源。
论文阅读方面,优先阅读 2026 年 Nature 发表的原生多模态自回归建模论文,该成果证明单一自回归目标可以统一文本与图像的生成与理解任务;ICML 2026 多模态方向论文集,重点关注多模态数据过滤、模态不平衡问题、多模态幻觉抑制等工程痛点。多模态训练最大难点在于不同模态数据分布差异带来的模态坍塌,相关论文与开源项目的实验记录,是理解该问题最优质的一手资料。
四、资源分层学习路线与落地建议
本文把全部资源划分为三层学习路径,适配不同基础的学习者。
初级进阶层:适合已经掌握基础 Transformer、PyTorch 基础的开发者。优先学习斯坦福 CME295 课程、nanogpt 代码仓库,吃透 GQA、LoRA、长上下文窗口基础优化;动手完成小参数量语言模型预训练,熟悉数据预处理、多卡分布式训练基础流程。
中级工程层:目标掌握多模态指令微调。学习 HuggingFace 多模态课程,复现 LLaVA 图文对齐与指令微调实验,尝试使用 SigLIP 替换旧版视觉编码器,对比不同视觉编码器带来的效果差异。这个阶段重点理解跨模态桥接、模态对齐损失函数,积累多模态数据集清洗经验。
前沿研究层:面向模型自研、架构创新人员。研读 CMU 高级 NLP 课程、原生多模态统一建模论文,尝试基于开源框架搭建原生多模态 Transformer,开展 MoE 多模态模型训练实验,研究多模态幻觉抑制方案。
同时需要提示资源筛选避坑要点。2026 年大量网络教程依旧基于老旧晚融合多模态架构,这类方案已经不再是行业主流,学习者应当减少时间投入;区分 “模型调用教程” 和 “模型训练教程”,API 调用类内容无法帮助掌握底层训练逻辑。另外,多模态训练算力成本远高于纯文本大模型,新手建议从 7B 参数级别的小模型入手做实验,不要直接尝试超大参数量模型训练,避免算力资源浪费。
五、总结
2026 年大模型技术迭代速度持续加快,Transformer 各类改进变体、原生多模态统一建模成为行业核心能力。体系化学习不再是零散刷论文、看短视频教程,而是形成 “理论课程 — 代码复现 — 论文精读 — 实验调优” 闭环。本文汇总的高校公开课、开源项目、权威论文资源覆盖 Transformer 进阶、多模态训练全链路,兼顾理论深度与工程实操。学习者可根据自身基础,选择对应层级资源逐步推进,从理解注意力机制优化,到独立完成图文多模态模型训练复现,建立完整的大模型底层知识体系。未来随着多模态、具身智能相关技术持续演进,还需要持续跟进开源社区更新,及时补充新的数据集、训练框架与前沿论文,保持知识体系与时俱进。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。

评论列表