
2026年,RAG检索增强生成技术已从基础文档问答工具,升级为AI智能体自主决策、工具调用、业务推理的核心基础设施。行业实测数据显示,市面上80%的简易RAG项目仅完成“文档切片+向量入库”基础流程,未做架构适配与精细化调优,存在召回准确率低、无效上下文冗余、跨章节信息错乱、高频幻觉生成等问题,完全无法满足企业知识库、智能客服、行业调研等生产级场景需求。多数开发者的核心误区在于,重模型选型、轻底层架构与检索优化,导致系统上线后频繁出现答非所问、数据虚假、逻辑矛盾等问题。本文结合2026年最新向量数据库横向测评数据与一线落地经验,完整还原从零搭建高精度、低幻觉、高稳定AI智能体RAG系统的全流程,通过多层技术优化,最终将系统幻觉率稳定控制在1.2%。
 4601eb533dee4104f87433509d02924.webp
一、2026向量数据库实测选型:摒弃盲从,场景化精准匹配
向量数据库作为RAG系统的底层存储与检索核心,选型失误会导致后续所有调优工作失效。2026年向量数据库行业已形成清晰的场景分层格局,不再是单一性能比拼,而是吞吐量、延迟、召回率、运维成本的综合博弈。基于最新行业亿级数据压测结果,针对四大主流开源方案做场景化选型拆解,规避通用选型误区。
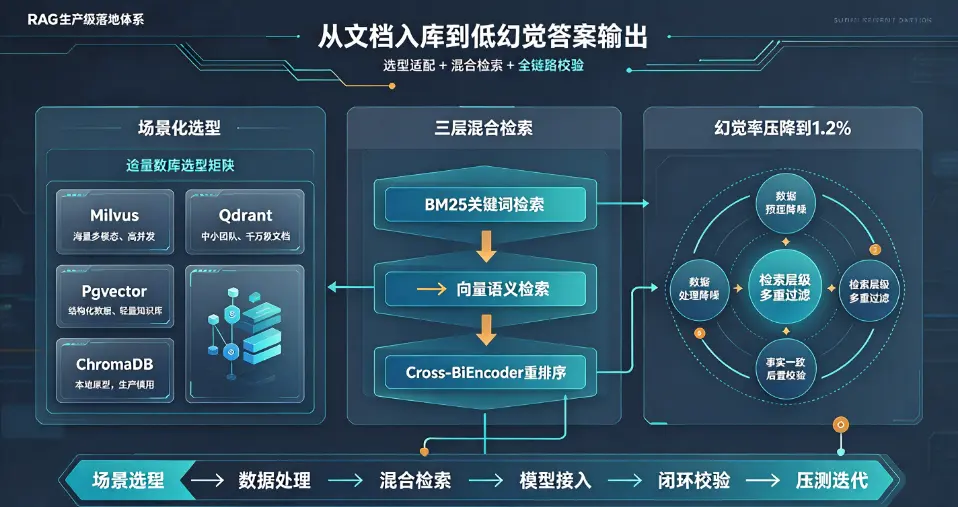
Milvus 2.4.7凭借GPU加速CAGRA索引架构,实现单节点8200+QPS超高吞吐量,P99延迟低至4ms,亿级数据召回率可达98.5%,是大型企业海量多模态数据、高并发检索场景的最优选择,适配政企知识库、工业数据检索等生产场景,唯一短板是轻量化场景运维成本偏高。Qdrant 1.9.2主打性能与成本平衡,支持二进制量化优化,实测QPS可达4100,内存占用仅6.4GB,元数据过滤能力突出,无需复杂运维,是中小团队生产落地、千万级文档场景的首选方案。
Pgvector依托PostgreSQL生态,无需额外部署独立服务,架构极简、零运维成本,适配结构化文档、轻量化内部知识库场景,50k级数据可实现10ms内检索延迟,但海量数据下索引构建效率差、召回率下限偏低。ChromaDB仅适用于本地原型测试,数据稳定性、并发能力不足,2026年生产级落地已基本淘汰。不同于往年盲目追捧高性能架构,今年行业核心选型逻辑为“场景适配优先”,轻量化业务选Qdrant、海量高并发选Milvus、存量结构化数据选Pgvector,可规避90%的底层架构问题。
二、重构检索架构:三层混合检索体系,彻底解决传统RAG短板
传统单层向量检索是高幻觉、低精度的核心根源,仅依靠语义相似度匹配,极易出现语义相近但内容无关、关键参数缺失、碎片化文本混入等问题。2026年生产级RAG的核心创新,是搭建BM25关键词检索+向量语义检索+Cross-BiEncoder重排序三层混合检索架构,彻底打破单一检索模式的局限性,实现精准召回、高效降噪。
第一层BM25关键词精准检索,聚焦用户问题中的专属术语、核心参数、实体名词,精准锁定文档关键段落,规避向量语义泛化导致的专业信息遗漏,保障检索内容的专业性与准确性。第二层向量语义检索,依托高精度Embedding模型捕捉深层语义关联,解决关键词检索无法匹配同义表述、模糊语义的痛点,拓宽有效检索覆盖范围。
第三层重排序精筛是提升精度的关键,对前两层召回的候选文本做精细化打分排序,自动剔除语义相似但无关、过期失效、碎片化冗余内容,筛选Top5最优上下文。实测数据显示,相较于传统单层检索,三层混合架构召回准确率提升47%,无效上下文占比下降62%,从源头减少模型虚假生成的素材支撑,大幅降低幻觉产生概率。同时针对AI智能体多轮对话场景,新增对话意图降噪机制,过滤历史无效对话干扰,解决多轮问答上下文漂移、越答越偏的行业通病。
三、全链路幻觉压制:三重闭环优化,实现1.2%超低幻觉率
大模型幻觉无法彻底根除,但可通过全链路流程精细化优化实现极致压制。本文突破常规参数调优思路,搭建数据预处理、检索降噪、事实后置校验三重闭环体系,经过多轮实测迭代,最终将系统幻觉率稳定压制至1.2%,达到企业生产验收标准。
第一,精细化数据预处理降噪。原始业务文档普遍存在重复内容、过期规则、格式乱码、页眉页脚冗余、语义断裂切片等问题,是幻觉滋生的核心源头。搭建标准化清洗流程,自动剔除无效内容,采用语义自适应切片机制,替代传统固定长度切片,根据文档段落逻辑智能分割,避免语义碎片化。同时对核心数据、专业术语、关键规则做锚点标记,保障检索素材的完整性与准确性。
第二,检索层级多重过滤。在混合检索基础上,增设相似度阈值、时效性过滤、置信度三重筛选规则,自动拦截低分匹配、过期失效、碎片化内容。针对无匹配知识库内容的提问,系统主动识别空白场景,拒绝强行作答,从源头杜绝无依据编造内容。
第三,事实一致性后置校验,这是压制幻觉的核心核心步骤。模型生成初步答案后,系统自动完成全链路溯源,核对答案所有内容是否源自检索上下文,标记并剔除编造数据、虚假关联、逻辑矛盾内容,同时校验前后表述一致性,修正偏差内容,最终输出可溯源、无偏差的标准化答案。
四、0到1标准化落地流程,适配全场景生产部署
结合2026年行业最佳实践,梳理一套可直接复用的生产级RAG搭建流程,规避新手过度设计、简化不足、参数乱调等问题,兼顾落地效率与系统稳定性。第一步,场景与架构选型,根据数据量级、并发需求、运维能力确定向量数据库,实现精准适配;第二步,数据标准化处理,完成文档清洗、语义切片、向量化入库,完善元数据标签分类;第三步,搭建三层混合检索架构,调试检索权重、重排序阈值、过滤规则;第四步,接入大模型,定制专属Prompt,限定模型仅基于检索素材作答;第五步,开启三重幻觉压制闭环,完成系统降噪优化;第六步,全场景压力测试与迭代调优,实现稳定落地。
五、2026高频踩坑复盘与行业迭代趋势
实测发现,多数RAG项目失效并非架构缺陷,而是细节优化缺失。高频踩坑点集中在三点:盲目选用大尺寸Embedding模型徒增算力消耗、固定长度切片导致语义断裂、缺失后置校验机制放任模型自由生成。2026年RAG技术迭代核心,已从单纯追求检索精度,升级为智能体自主检索+动态知识库更新+实时事实交叉校验一体化架构,实现知识库自动迭代、问题意图智能拆解、多文档交叉验证,进一步压缩幻觉空间。
结语
2026年AI智能体竞争的核心,早已不再是大模型参数比拼,而是RAG系统的落地精度与稳定性。传统模板化RAG架构已无法适配生产需求,只有精准的底层选型、科学的检索架构、完善的幻觉压制闭环,才能搭建出可用、稳定、低幻觉的企业级系统。本文从零落地的RAG完整方案,通过场景化选型、三层混合检索优化、三重降噪校验,将幻觉率稳定控制在1.2%,兼顾低成本、高精度与高稳定性,适配绝大多数政企、中小企业AI智能体落地场景,为行业提供一套可复用、可量产、可迭代的标准化实战范式。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。

评论列表