
2026 年,大模型产业已经跨过单纯比拼模型参数量的阶段,行业人才需求出现明显分化:AI 产品人员侧重模型能力边界与场景落地,应用开发工程师聚焦 RAG、Agent 与私有化部署,算法研究者则深耕模型微调、对齐、新型架构如 Mamba 与混合注意力模型。很多学习者的痛点在于资源泛滥、学习顺序颠倒,盲目收藏大量课程与论文,投入大量时间却无法产出可落地项目。
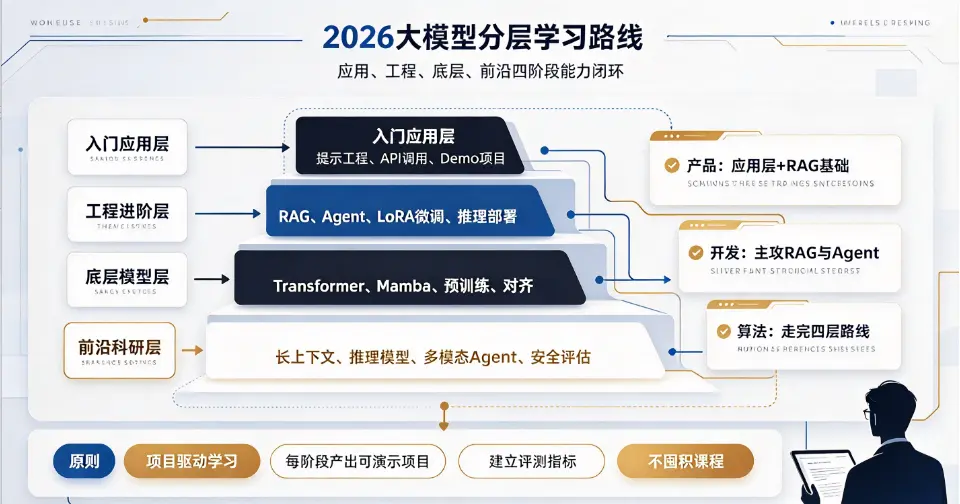
传统深度学习路线要求先学数学、深度学习理论,再接触大模型。但 2026 年产业实践证明,由应用反推原理是效率更高的学习范式。先学会调用模型、搭建应用,再回头深挖底层原理,避免在复杂公式中过早陷入停滞。本文将完整学习路径划分为四大阶段,配套经过筛选的课程、书籍、开源项目与社区资源,同时区分不同人群的学习侧重点,帮助学习者规划学习周期。
 e3430f4d8550846b335454d1b96ba28.webp
第一阶段:入门应用层,掌握大模型基础能力(1 个月,零基础可启动)
本阶段目标:理解大模型基本概念,精通提示工程与上下文工程,能够调用 API 完成简单 AI 应用,建立对大模型能力边界的认知。不需要精通深度学习数学推导,重点是建立 “大模型能做什么、不能做什么” 的直觉。
核心学习内容:Token、上下文窗口、嵌入向量 Embedding、模型幻觉、基础提示词、结构化输出、API 调用。2026 年提示工程早已不是简单的模板技巧,上下文工程、任务拆解、输出格式约束、安全护栏 Guardrails 成为核心。学习者可以使用 Dify、Coze 等低代码平台快速搭建知识库问答,快速验证想法,降低入门门槛。
课程资源:微软《Generative AI for Beginners》、Hugging Face LLM 入门课、OpenAI 官方 Cookbook。这类课程免费、案例丰富,全部提供可直接运行的代码片段,适合新手快速上手 API 调用与提示词实践。
书籍资源:《大语言模型应用实战》,侧重应用落地,弱化复杂数学推导。
开源项目:OpenAI Cookbook,包含大量 RAG、工具调用、评估案例。
学习产出:完成 2 个 Demo,基于 API 搭建文档问答机器人、结构化信息提取工具。
避坑提示:不要一上来就读 Transformer 原始论文,不要花费大量时间背诵提示词模板,重点练习如何定义任务、约束输出、识别幻觉。
第二阶段:工程进阶层,掌握 RAG 与 Agent 开发(2-3 个月,就业核心能力)
这是 2026 年企业招聘需求最高的阶段,也是从 “会用 AI” 升级为 “开发 AI 应用” 的分水岭。本阶段核心学习 RAG 全链路、Agent 智能体、模型微调、推理部署与效果评测。
核心学习内容:文档解析、文本分块、混合检索、重排 Rerank、向量数据库、引用溯源、幻觉评估;Function Calling、MCP 协议、LangGraph 多智能体编排、记忆管理、异常重试;QLoRA/LoRA 轻量化微调、DPO 偏好对齐;vLLM 推理加速、模型量化、Docker 封装、服务部署、可观测性。
2026 年 RAG 技术已经从简单向量检索升级为多模态文档解析、分层检索与答案校验;Agent 开发不再局限于简单工具调用,更加重视任务规划、状态持久化、人工介入机制,生产环境对稳定性、成本、延迟的要求显著提升。
课程资源:Hugging Face Agents 课程、斯坦福 CS224N(NLP 进阶)、上交大《动手学大模型》开源教程,配套完整代码与 PPT,覆盖微调、多模态、安全评估等内容。
书籍资源:《动手学深度学习》、《大模型微调实战》,强化工程实践。
开源项目:Langchain-Chatchat、RAGFlow、PrivateGPT。Langchain-Chatchat 是国内热度最高的开源知识库项目,代码结构清晰,适合学习私有化 RAG 工程落地;RAGFlow 擅长复杂 PDF、表格文档解析,贴合企业真实场景。
学习产出:搭建企业级私有知识库,开发支持多工具调用的单 Agent 应用,完成小领域模型 LoRA 微调并部署 API 服务。
第三阶段:底层模型层,深入模型原理与训练推理(2-4 个月,面向算法岗位)
完成工程应用学习后,如果希望向算法工程师方向进阶,需要深入模型底层原理。本阶段重点学习 Transformer、选择性状态空间模型 SSM/Mamba 架构、预训练原理、对齐技术、推理内核优化。2026 年行业趋势是混合架构,Mamba+Transformer 方案在超长上下文场景广泛落地,学习者不能只掌握传统自注意力架构。
核心学习内容:自注意力机制、KV 缓存、模型缩放定律;Mamba 选择性状态空间原理;预训练数据处理、数据清洗;SFT、DPO、RLHF 对齐;推理优化、连续批处理、量化原理。
课程资源:MIT 6.S191 深度学习公开课、[fast.ai](fast.ai) 深度学习实战课程。
书籍资源:《深度学习》(花书)、《动手学强化学习》,用于理解大模型后训练对齐所需的强化学习基础。
开源项目:Llama Factory、vLLM,覆盖轻量化微调、高性能推理引擎源码阅读。
学习产出:读懂大模型训练、推理核心源码,独立完成小规模预训练实验,对比 Transformer 与 Mamba 架构在长序列任务的性能差异。
第四阶段:前沿科研层,跟进最新技术迭代(长期持续学习)
2026 年大模型领域迭代速度极快,推理模型、多模态智能体、RWA、DePIN、混合架构持续更新。本阶段面向科研人员、高级算法工程师,持续跟踪前沿论文、行业报告与技术社区。
核心学习方向:长上下文架构、推理大模型、多模态 Agent、模型安全与对齐、模型评估体系。
资源:arXiv 预印本、Hugging Face 论文专栏、Anthropic、OpenAI 官方技术博客。
社区渠道:HuggingFace 社区、GitHub 大模型相关 Awesome 仓库、国内技术论坛,同步最新开源模型与评测数据。
分人群学习路线选择
产品 / 业务人员:学习停留在第一阶段 + RAG 基础,掌握提示工程、模型能力边界、场景方案设计,不需要深入代码与微调。
后端 / 应用开发工程师:主攻第二阶段 RAG 与 Agent,兼顾基础原理,目标是独立交付生产级大模型应用,是 2026 年岗位需求最大的方向。
算法研发人员:完整走完四个阶段,深入模型底层、训练、对齐、新型架构。
学习避坑与资源使用原则
2026 年互联网上 AI 学习资源爆炸,大量低质量教程、过期内容消耗学习者精力。学习核心原则是项目驱动学习,每学一个知识点,必须落地到项目中验证。不要囤积课程,不要同时并行学习多个方向。
同时要重视评测思维,大模型工程不是跑通 Demo 就算完成,需要建立评估指标,测试幻觉、召回率、响应延迟、调用成本,这也是企业项目落地的核心要求。很多学习者可以快速搭建 RAG,但缺少评测与迭代能力,项目无法进入生产环境。
结语
2026 年大模型人才的核心竞争力,不再是单纯记住理论概念,而是基于业务需求,选择合适模型、搭建可靠应用、持续迭代优化的综合工程能力。这套分层学习路线,从入门提示工程到前沿架构研究,形成完整闭环。零基础学习者可以从应用层起步,快速产出可演示项目;有编程基础的开发者,可以向 RAG、Agent 工程方向深耕;算法方向学习者,再进一步深入模型底层与前沿论文。
大模型技术仍处在高速迭代周期,学习不是一次性完成,而是持续跟进开源项目、论文与社区动态。遵循 “先应用、后原理、项目优先” 的思路,避开无效内卷,才能在 2026 年 AI 行业抓住技术落地机会。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。

评论列表