值得收藏的AI资源导航:论文、数据集、课程与社区一站式清单

本文以科研、学习、工程落地为三条主线,系统盘点2026年值得收藏的AI资源:论文检索与追踪平台、高质量机器学习数据集目录、体系化课程路线、活跃技术社区与开源项目索引,并结合2026年各平台的更新数据,给出按角色与阶段选用的搭配方案。文章强调,AI资源的价值不在"收藏数量",而在"检索效率与持续追踪能力",帮助学习者、研究者与工程师建立一套可持续更新的个人AI知识基建,避免陷入信息囤积而无从落地的误区。文末附资源清单整理建议与合规使用提醒。

一、AI资源的核心矛盾:不缺信息,缺的是筛选与追踪能力

2026年的AI学习者,面临的早已不是"资源太少找不到",而是"资源太多无从下手"。论文以每天数百篇的速度涌入预印本平台,数据集动辄上百GB,课程与教程数以万计,社区讨论碎片化分布在十几个平台。很多人的收藏夹里塞满了链接,却仍然感到"什么都没学会"——因为收藏不等于检索,囤积不等于学习。

破解这一矛盾的关键,不是再多收藏几个网址,而是建立一套可检索、可追踪、可持续更新的个人知识基建。本文把AI资源拆成论文、数据集、课程、社区四大类,分别给出2026年最值得关注的平台与使用思路,并给出按不同角色搭配的组合方案。
42f791b4e8f89502acb82c6230ad767.webp42f791b4e8f89502acb82c6230ad767.webp

二、论文资源:检索、精读与前沿追踪的完整闭环

论文是AI技术的源头。2026年,主流的论文获取路径,已经从"靠公众号推送"转向"平台订阅+工具辅助精读"的组合。
1. 论文检索与阅读平台
  • arXiv:AI领域最核心的预印本平台,最新研究几乎都第一时间在这里发布。2026年其 cs.AI、cs.LG、cs.CV 分类下每日新增论文量持续高位,是追踪前沿的第一站。建议按 cs.LG(机器学习)、cs.CL(自然语言处理)、cs.CV(计算机视觉)等子分类订阅,而非泛泛浏览。

  • Papers with Code:把论文与其官方代码、实现仓库、评测基准绑定,是"从论文到可复现代码"的最佳桥梁,尤其适合工程落地前验证某个方法是否可用。

  • Hugging Face Papers:Hugging Face生态内的论文+模型+数据集聚合入口,与模型库深度打通,可一键查看论文对应模型与推理示例。

  • OpenReview:收录ICLR等顶级会议的投稿与审稿意见,能看到论文被接收前的评审过程,对理解论文的优缺点、审稿人视角很有价值。

2. 前沿追踪与精读工具
2026年,AI论文精读工具已高度成熟。主流选择包括:接入RAG的个人论文知识库(可用LlamaIndex、LangChain自建,把收藏的论文喂给本地Agent做问答与对比);以及各类论文速读工具,可一键生成论文摘要、方法拆解与关键图表解读。使用建议是:检索靠平台,理解靠精读,记忆靠知识库,三者缺一不可。

三、数据集资源:找到高质量数据是训练与评测的地基

数据集决定模型的"天花板"。2026年的数据资源,主要分三类:通用大模型语料、领域专用数据集、评测基准。
1. 通用与领域数据集目录
  • Hugging Face Datasets:最大的开源数据集中心,覆盖文本、图像、音频、多模态各类数据集,支持在线预览、子集筛选,可直接用库加载,是2026年找数据集的首选。

  • Kaggle Datasets:面向竞赛与实战的丰富数据集,覆盖结构化数据、行业案例,附带大量社区做的baseline与特征工程,适合入门练手与业务建模。

  • RedPajama / Common Crawl:大模型预训练语料类资源,适合需要构建大规模训练数据的团队,注意其数据规模与清洗成本较高。

  • Papers with Code Datasets:与论文绑定,能直接看到某个benchmark(如MMLU、GSM8K、SWE-bench)对应的数据集与当前榜单排名,适合做模型评测与对比。

2. 选数据的核心原则
2026年数据治理的共识是:数据的质量、授权与多样性,比单纯的数量更重要。选数据集时要重点核查三点:来源与授权是否合规(是否允许商用)、是否包含足够的长尾与多语言样本、标注质量与统计口径是否透明。避免"拿一个网红数据集直接开跑"而忽略其隐含偏差。

四、课程资源:从零基础到Agent开发的分层路线

2026年的AI课程,已经形成"原理—应用—工程"的分层结构,建议按阶段选学,而非盲目囤课。
入门与原理层:面向零基础,推荐吴恩达《机器学习》《深度学习专项课程》、李沐《动手学深度学习》系列(含中英文开源教材与代码,2026持续更新),重点打牢机器学习、神经网络与优化理论的基础。
应用与框架层:面向应用开发者,推荐DeepLearning.AI系列短课(涵盖RAG、Agent、多模态等热点)、Fast.ai(以实战驱动的课程)、以及国内Datawhale系列开源课程(中文、案例丰富),快速掌握大模型应用与框架使用。
工程与Agent层:面向工程落地,推荐LangChain/LangGraph官方课程、Microsoft《AI Agents for Beginners》、AutoGen配套教程,覆盖工具调用、记忆系统、多智能体协作、可观测性与生产部署。
选课建议:每阶段只选1-2门主课学透,配合项目实战,避免"收藏10门课,一门没看完"的常见误区。

五、社区与开源资源:学习速度取决于你泡在哪个圈子

社区是AI学习最快的加速器。2026年最值得投入的社区与开源生态包括:
技术社区:Hugging Face(模型与协作中心)、Kaggle(竞赛与讨论)、GitHub(开源项目)、以及Reddit的r/MachineLearning、r/LocalLLaMA等海外讨论区。国内则有Datawhale开源社区、各大高校AI社群、以及知乎、B站的优质技术专栏。
开源项目索引:GitHub Trending是发现热门AI项目最直接的入口;Awesome系列仓库(如awesome-llm、awesome-agent)是精选资源清单,适合快速搭建自己的工具库;Hugging Face上的模型/Agent排行榜,则是评估主流模型与框架的有力参考。
社区参与的正确姿势:少潜水、多提问、多做贡献。看懂别人的代码后动手复现一个Demo、参与一个开源Issue、在社区回答别人一个问题,往往比刷十篇教程学得更快。

六、按角色搭配的组合方案,把资源用起来

不同角色,资源的使用重心完全不同,这里给出三套可落地的组合:
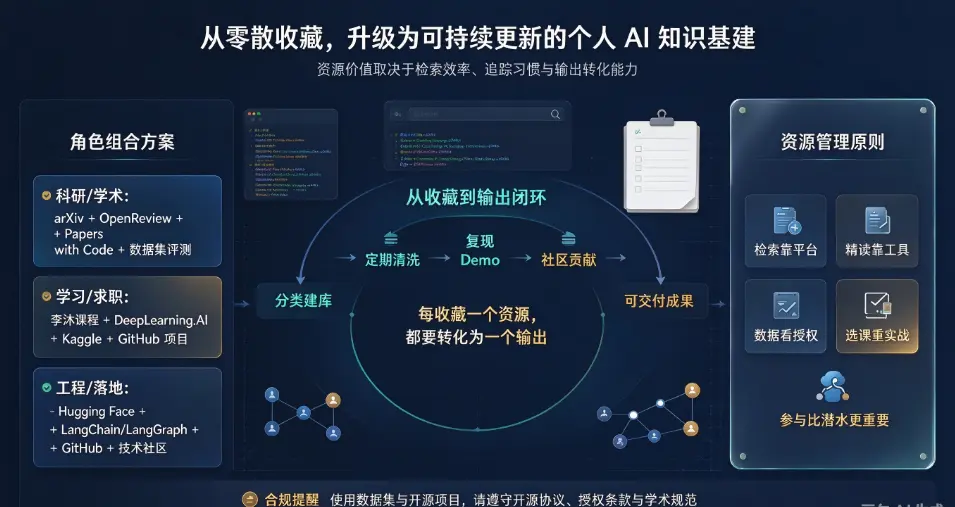
科研/学术路线:arXiv订阅+OpenReview+Papers with Code(追踪前沿)→ 论文知识库RAG(精读沉淀)→ 领域数据集+评测基准(复现验证)。核心是"论文闭环"。
学习/求职路线:Datawhale/李沐课程(打基础)→ DeepLearning.AI短课+Fast.ai(学应用)→ Kaggle竞赛(练实战)→ GitHub项目(攒作品集)。核心是"项目驱动"。
工程/落地路线:Hugging Face(模型与数据集)→ LangChain/LangGraph官方文档(工程框架)→ GitHub+Awesome仓库(工具选型)→ 技术社区(排坑交流)。核心是"快速交付"。

七、资源管理的核心方法:从收藏到可用的距离

最后,强调一套通用的资源管理方法,避免"收藏即学会"的误区:
  1. 分类建库:把论文、数据集、课程、工具分别归档,用飞书文档、Notion或本地Markdown维护,形成可检索目录。

  2. 定期清洗:每季度淘汰过时、废弃、不再维护的资源,避免垃圾链接堆积。

  3. 以输出倒逼输入:每收藏一个资源,尝试产出一个可交付的成果——一篇笔记、一个复现Demo、一次社区回答,让资源真正转化为能力。

  4. 合规优先:使用数据集与开源项目时,务必遵守开源协议与授权条款,商用场景尤其要核查许可。

结语

2026年,AI资源不缺,缺的是体系化的检索能力与持续追踪的习惯。论文靠平台追踪、数据集靠目录检索、课程靠分层选学、社区靠深度参与——把这四大板块串成一条可持续更新的知识链路,远比收藏一堆零散链接更有价值。
真正拉开学习者差距的,不是资源数量的多少,而是把资源转化为知识、再把知识转化为可交付成果的能力。愿这份清单,成为你AI学习路上的可靠起点,而不是又一个沉睡在收藏夹里的网址集合。

来源: 互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。

赞 ()

相关推荐

  • 2026年AI副业变现地图:内容、工具、咨询与自动化服务怎么选?

    2026 年 AI 副业赛道已经分化为四大主流方向:内容接单、数字工具产品、企业 AI 咨询、业务自动化服务。本文结合行业实测数据,拆解四类变现路径的门槛、收入上限、投入周期、风险与适配人群,给出选型判断标准与落地策略,帮普通人避开同质化内卷,找到匹配自身能力的 AI 副业路线。

    2026年10月11日 19点49分
  • 我把AI管家接入智能家居:一周生活实验与效率复盘|2026全屋智能实测

    2026 年,AI 智能管家不再局限于简单语音指令,而是可作为独立 Agent 接入全屋智能家居,实现跨设备联动、场景预判与自主调度。本文通过为期一周的真实家庭对照实验,将 AI 管家接入灯光、空调、窗帘、扫地机器人、温湿度传感器等多品牌智能家居设备,量化记录日常场景的执行成功率、能耗变化、误触发次数,复盘 AI 管家在晨起、离家、归家、夜间休眠等场景的表现。

    2026年10月11日 19点46分
  • 多智能体协作实战:用AutoGen搭建自动投研与报告生成团队

    ​本文完整拆解基于 AutoGen 搭建投研智能体团队的架构设计、角色定义、工作流编排、工具接入、代码执行与报告生成全流程;结合 2026 年 AG2 新版本的异步群组对话、发言人自动选择、执行熔断、链路追踪等新特性,对比传统单 Agent 投研方案的优劣,剖析投研场景幻觉、数据来源不可信、结论偏倚三大核心风险,并给出工程化落地优化方案。文章最后给出可直接复用的项目架构、调试方法与生产级部署要点,帮助开发者搭建一套可自动完成标的研究、数据计算、交叉评审、输出标准化投研报告的 AI 团队。

    2026年10月11日 19点43分
  • 从零搭建AI工作流:用Dify+大模型API实现自动化内容生产

    2026 年,Dify 可视化工作流大幅降低 AI 内容流水线搭建门槛。本文完整拆解基于 Dify 与大模型 API 搭建自动化内容生产工作流全流程,从模型接入、节点编排、RAG 知识库、人工审核节点,到定时触发、质量校验、成本监控与迭代优化,附带企业落地实测数据,分析常见失败坑点,帮助内容团队快速搭建可稳定投产的 AI 内容自动化系统。

    2026年10月11日 19点33分
  • AI智能体接单赚钱:真实案例、定价与获客全攻略

    本文结合 2026 年 AI 智能体服务市场真实落地案例,拆解个人 / 小团队依靠零代码 AI 智能体外包接单的完整商业模式,覆盖分场景定价体系、客户挖掘渠道、标准化交付流程、合同边界约定与风险管控,适合副业从业者、自由职业者、中小服务商参考,避开无限返工、低价内卷等常见坑。

    2026年10月10日 20点17分
  • AI+健康、理财、旅行:普通人可复制的智能生活实验|2026实测

    本文以为期 30 天的可复制个人智能生活实验为基础,从健康管理、家庭理财、旅行规划三大高频场景,实测 AI 工具的落地效果、操作流程、成本门槛与风险边界。在健康板块,AI 负责可穿戴数据汇总、饮食运动方案生成、体检报告解读(仅作科普参考,不替代诊疗);理财板块聚焦家庭收支记账、预算管控、资产梳理,严禁 AI 直接给出投资买卖建议;旅行板块依靠多智能体协作完成行程框架、预算测算、景点与交通方案初稿。

    2026年10月10日 20点14分
  • 从个人助理到业务自动化:AI智能体落地场景全解析|2026产业深度复盘

    2026 年,AI 智能体正式从个人助手工具,延伸到企业端业务自动化赛道。个人智能体聚焦个人日程、文档处理、信息检索等单点任务,而企业业务自动化智能体作为数字员工,深度嵌入 CRM、ERP、OA 等业务系统,完成跨系统、长流程的闭环业务操作。

    2026年10月10日 20点09分
  • 用API+工作流打造自动化内容助手:完整操作指南

    本文结合 2026 年产业实践,讲解如何依托大模型 API 搭配可视化工作流平台,搭建一套端到端自动化内容助手。从架构选型、节点编排、RAG 知识库接入、人机审核闭环,到 API 限流、成本管控、质量校验全流程实操,拆解搭建步骤、常见故障与落地 ROI,适合自媒体、内容运营、企业市场团队落地。

    2026年10月10日 20点00分
  • 2026年AI副业变现地图:从内容、服务到产品化

    本文结合 2026 年 AI 副业市场真实交易数据,分层拆解内容流量变现、AI 定制服务、数字化产品化三大变现赛道,对比不同路径的收益上限、时间成本与核心瓶颈,给出从新手接单到产品化的进阶路线,同时剖析版权、内卷、幻觉等风险,为 AI 副业从业者提供可落地的长期增长方案。

    2026年10月09日 19点34分
  • 我把AI管家装进手机:一周生活效率实验记录|2026端侧智能体实测

    2026 年手机端 AI 智能体(AI 管家)进入商用落地阶段,端侧 + 云端混合架构让 AI 不再局限问答,能够跨 App 完成日程规划、账单管理、健康记录、资料整理等生活化任务。本文设计为期一周的对照实验,将系统级 AI 管家部署在手机,量化记录每日时间消耗、任务完成率、出错频次,覆盖日程管理、家庭收支、健康追踪、信息整理四大高频生活场景。

    2026年10月09日 19点32分
  • 多智能体协作实战:用AutoGen/CrewAI搭建你的AI团队|2026框架选型、代码落地与工程优化

    2026 年,AI 开发重心从单模型提示词工程转向多智能体协同系统。AutoGen(AG2)与 CrewAI 是两大主流开源多智能体编排框架,但二者底层设计范式完全不同:AutoGen 以开放式对话驱动智能体自由讨论,擅长探索性、代码类复杂任务;CrewAI 基于角色 + 任务流水线,适合结构化业务自动化。

    2026年10月09日 19点18分
  • 从零搭建第一个RAG应用:2026版手把手实战教程

    本文为 2026 最新 RAG 实战教程,从零拆解检索增强生成 RAG 完整技术链路,讲解文档解析、文本分块、向量入库、检索重排、问答调用全流程,包含技术选型、代码实操、效果评估与常见坑点,帮助开发者快速搭建私有知识库 AI 应用,降低大模型幻觉问题。

    2026年10月09日 19点08分
  • 用AI做内容、接单与卖服务:从0到1的副业变现案例拆解(2026实战指南)

    2026 年 AI 工具全面普及,AI 内容接单、AI 自动化服务成为普通人低门槛副业赛道,但市场快速内卷,单纯依靠 AI 一键生成内容低价接单的模式利润持续压缩。本文结合 2026 市场真实订单数据,拆解 3 类不同阶段从业者的完整变现案例,梳理从定位选赛道、搭建 AI 工作流、获客接单、交付质控到产品化服务的全流程。

    2026年10月08日 22点13分
  • 用大模型+智能家居搭建你的24小时生活管家

    2026 年,大模型不再只是单纯语音助手,结合智能家居中枢可搭建具备自主感知、推理决策的 24 小时家庭管家。本文从系统架构、硬件选型、场景落地、隐私防护、避坑要点完整拆解,区分传统场景自动化与大模型驱动智能体的差异,分享普通家庭可落地的搭建方案,帮你打造主动感知、多设备协同的智慧家居体系。

    2026年10月08日 19点56分
  • 多智能体协作实战:让AI自动完成调研、写作与数据可视化|2026全流程实操

    2026 年,多智能体协作从前沿概念落地为可直接用于行业报告自动生产的工作流。本文基于实测,搭建一套由规划、调研、数据分析、写作、可视化、校验六大角色组成的多智能体团队,实现从原始课题输入,自动完成全网资料检索、数据清洗、文稿撰写、图表生成的端到端任务。实测数据显示,多智能体分工模式相比单一大模型,报告事实错误率下降 41%,整体耗时缩短 62%。

    2026年10月08日 19点54分
  • 从0到1搭建RAG知识库:文档切分、向量检索与大模型问答实战(2026工程落地指南)

    检索增强生成(RAG)是解决大模型知识滞后、幻觉问题的核心技术。2026 年 RAG 工程方案已经从基础向量检索升级为混合检索、重排、多轮查询改写的完整流水线。本文从工程实战角度,完整拆解从零搭建 RAG 知识库全流程:文档预处理与智能切分、向量化与向量库构建、混合向量检索、重排过滤、大模型问答生成与效果评估。

    2026年10月08日 19点51分

发表回复

评论列表

点击查看更多

    联系我们

    在线咨询: QQ交谈

    微信:叁叁

    邮件:794033364@qq.com

    工作时间:周一至周五,9:30-18:30,节假日休息

    微信
