
2026 年全球数据监管持续收紧,金融、政务、医疗、科研等高敏感业务对数据出境、跨网传输的限制不断加码。云端 API 模式需要将提示词、业务文档、推理上下文上传至第三方服务器,数据留存、跨境传输、服务商侧泄露风险长期无法根除。零外网物理隔离的本地私有部署 AI,被大量企业视作实现 “数据不出域” 的核心方案。但行业内普遍存在认知误区:只要切断外网,本地 AI 就是绝对安全。本次测评搭建空气隔离实验室,全程无任何外网连通,设置消费级工作站、企业 GPU 工作站、多卡服务器三组硬件平台,选用 Qwen3、DeepSeek、Llama4 系列开源模型,搭配主流推理栈完成全维度对照测试,量化安全风险与性能边界,还原零外网环境真实落地现状。
 247f9e940ded48b5da49140ab20de70.webp
一、零外网环境数据安全深度测评:链路防护与隐形漏洞
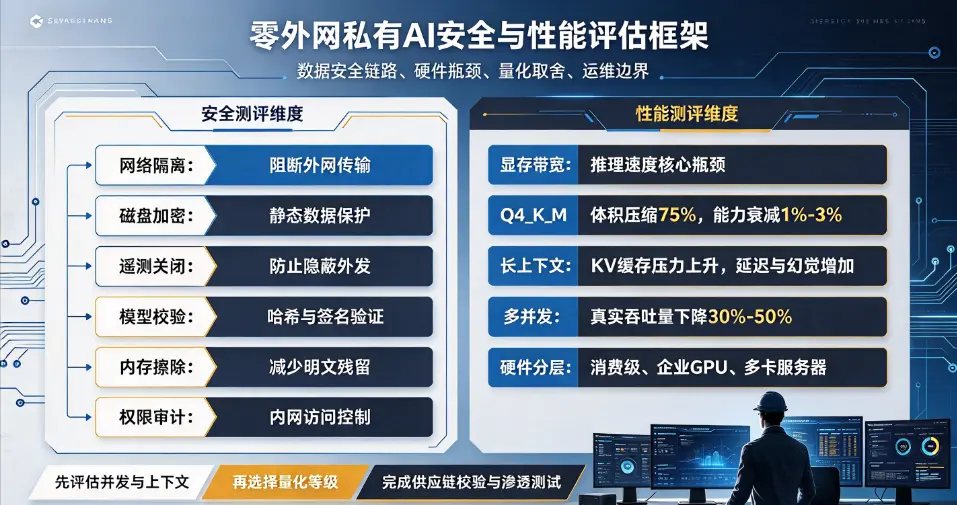
物理隔离架构的核心优势,是从网络底层阻断业务数据向外传输。所有用户提示词、知识库文档、模型推理输出、会话日志全部存储在内网本地存储,磁盘开启 AES-256 静态加密,内网内部通信采用 TLS1.3 加密传输,天然规避云端 API 带来的数据外溢、服务商留存、跨境合规等问题。系统可对接企业 RBAC 权限体系,实现分级访问、全操作审计日志,满足 ISO27001、行业数据保护规范,这也是涉密场景优先选择空气隔离部署的底层原因。
但本次实测证明,网络断开不等于安全闭环,大量隐形安全风险被行业忽视。第一是推理软件遥测隐患,2026 年隐私审计报告显示,Ollama、部分 WebUI 前端、容器套件默认开启版本检查、遥测采集功能,即便断网,配置文件、会话元数据仍会尝试缓存上报;若运维人员后续接入外网更新,缓存数据会一次性外发。在零外网部署规范中,必须在离线部署前修改配置、完全关闭更新校验与遥测模块,否则存在隐蔽数据泄露通道。
第二是模型供应链投毒风险,这是 2026 年私有化部署最大安全痛点。零外网环境下,模型权重、依赖包、推理脚本都需要提前下载,通过加密 U 盘离线导入内网。攻击者可污染开源仓库,将带后门的 GGUF 模型、恶意部署脚本伪装成官方版本。一旦导入内网服务器,加载权重时恶意代码即可读取服务器环境变量、内存中的明文会话,在特定触发词下泄露内部业务信息。防御手段必须增加模型哈希校验、签名验证,所有离线介质导入前完成病毒扫描,建立模型资产仓库,杜绝随意从第三方镜像下载权重文件。
第三是内存明文残留漏洞。推理过程中,提示词、文档片段会在 GPU 显存、服务器内存中以明文形式短暂留存。如果服务器未做内存擦除机制,硬件故障、硬盘维修、内存拆卸时,敏感业务内容存在被提取的风险。2026 年披露的 Ollama 内存读取漏洞(CVE-2026-7482)证实,内网攻击者可通过接口读取内存片段,窃取会话内容,即便设备没有外网访问权限,内网横向渗透攻击依然成立。
权限层面,很多企业仅简单部署模型,未开启身份认证,推理端口对内网全部开放。内网任意终端均可调用 AI 接口读取历史对话,这是零外网场景极易忽略的内网横向风险。完整安全加固方案包含:磁盘加密、关闭全部遥测、模型哈希校验、细粒度账号权限、操作审计日志、内存数据擦除策略、内网防火墙端口限制。仅做断网处理的简易部署,安全防护能力远低于行业预期。
二、性能实测:显存带宽为核心瓶颈,量化方案的取舍
本次测评设置三组硬件,在零外网环境下完成多模型、多上下文长度对照测试。实测验证:显存带宽,而非 GPU 算力,是本地大模型推理速度的决定性因素。在消费级 RTX5090(32GB GDDR7),运行 70B 模型 Q4_K_M 量化版本,交互式推理速度稳定在 14\22 token/s;企业级单卡 H200 服务器,同模型推理速度可达 35\42 token/s;纯 CPU 32G 内存环境,7B 模型推理仅 5~15 token/s,仅适合后台文档批量处理,无法支撑人机实时对话。
量化技术是零外网落地的关键。2026 年 GGUF 格式成为离线部署标准,Q4_K_M 是绝大多数企业的最优选择。实测 Q4_K_M 量化相比 FP16 原版,模型体积压缩 75%,显存占用大幅下降,MMLU、推理基准测试分数仅下降 1%~3%;而 Q3 及以下低位量化,显存占用更低,但逻辑推理、工具调用能力衰减明显,长文本幻觉率显著上升,不适合业务生产环境。FP8 量化在企业高端硬件上效果更佳,模型能力几乎无损,但对显存容量要求更高,硬件成本成倍提升。
长上下文场景是本地部署的短板。当上下文窗口超过 32K token,KV 缓存占用显存快速膨胀,低配硬件会触发内存交换,推理延迟飙升,幻觉概率明显上涨。很多厂商宣传百万 token 上下文,但在零外网生产环境,受限于显存容量,长文本能力很难达到基准测试效果。在 RAG 知识库场景,建议拆分文档分片,限制单次上下文长度,降低 KV 缓存压力,平衡响应速度与内容准确性。
多并发场景下,本地推理吞吐量远低于云端集群。基准测试的吞吐量数据,基于最优批处理请求;真实业务零散请求场景,实际吞吐量会下降 30%~50%。如果业务存在数十人同时在线查询,单工作站方案会出现排队、响应卡顿,需要多卡分布式推理,硬件投入、离线运维复杂度同步上升。
三、零外网部署运维成本与适用边界
零外网架构最大短板在于运维复杂度。所有模型更新、系统补丁、Python 依赖包、知识库增量文件,都需要在外网环境下载、校验查杀,通过物理介质导入内网。无法自动升级,漏洞修复高度依赖人工运维,安全补丁滞后,攻击面会随时间持续扩大。多模态模型权重体积庞大,离线分发、哈希校验流程繁琐,版本管理成本很高。
从业务适配角度,零外网私有 AI 更适合低并发、高敏感的文档解析、内部知识库问答、合同审阅、涉密资料摘要等场景。而高并发内容生成、实时多模态创作、高频 Agent 工具调用场景,硬件投入巨大,综合性价比偏低。
企业选型不能只看模型参数,应当建立完整评估体系:第一步评估业务并发与上下文长度,确定显存需求;第二步选择量化等级,优先 Q4_K_M,显存充足可升级 Q5;第三步搭建供应链校验机制,关闭全部遥测,配置内网访问控制与审计日志;最后做压力测试与渗透测试,验证内存残留、内网接口安全。
四、测评总结
2026 年本地私有 AI 已经可以在零外网环境实现高质量业务推理,但 “断网 = 绝对安全” 是典型认知误区。空气隔离只能阻断外网数据泄露,模型供应链投毒、内存明文、内网未授权访问、遥测缓存等风险依然存在。性能层面,显存带宽决定推理上限,量化压缩是落地的核心手段,同时必须接受模型能力小幅衰减、运维成本上升的代价。
对于企业决策者,零外网 AI 不是万能方案,需要权衡安全收益、硬件成本、人力运维开销。在高敏感场景,完整安全加固 + 合理硬件选型,本地私有部署可以实现数据主权;普通非敏感业务,云端 API 配合数据脱敏,往往拥有更高投入产出比。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。

评论列表