
引言
本文面向企业 IT、产品、研发人员,完整拆解 3 小时落地实战流程,选用轻量化技术栈,不需要复杂后端开发,同时加入 2026 年 RAG 工程化核心优化手段,解决检索不准、答案幻觉、文档切片断裂三大痛点,搭建一套可以查询企业私有 PDF、Word、Markdown 文档的 AI 助手。
 68893b255d7b5ef65aa68205d46cde8.webp
一、前期准备:最小可用技术栈选型与资源评估(0~30 分钟)
技术栈选型(2026 轻量化组合)
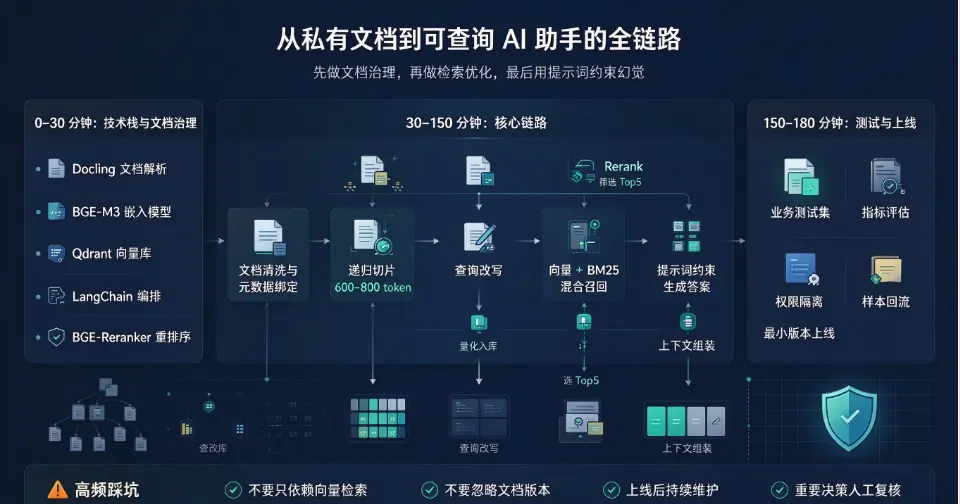
文档解析:Docling,支持 PDF、Word、PPT、Excel 多格式解析,自动保留标题、表格结构,相比传统 PDF 解析工具,大幅降低表格、图文混排文档的解析失败率;
嵌入模型:BGE-M3,2026 中文场景主流开源嵌入模型,支持稠密向量 + 稀疏关键词多路检索,兼顾中文语义理解;
向量数据库:Qdrant,轻量开源向量库,单机部署简单,支持元数据过滤、混合检索,适合中小规模知识库;
编排框架:LangChain,串联文档加载、切片、向量化、检索、大模型调用链路;
重排序模型:BGE-Reranker,对初次召回的文档片段二次打分筛选,提升检索准确率;
推理大模型:本地部署开源大模型,保障私有文档不离开内网环境。
二、文档预处理、切片与向量入库(30 分钟~120 分钟,核心环节)
行业对比:早期基础 RAG 只做单路向量检索,在企业文档场景召回失败率偏高;2026 年主流生产方案都采用混合检索 + Rerank 重排序组合,可将检索准确率提升 25% 以上。
三、检索链路配置、提示词编写与幻觉约束(120 分钟~150 分钟)
查询改写:当用户提问模糊、存在指代,AI 自动对用户问题做扩展改写,补全业务术语,提升检索召回质量。例如用户提问 “报销上限是多少”,自动改写为 “公司差旅报销制度,差旅费用报销上限标准”。
多路召回:向量检索和 BM25 关键词检索,各自召回 Top20 候选片段,合并去重。
Rerank 重排序:把合并后的候选片段送入 BGE-Reranker 模型,重新计算相关性打分,筛选 Top5 最相关片段送入大模型,剔除相关性低的干扰内容,节约上下文窗口资源。
提示词工程(幻觉控制核心):编写系统提示词,强制约束大模型行为。 提示词核心规则:仅使用提供的检索片段回答;如果检索内容不足以回答问题,直接回复 “知识库暂无相关信息,无法作答”,禁止编造内容;输出答案末尾标注引用文档名称与页码,方便溯源核对;禁止脱离上下文扩展额外信息。
四、功能测试、调优与最小版本上线(150 分钟~180 分钟)
1. 构建测试集
问题包含专业术语,检索不到内容:优化 BM25 关键词权重,增加业务同义词词典;
片段信息足够,但是 AI 回答编造内容:强化提示词约束,提高重排序筛选门槛;
长文档答案碎片化:调整切片大小,增大上下文窗口。
2. 简易前端接入
3. 上线最小版本
五、3 小时快速搭建方案的边界与工程化进阶方向
适用场景:部门级小知识库,产品手册、内部流程、FAQ 问答;
局限:缺少自动化文档同步、复杂多租户权限、完整审计日志;新增大量文档需要手动触发入库;
进阶迭代方向(后续迭代):
文档自动同步:对接企业网盘、飞书 / 语雀知识库,文档更新自动增量更新向量库,不需要全量重新入库;
评估体系:自动化 RAG 评测,持续监控问答准确率变化;
多模态支持:解析图片内文字、截图,OCR 识别图片文档内容;
审计日志:记录每一次提问、检索片段、回答内容,满足企业合规审计需求。
六、RAG 落地高频踩坑总结(2026 工程实战经验)
误区:切片越小越好。切片过小会丢失上下文逻辑,切片过大,冗余信息过多,稀释有效信息,推荐 600-800token 是中文企业文档最优区间。
误区:只依赖向量检索。纯向量检索对编号、专有名词、合同编号召回效果差,混合检索是企业场景必选项。
误区:忽略元数据。不绑定文档版本、生效时间,知识库新旧文档混杂,AI 引用已经作废的旧制度。
误区:上线后不再维护。RAG 不是一次性项目,业务文档持续更新,知识库需要定期增量更新,否则答案会逐步过时。
误区:完全信任 AI 输出。即使 RAG 优化到位,依然存在幻觉风险,企业重要决策,必须人工核对原始文档来源。
七、总结
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。
评论列表