
2026 年,大模型产业正式告别 “参数越大越强” 的竞赛时代。过去几年,各大厂商以参数规模作为核心宣传指标,不断投入海量算力与数据训练超大基础模型。但 2026 年多项基准测试数据显示,当模型参数突破千亿级别之后,继续扩大参数带来的能力提升快速衰减,算力、电力、存储成本却呈指数级上涨,单纯堆参数的路线已经不具备商业可持续性。行业共识已经形成:大模型的竞争主线,从预训练参数规模比拼,转向模型效率优化与安全可控两大新赛道。
参数竞赛的落幕,来自三重硬约束。第一是缩放法则边际收益递减,同等算力投入下,增大参数带来的推理、代码、数学能力提升持续收窄,很多超大模型在真实业务场景的表现,和经过蒸馏优化的中小模型差距有限。第二是算力成本约束,2026 年全球 AI 算力缺口高企,训练与推理的电力、芯片成本持续承压,企业无法长期承担超大模型高昂的调用开销。第三是数据供给瓶颈,高质量文本、多模态训练数据逐步枯竭,单纯增加低质量数据只会造成模型能力退化,无法持续提升模型性能。在这样的背景下,头部厂商调整研发策略,不再一味推高基础模型参数,转向稀疏 MoE 架构、动态路由、量化蒸馏、推理时计算等技术,提升模型的能力密度。
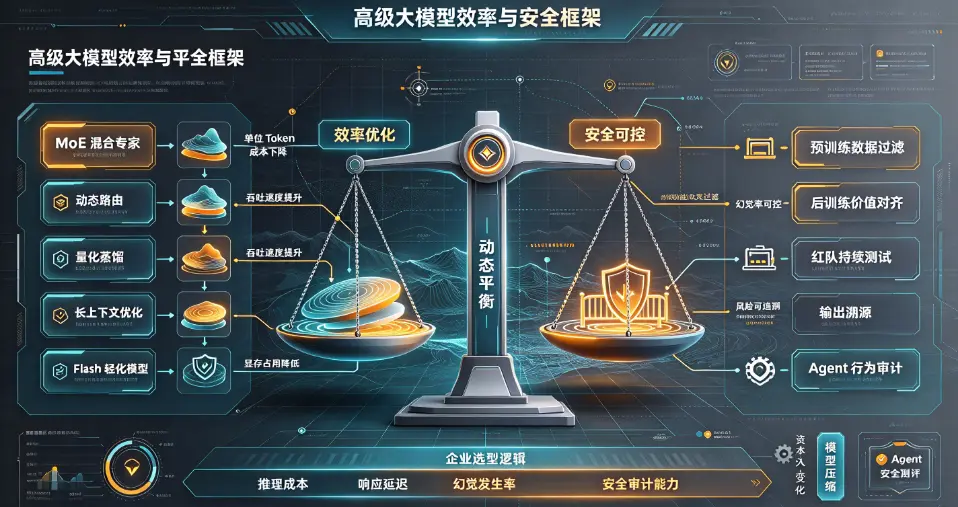
效率优化成为 2026 年技术创新的核心方向。MoE 混合专家模型成为主流架构,模型仅激活部分专家网络处理单次请求,在保有总参数量的同时,大幅降低单次推理算力消耗。搭配模型量化、长上下文窗口优化、缓存机制,主流模型单位 Token 推理成本相比 2025 年下降 40% 以上。同时行业开始区分基础大模型与轻量化 Flash 模型,Flash 模型参数规模更小,但针对代码撰写、文档摘要、知识库问答等高频场景专项优化,在企业 RAG、AI 智能体任务中,综合表现甚至优于超大基础模型。效率评估指标也随之迭代,不再只看榜单分数,新增单位算力能力、Token 吞吐速度、显存占用、端侧部署适配性等工程化指标,衡量模型真实落地价值。
 9d4d9368adad159a6590c60da6bab02.webp
在效率之外,安全可控上升为大模型落地的准入门槛。随着 AI 智能体大规模接入企业系统,模型幻觉、提示词注入、越狱诱导、权限越界等风险的破坏力显著放大。2026 年多轮安全测评显示,即便是头部旗舰模型,面对复合式提示注入攻击时,安全防护仍容易失效。行业对 AI 安全的理解,也从简单的拒答有害提问,升级为全生命周期对齐体系:包含预训练数据过滤、后训练价值对齐、红队持续对抗测试、输出溯源、行为审计等多层机制。企业采购大模型时,安全评估权重显著提升,能否限制模型越权调用工具、能否追溯模型输出来源、幻觉率是否可控,已经成为选型硬性指标。
效率与安全二者并非孤立,而是相互约束、协同优化。一味压缩模型体积提升推理效率,往往会削弱模型推理能力,降低安全对齐效果;过度叠加安全防护规则,又会增加推理开销、拉高延迟。2026 年优秀的模型工程方案,是在两者之间寻找动态平衡:通过专家路由把高风险复杂任务分配至高安全专家模块,常规简单任务交给轻量化子模型,兼顾响应速度与风险管控。
产业端的变化也重塑资本投入方向。市场资金逐步减少对超大基础模型预训练项目的投入,更多流向模型压缩、安全测评、Agent 行为风控、私有化部署工具链。企业采购逻辑发生根本性改变,不再优先挑选参数最大的模型,而是结合业务场景,综合评估推理成本、响应延迟、幻觉发生率、安全审计能力。
站在产业拐点之上,大模型行业进入工程化落地深水区。参数竞赛的落幕,并不代表大模型技术停止迭代,而是行业从追求纸面指标,转向追求真实业务价值。未来,一款具备竞争力的大模型,需要兼顾高效推理、低成本调用、稳定可控的输出能力。效率决定模型能不能规模化普及,安全决定模型能不能进入企业核心业务系统,二者共同构成 2026 年之后大模型产业竞争的核心主线。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。
评论列表