
2026 年,AI 行业正在发生一次范式转移:过去两年大家讨论的多模态大模型,核心能力是看懂图片、听懂语音、生成音视频,本质仍是被动响应指令的生成器;而多模态智能体(Multimodal Agent)的核心,是将多模态感知与自主任务执行能力融合,形成持续感知、动态规划、工具调用、结果校验的闭环系统。这一变化,直接重塑人机协作的底层逻辑:人类不再是持续输入提示词的操作员,而是目标定义者、校验者与决策者,AI 成为可协同完成复杂长时序任务的协作主体。
 36f9698a5ad850ae0defad12835773e.webp
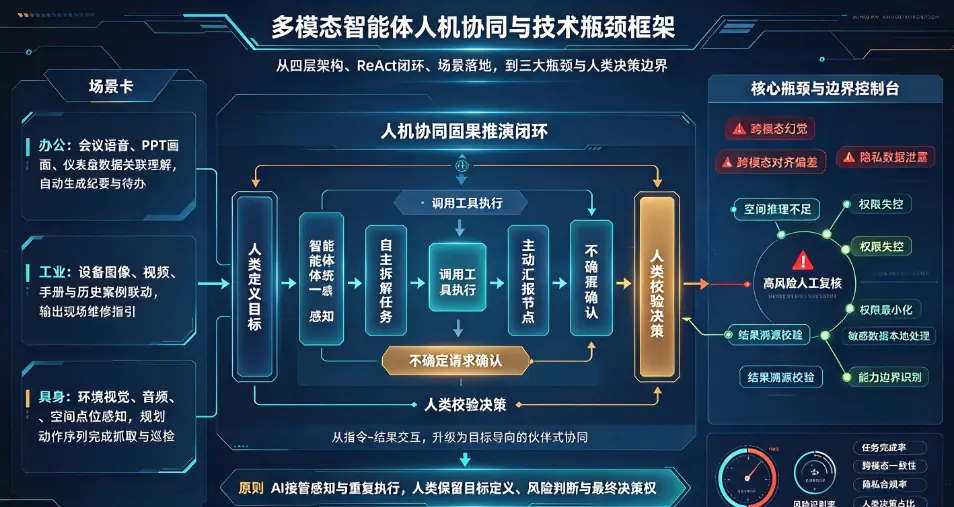
从技术定义来看,多模态智能体不是简单 “大模型 + 视觉模型 + 语音模型” 的拼接组合。早期方案大多采用分模态独立模型,再把图片、语音转文字送入 LLM 处理,模态之间存在语义断层,视频时序理解、空间推理能力薄弱。而 2026 年主流原生多模态智能体架构,采用统一特征空间,将文本、图像、音频、视频、传感器数据视为同等优先级输入,不再以文本作为唯一主干。整套系统分为四层:多模态感知层、长时记忆层、任务规划推理层、工具与行动执行层,搭配反思校验模块,形成 ReAct “思考 - 行动 - 观察 - 修正” 循环,这也是智能体区别于普通多模态模型的标志性特征。
2026 年上半年产业实测数据显示,原生多模态智能体在跨模态复杂任务上,相比传统文本大模型,综合任务完成率提升 58%;在包含截图、图纸、语音会议、PDF 文档混合输入的企业办公场景,任务一次性交付成功率提升 42%。端侧轻量化模型的突破进一步降低落地门槛,7B 参数端侧多模态基座,已经可以在本地完成屏幕捕捉、语音监听、图像识别与轻量任务规划,无需全部依赖云端高成本推理,端云协同模式成为企业落地首选方案。
人机协作模式的重构,体现在分工逻辑的根本性转变。传统人机交互是 “指令 - 结果” 的单次交互:人拆解任务,分步下达指令,AI 输出结果,人再修正。而多模态智能体驱动的协作模式,是目标导向的伙伴式协同。人类只需要提出最终目标,智能体自主拆解子任务,自动读取屏幕文档、转录会议录音、解析图纸截图,调用 API、数据库、绘图工具完成多步骤工作,中途主动向人类汇报关键节点、识别风险,遇到不确定信息主动请求人工确认。
在企业办公场景,多模态智能体可以全程跟进项目会议:实时转录语音、识别 PPT 画面、抓取仪表盘数据,自动生成会议纪要、风险清单、待办任务,同步更新项目看板。传统 AI 只能单独做语音转写或者文档总结,而多模态智能体能够把会议画面、发言内容、图表数据关联理解,识别 PPT 里隐藏的矛盾数据,标记业务风险。多家咨询机构 2026 年企业落地统计表明,引入多模态智能体团队,常规资料整理、报表生成、会议复盘类工作耗时平均下降 45%,人力从重复信息处理,转向策略判断、方案评审等高价值环节。
工业与现场运维场景,是多模态智能体落地另一大高价值赛道。一线工程师拍摄设备故障照片、录制现场视频,智能体同步识别图像里的设备部件,检索技术手册,结合历史维修案例,输出分步维修指引,并且实时语音交互指导操作。该模式将设备故障诊断周期缩短,一线工程师首诊解决率提升 30%。这类场景的核心价值,是打通物理世界感知与数字知识库,把静态文档变成可现场交互的行动指引,实现物理空间和数字知识库的联动。
更进一步,当多模态智能体叠加世界模型、具身智能,人机协作进入物理空间交互阶段。2026 年具身多模态模型能够同步感知环境视觉、音频、空间点位,自主规划动作序列,理解物体之间的空间关系,完成抓取、搬运、环境巡检等任务。人机不再局限于屏幕对话,而是可以在物理空间共同完成操作任务,人类负责安全边界设定与目标调整,智能体负责环境感知与精细执行。但行业也明确发现,物理场景的时序推理、三维空间理解,仍然是当前多模态智能体最大短板,在陌生、动态变化环境,模型容易出现空间误判、物理常识错误。
当然,技术红利背后,多模态智能体仍存在不可忽视的技术瓶颈,也是重构人机协作时必须守住的边界。第一是跨模态幻觉问题。多模态融合后,幻觉不再只是文字编造,会出现图像误识别、视频时序理解错误,多种模态错误叠加,误导决策。第二是跨模态对齐难题,不同模态特征融合存在偏差,复杂场景下,图像、音频信息互相冲突,模型推理稳定性下降。第三是隐私风险,多模态智能体需要持续读取屏幕、摄像头、音频,大量采集图像、语音等敏感数据,一旦权限管控不当,极易造成隐私泄露。
因此,2026 年成熟落地方案普遍采用人机混合校验机制:高风险操作必须人工复核,智能体只负责信息收集、方案生成、备选方案推演,最终决策权保留在人类手中。这也是人机协作的核心原则:不是 AI 替代人类,而是 AI 接管感知、检索、重复性执行工作,人类专注价值判断、风险把控、创意决策。
长期来看,多模态智能体带来的人机协作变革,会重塑岗位能力要求。未来人才的核心能力不再是文档排版、信息检索、基础数据分析,而是任务目标定义、智能体提示与边界管控、结果校验、风险识别。人类需要学会和智能体协同,理解模型能力边界,合理分配任务,而不是简单将全部工作交给 AI。
总结来看,多模态智能体的崛起,标志 AI 从信息生成工具,进化为具备感知、规划、执行能力的协同主体。它打通文本、图像、音频、视频等多源信息,构建感知行动闭环,彻底改变人机交互方式。但现阶段技术仍存在幻觉、空间推理不足、隐私安全等挑战,人机协同的最佳形态,是人类定义目标、把控风险,多模态智能体负责感知、检索、执行,形成互补共生的新型协作体系。未来随着世界模型、端侧多模态、长时记忆技术持续迭代,人机协作的边界还会继续拓展,数字智能体将深度融入办公、工业、生活等各类场景。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。
评论列表