引言
随着 AI 大模型推理需求持续爆发,传统中心化云算力存在采购周期长、成本高昂的短板,去中心化物理基础设施网络(DePIN)算力赛道迎来快速增长。2026 年行业数据显示,全球去中心化算力协议年化总营收突破 2 亿美元,需求主要集中在开源大模型推理、AI 图像渲染、轻量模型微调,不再是早年单纯的加密货币挖矿逻辑,而是把全球个人、工作室闲置 GPU 资源汇聚成分布式算力池,需求方通过链上合约租用算力,节点提供者贡献 GPU 资源获得对应奖励。
很多玩家存在认知误区:只要有显卡开机挂机就能稳定赚钱。但 2026 年大量节点运营数据表明,超过半数个人节点无法实现正向收益,核心原因是忽略显存门槛、电费成本、硬件折旧、算力利用率波动、代币价格波动等隐性变量。去中心化算力网络的盈利本质不是无脑挂机,而是算力资源的精细化调度套利,通过硬件选型、时段调度、多网络组合、负载控制,把闲置 GPU 转化为可持续的被动现金流。本文完整拆解从硬件评估、节点部署、收益测算、套利策略、运维方案到风险规避的全流程,帮助从业者理性评估闲置 GPU 接入链上算力市场的可行性。
 269aaec58a387f1503db8ef7acf95e5.webp
一、去中心化算力网络底层逻辑:和传统挖矿的本质区别
传统加密挖矿依靠哈希竞赛争夺区块奖励,消耗算力做无实际业务价值的哈希运算;而去中心化算力网络,是需求方提交 AI 推理、图像渲染等真实计算任务,链上智能合约完成任务分发、算力验证、自动结算。节点 GPU 完成指定计算任务,通过零知识证明、可信执行环境校验算力成果,任务完成后自动发放奖励。
收益分为两层:任务算力报酬 + 网络基础节点奖励。当市场算力需求不足,没有任务分配时,部分协议仍会发放少量基础节点奖励,但收益会大幅缩水。2026 年市场需求呈现明显的时段波动,夜间海外 AI 业务高峰期算力订单充足,白天订单减少,这也是节点套利的核心机会。
协议对硬件有硬性门槛,显存容量是第一优先级,其次是算力核心、功耗。8GB 以下显存的消费级显卡,几乎无法承接主流大模型推理任务,多数情况下收益难以覆盖电费,不建议接入分布式算力网络;24GB 显存及以上高端显卡,才具备稳定盈利的基础条件。
二、硬件筛选与成本收益测算(2026 真实节点数据)
硬件适配评估
RTX 4090(24GB 显存):个人节点主流选择,2026 实测月收益区间 80–220 美元,取决于算力利用率,电价是盈亏分水岭;
RTX 5090(32GB 显存):承接更大参数模型推理,月收益 130–360 美元;
A6000(48GB 专业卡):面向企业级推理任务,订单单价更高,月收益 200–580 美元;
中端显卡(RTX4060/4070,8G/12G 显存):任务匹配概率低,多数场景收益低于电费,不推荐做节点。
盈亏平衡点测算:以 RTX4090 为例,整机运行功耗约 450W,若居民电价高于 0.6 元 / 度,24 小时满负载运行,电费成本会快速吞噬算力收益,节点很容易出现亏损。
硬件折旧是极易被忽略的隐性成本。GPU 长期持续高负载运行,会加速显存、供电老化,缩短硬件使用寿命。行业通用估算:7×24 小时持续做算力节点,显卡有效使用寿命会缩短 30%~50%,硬件折旧成本必须计入整体成本核算,不能只看账面奖励收入。
三、节点部署全流程:从环境配置到链上注册
1. 前期环境准备
操作系统优先选择 Ubuntu,Docker 容器部署,隔离任务运行环境,防止恶意任务读取本地文件,降低安全风险。硬件层面做好散热改造,长时间高负载下 GPU 高温会触发降频,算力下降直接导致任务失败、扣罚节点奖励,甚至烧毁硬件。
2. 协议客户端安装与节点注册
当前主流去中心化算力协议包含 Render、
io.net、Akash 等,不同协议的任务类型、奖励模型、质押规则差异明显。部分网络要求少量代币质押,作为节点履约保证金,若节点中途掉线、任务计算出错,会扣除保证金,这是节点运营的重要风险点。
注册节点后,客户端会自动上报硬件参数、显存、带宽,协议调度器根据硬件规格匹配对应的计算任务。带宽不需要极高,100M 以上稳定上行带宽基本满足 AI 推理任务;网络中断、IP 频繁切换,会判定节点离线,中断任务并扣除奖励。
3. 节点上线与影子测试
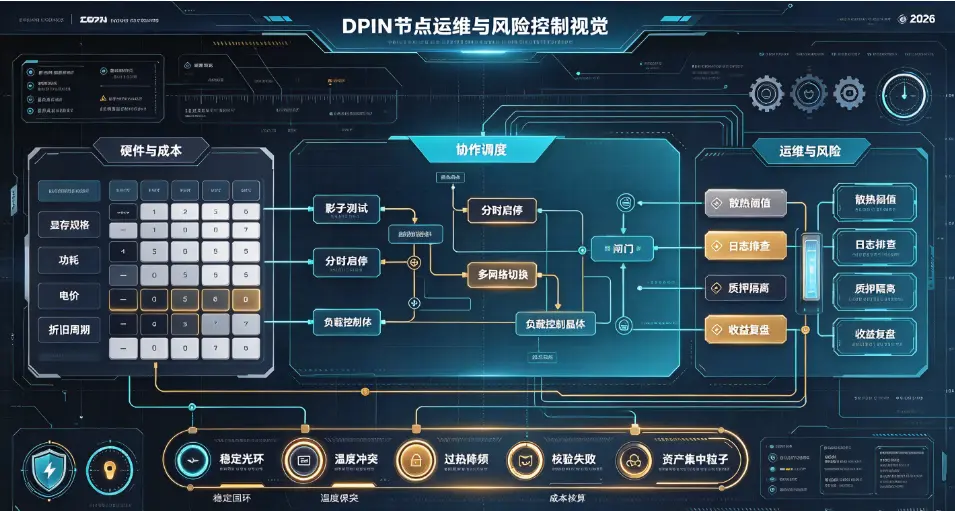
上线初期不直接接收付费任务,进入影子测试阶段,系统下发测试计算任务,验证 GPU、内存、网络稳定性,排查驱动、CUDA 版本不兼容问题。很多新手直接上线承接任务,因为驱动版本不匹配造成任务校验失败,被扣除质押金。
四、2026 三种可落地算力套利策略
策略 1:基础被动挂机策略(新手首选)
适合仅有单张闲置高端显卡,没有大量时间运维的用户。设置节点仅在 GPU 闲置时段运行,电脑日常使用时自动暂停算力任务,避免影响本机使用。核心思路:不追求 100% 算力利用率,控制负载,降低硬件损耗,获取长期稳定基础奖励与零散任务收益。
优点:运维简单,对硬件损耗相对可控;缺点:算力利用率低,整体收益偏低。
策略 2:分时窗口套利(2026 最主流套利方式)
全球 AI 算力需求存在时区错配,欧美工作时段(国内夜间),推理任务订单爆发,算力单价更高;国内白天时段订单稀少,算力报价走低。分时套利策略:夜间高需求时段开启节点承接任务,白天自动下线,避免低单价时段空耗电费。
可借助脚本实现自动化启停,在高算力报价窗口自动上线,低价时段停止任务,显著提升净收益,同时减少白天无效耗电。
策略 3:多网络算力池动态切换套利
同一台 GPU 硬件,接入多个算力协议客户端,通过调度脚本,实时对比不同协议当前任务单价、订单队列,自动将算力切换到报价更高的网络。这套策略适合多卡工作室,难点在于运维复杂度提升,需要持续监控各网络任务池状态,同时管理多网络质押资产。
风险提示:多协议同时运行会造成硬件资源争抢,极易引发任务报错、节点被罚,不建议新手直接尝试。
五、节点运维要点,保障长期稳定收益
驱动与环境固定:CUDA 版本、容器环境不要频繁升级,版本变更极易引发任务校验失败;
散热常态化监控:设置 GPU 温度阈值,超过 85℃自动暂停任务,防止过热降频与硬件损坏;
定期日志排查:查看任务报错记录,高频失败会降低节点信用分,调度器会减少任务分配;
质押资产管理:区分保证金与算力收益,不要把全部资产质押在单一协议,降低单点风险;
定期收益复盘:按月统计电费、奖励、硬件损耗,当净收益持续为负,及时下线节点。
六、核心风险清单(行业高频踩坑点)
代币价格波动风险:大部分链上算力奖励以代币发放,代币价格下跌会直接造成实际收益大幅缩水,哪怕算力任务数量不变,法币收益也可能腰斩;
硬件损坏风险:长期高负载运行,显存、供电故障概率上升,一旦显卡损坏,硬件损失远高于短期算力收益;
质押罚没风险:网络掉线、计算结果校验失败,协议会扣除质押保证金;
算力需求下行风险:随着全球 GPU 供给增加,算力市场单价长期下行,未来单位算力收益持续压缩;
安全风险:部分恶意计算任务存在数据窃取、恶意代码风险,必须使用容器隔离环境运行任务,本地不要存放隐私、敏感文件;
合规风险:参与链上代币结算的算力节点,涉及虚拟货币相关业务,不受国内法律保护,资金、资产安全无法保障。
七、总结
2026 年去中心化算力网络,把闲置 GPU 资源转化为 AI 推理算力,为硬件持有者开辟了一条新的资产复用路径,但它并非 “躺赚” 的被动收入工具。整套套利逻辑的核心不是简单开机挂机,而是硬件门槛筛选、电费折旧精细化核算、分时调度、多网络动态选择,同时持续管控硬件、代币、质押罚没等多重风险。
对于普通个人用户,只有显存 24GB 以上、电价低廉、散热条件良好的闲置 GPU,才具备参与价值;中端显卡在绝大多数场景下,收益无法覆盖电费与硬件折旧,不建议接入。分时套利是性价比最高的策略,利用时区带来的算力需求差,在订单溢价窗口释放算力,平衡收益与硬件损耗。
从长期趋势看,随着全球 GPU 供给增加,算力租赁单价存在下行压力,收益会持续被压缩。所有参与者必须理性看待收益预期,提前做好成本测算,控制硬件负载,预留风险缓冲。最重要的是认清业务本质,链上代币结算模式存在监管与资金风险,任何参与前,都需要充分评估自身风险承受能力,不盲目投入资金采购新显卡专门用于节点挖矿。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。

评论列表