
2026 年,多模态大模型不再只用于图片生成、图文问答,开始深入到家庭里琐碎、高频的微观生活决策。过去,膳食规划是典型的 “家庭隐性劳动”:打开冰箱清点食材、思考三餐搭配、避免食材过期浪费、兼顾家人忌口与营养需求,大量上班族每天要花费十几分钟纠结吃什么。而当前主流多模态 AI 可以直接接收一张冰箱实拍照片,自动识别冰箱内全部食材,优先选用临期食材,结合家庭成员饮食偏好,一次性生成连续多日三餐方案、烹饪步骤、采购清单。本次为期 30 天的家庭实测,完整记录这套流程的真实效果、技术边界与缺陷,以此观察多模态 AI 如何渗透普通人的生活细节。
 07279c4f0d1660c053498a031391bba.webp
本次实测选择市面上 4 款主流多模态大模型,统一测试条件:使用普通手机拍摄冰箱内部实拍照片,自然光环境,不额外补光,不整理冰箱。测试任务包含:识别图片内全部食材、预估食材剩余保质期、结合 2 人家庭(一人控糖、一人减脂)的饮食约束,生成 3 天三餐食谱,标注每道菜热量,输出缺失食材的采购清单。实测累计采集 120 张冰箱照片,覆盖新鲜果蔬、冷冻肉类、蛋奶、半成品袋装食材、调味品等常见品类,形成量化观测数据。
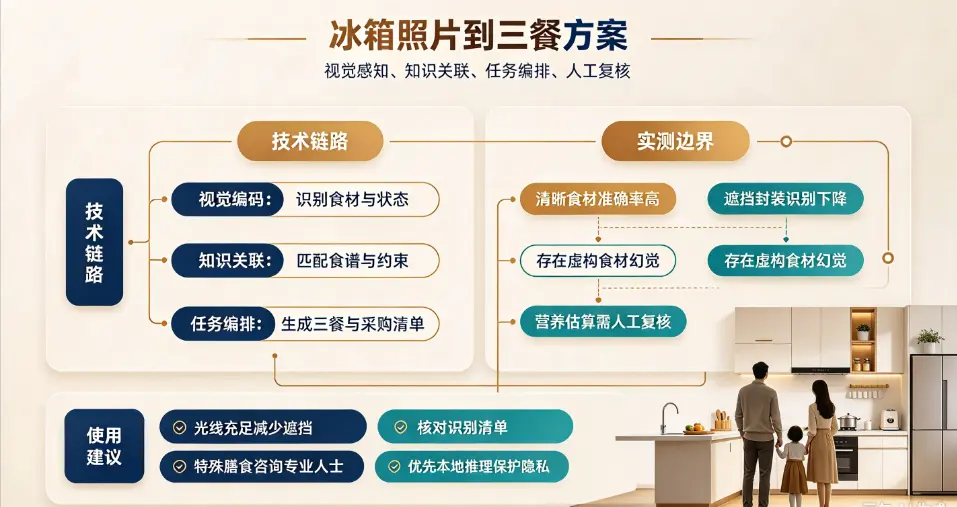
实测统计结果显示:在光线充足、食材无遮挡、食材完整裸露的条件下,多模态模型对西红柿、鸡蛋、青椒、完整肉类等常见食材识别准确率可达 94%;但遇到塑料袋封装、多层堆叠遮挡、切半半成品、包装磨损的食材,识别准确率下降至 67%。多模态视觉幻觉问题在实测中高频出现,模型会凭空识别出照片中不存在的食材,或是混淆外观相似食材,将嫩豆腐识别为鸡蛋羹、把牛肉误判为猪肉,这类幻觉在暗光、杂乱堆放的冰箱照片中发生率明显提升,这也是多模态视觉大模型的固有短板。
一、完整技术链路:一张照片如何变成三餐方案
很多用户只看到 “上传图片,直接拿到食谱” 的表层效果,背后是多模态模型多阶段推理链路,分为视觉编码、实体理解、任务规划三层。
第一层,视觉感知。多模态模型的图像编码器解析图片像素,识别图片内物体的类别、位置、形态,提取食材视觉特征。不同于传统单一目标检测算法,新一代多模态模型不仅识别 “这是什么东西”,还能判断食材状态:菜叶是否枯萎、肉类是否冷冻、食材堆放的拥挤程度。但视觉识别仅仅是第一步,图片本身存在信息缺失,照片无法直接读取食材生产日期、储存时长,模型只能依靠外观经验估算保质期,天然存在误差。
第二层,知识关联。模型将识别出的食材实体,对接内置食谱知识库、营养学数据库,匹配食材之间的烹饪组合,同时读取用户预设约束条件,例如控糖、低脂、过敏忌口、不吃香菜等。这个阶段模型会做资源优化:优先安排临期食材,减少食材腐烂浪费,同时平衡蛋白质、碳水、膳食纤维的配比,这也是 AI 膳食规划的核心价值。
第三层,任务编排与文本生成。模型基于现有食材,规划连续多天的三餐组合,规避重复菜品,输出菜品做法、预估烹饪时长,同时对比现有食材和菜谱所需材料,生成补充采购清单。
整套流程把原本 “肉眼清点食材 + 查阅菜谱 + 营养估算” 多步人工操作合并,把十几分钟的家务决策压缩到几十秒,这正是多模态 AI 渗透生活细节的核心逻辑:把物理世界的视觉信息,转化为可执行的生活任务。过去的 AI 工具,需要用户手动输入文字描述冰箱里有什么食材;而多模态 AI 直接通过视觉感知现实环境,降低人机交互门槛,让 AI 从 “文字问答助手” 转向感知现实世界的家庭智能体。
二、实测发现:优势与无法忽略的现实短板
本次 30 天实测,验证了多模态 AI 在家庭膳食规划场景的实用价值,但同时暴露大量落地短板,并非宣传中的 “一键完美解决三餐”。
正向价值:降低家庭隐性家务成本
2026 年消费 AI 调研数据显示,城市家庭平均每周花费约 2.7 小时用于思考三餐、清点食材、处理过期食材,食材浪费也是家庭开支里一笔隐性消耗。实测中,多模态 AI 可以快速生成多样化菜谱,优先消耗快变质的蔬菜,在测试周期内,家庭果蔬浪费量下降约 28%。对于上班族、双职工家庭,AI 可以快速提供多种备选方案,减少 “不知道吃什么” 带来的决策内耗。同时模型可以持续记忆家庭成员饮食约束,自动避开过敏食材,为减脂、控糖人群提供热量估算,简化营养管理的工作量。
核心短板:视觉幻觉、信息盲区与营养估算偏差
第一,视觉幻觉与识别错误。多模态模型不是 “看懂图片”,而是基于视觉特征结合训练数据做概率推断。当食材被塑料袋遮挡、堆叠在一起,很容易出现漏识别、误识别,甚至虚构不存在食材。实测中,在冰箱杂乱堆放的照片中,食材幻觉发生率接近 22%,模型会凭空识别出不存在的肉类或者蔬菜,进而生成包含该食材的菜谱,直接导致方案不可执行。
第二,图片信息存在天然局限。照片无法读取食材保质期、包装上的配料表、盐糖含量。AI 只能依靠外观粗略估算新鲜程度,无法判断食材是否变质。这意味着 AI 给出的食谱方案,必须由人工复核食材真实状态,不能直接采信。
第三,营养估算存在偏差。AI 的热量、营养计算基于食材理论参考值,没有考虑食材分量、烹饪用油、调料带来的热量变化,仅适合粗略参考,不能作为精准控糖、减重、病人膳食的唯一依据。
第四,隐私风险。上传冰箱实拍照片,图片内会暴露家庭生活环境、采购习惯、家庭成员饮食偏好,将私人生活图像上传到线上大模型,存在图片被存储、泄露的隐私隐患。如果涉及特殊饮食、慢性病膳食管理,不建议直接使用公有云多模态模型上传照片。
三、从冰箱食谱案例看多模态 AI 的演进方向
冰箱拍照生成三餐方案,只是多模态 AI 进入家庭的一个缩影。2026 年多模态技术正在从单点独立任务,走向连续感知、长期记忆的家庭智能体。未来的 AI 不再是用户主动上传图片才会响应,而是可以持续感知家庭环境,自动追踪食材消耗、临期预警,联动购物清单,形成完整闭环。
当前行业发展分为两条路线。第一条路线是通用多模态大模型,依托手机端应用,无需更换硬件,手机拍照即可完成任务,门槛低,灵活性强,也是普通用户最容易接触的方案;第二条路线是硬件端内置多模态模型,例如搭载摄像头与本地多模态小模型的智能冰箱,本地完成图像识别,图片不上传云端,保护隐私,自动持续记录食材库存,但是硬件采购成本高,普及速度更慢。
两种路线各有取舍。手机端通用模型使用成本低,但图片上传云端存在隐私风险;本地端侧模型数据不出设备,隐私安全性更高,但硬件成本高,模型能力上限弱于云端大模型。行业共识是端云协同会成为主流方案,简单食材识别任务在本地端侧完成,复杂膳食规划、多日食谱生成交由云端大模型处理。
但必须认清,多模态 AI 的核心定位是辅助工具,不是家庭膳食管家。AI 擅长组合食材、生成备选方案、做基础营养估算,但无法替代人类的感官判断,无法分辨食材是否变质,也无法完全理解家庭成员的口味偏好。AI 输出的方案,依然需要人工审核、调整。
四、普通用户使用多模态家庭 AI 的实操建议
结合本次实测,总结四条实操原则,降低幻觉、隐私、膳食安全风险。
第一,拍摄照片尽量保证光线充足,减少食材堆叠遮挡,提升识别准确率;拍照后人工核对 AI 识别的食材清单,重点剔除模型虚构出来的食材,避免食谱无效。
第二,涉及慢性病、特殊疾病、孕妇、婴幼儿膳食,AI 生成方案仅作参考,务必咨询营养师或者医生,不可直接执行。
第三,重视隐私保护。含有大量家庭生活细节的照片,尽量优先选用支持本地端侧推理的工具,减少上传原图至公有云平台。
第四,建立人机协作思维,AI 用来生成初稿、提供备选思路,最终食材状态、口味、食品安全,由人来最终判断。
结语
拍一张冰箱照片自动生成三餐方案,这个看似简单的功能,代表多模态 AI 正在从宏大的技术概念下沉,渗透到一日三餐这类细碎的家庭生活细节。2026 年多模态视觉大模型已经具备感知现实世界、完成生活任务规划的能力,能够分担家庭里大量重复性的决策劳动。
但实测也清晰证明,多模态 AI 仍存在视觉幻觉、识别不稳定、信息不完整等底层缺陷,它不能完全替代人的判断。AI 可以快速生成食谱初稿、规划膳食方案、减少食材浪费,但食品安全、食材变质判断、个性化健康膳食,依然需要人来把关。
这也是未来家庭 AI 的长期方向:AI 负责繁琐的感知、检索、规划等事务性工作,人类保留最终决策权。多模态 AI 的价值不是取代人的生活,而是承担那些消耗精力的隐性家务,把人从大量重复的日常决策中释放出来。随着视觉对齐、幻觉抑制、端侧轻量化模型持续迭代,AI 对现实生活细节的感知能力还会持续提升,但人机协同的基本逻辑,在很长一段时间内不会改变。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。
评论列表