
2023 至 2025 年,全球 AI 产业的主线是大模型基座竞赛,各大厂商比拼参数量、上下文长度、多模态能力,行业资源集中投入大模型预训练。进入 2026 年,行业共识发生明显转变:单纯扩大模型参数带来的边际收益快速递减,大模型基座的军备竞赛逐步降温。产业的价值重心,开始从 “训练更大模型”,转向算力效率重构、高质量数据资产化、场景化智能体落地。
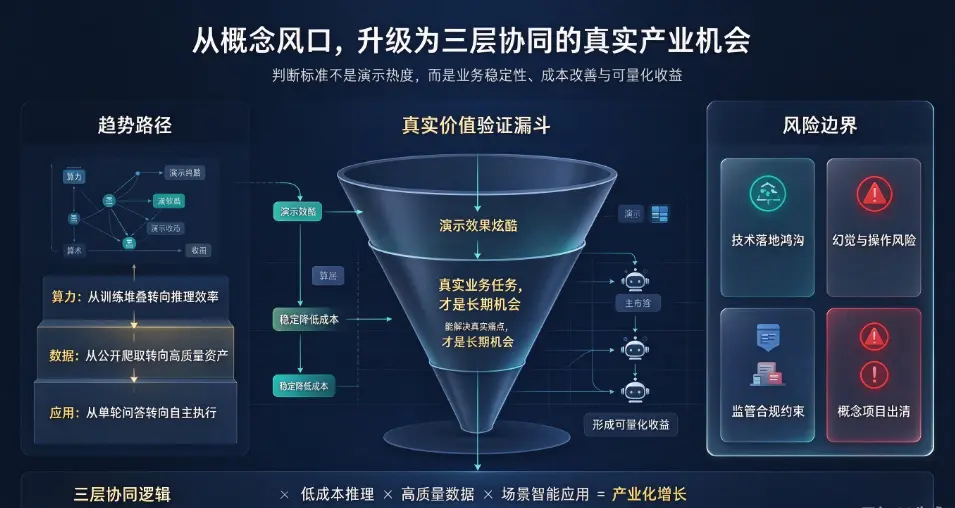
很多从业者会疑惑,大模型热度回落之后,AI 产业下一轮增长引擎究竟藏在何处。答案分布在算力底层、数据要素、上层应用三层结构之中。算力决定 AI 能不能低成本规模化运行;数据决定模型能不能在垂直场景稳定产出可信结果;应用层决定技术能否转化为真实商业价值。三层协同,共同开启后大模型时代的产业新周期。
 e09adbaeb39c6c5c9e9ce586eb288c1.webp
一、算力层:从训练算力军备竞赛,转向推理优化与异构算力网络
在前大模型时代,算力赛道的核心关键词是训练。企业不惜重金采购大量 GPU 集群,一次性投入海量资源完成基座模型预训练。但 2026 年产业数据显示,推理算力的需求增速已经全面超过训练算力,成为算力市场增长主力。《2026 年中国人工智能计算力发展评估报告》预测,2026 年国内智能算力规模将达到 2576.5 EFLOPS,同比增长 87.9%,其中绝大部分增量来自 Agent、多模态内容生成、行业智能应用带来的高频推理请求。
算力赛道的风口,不再是单纯堆叠更多高端 GPU,而是三大细分方向。第一,推理优化与算力调度。传统裸算力租赁模式正在转型,服务商从 “卖卡、卖算力” 升级为 “卖 Token、卖推理服务”,依托算力调度平台,动态调度异构芯片资源,降低单次推理成本。高速互联、光互联、液冷配套基础设施,成为算力集群降本的关键环节,也是资本重点布局方向。
第二,端边云协同算力。随着 AI 智能体、具身智能、机器人、车载 AI 快速落地,大量计算任务不再全部放在云端。端侧轻量化模型、存算一体芯片崛起,把高频、低延迟的本地任务放在终端设备,复杂任务上传云端,形成分层算力架构。2026 年端侧模型压缩技术成熟,手机、工业设备、机器人本地运行智能体成为现实,端边算力市场迎来爆发窗口。
第三,绿色算力与全国一体化算力网络。算力本质消耗大量电力,电力供给、能耗成本逐步成为算力集群扩张的硬性约束。依托东数西算工程,算力资源向西部能源富集区域集中,跨区域算力调度平台持续完善,算力从孤立的数据中心,变成可以跨地域调度的网络化资源。绿色低碳算力集群,将成为长期竞争力的核心要素。
算力赛道的核心逻辑已经改写:过去比拼的是峰值算力上限;2026 之后比拼的是单位 Token 成本、并发稳定性、能耗效率、跨硬件兼容能力。谁能把推理成本持续压低,谁就能支撑上层海量智能体规模化运行。
二、数据层:互联网通用数据枯竭,高质量垂直数据与合成数据成为核心资产
大模型训练依赖海量互联网公开文本,但公开高质量原始数据已经接近枯竭,单纯爬取网页数据,很难继续提升基座模型能力。2026 年,数据赛道的风口发生根本性切换:通用公开数据价值下降,垂直私有数据、高质量合成数据、数据治理与数据流通成为新的竞争高地。
第一个方向,行业私有数据资产。对于企业而言,内部业务文档、工单、病历、工业传感器数据、供应链日志,这些带有业务标签的私有数据,是通用互联网数据无法替代的。这类数据能够训练垂直领域模型,搭建行业知识库,支撑企业智能体稳定完成业务流程。数据不再是附带产物,而是企业核心数字资产。配套的数据清洗、结构化、数据脱敏、私有知识库 RAG 方案,需求持续爆发。
第二个方向,可控合成数据。为了解决高质量真实数据不足、版权、隐私等难题,合成数据在 2026 年大规模落地。通过 AI 生成符合行业规则的仿真数据,用于模型微调、测试、仿真训练。在工业、医疗、自动驾驶、机器人领域,合成数据可以弥补真实样本稀缺的痛点。行业数据显示,在不少垂直场景,高质量合成数据已经可以替代 30%~60% 的真实标注数据,大幅降低标注成本。但合成数据存在分布偏移风险,如何校验数据真实性、避免模型污染,是行业共同面对的挑战。
第三个方向,数据要素基础设施。数据确权、脱敏、安全多方计算、数据交易平台,解决数据流通的信任与合规难题。过去企业担心数据流出会泄露商业机密,新的数据基础设施可以实现 “数据可用不可见”,让多家机构在不直接交换原始数据的前提下联合训练模型。
数据层的底层逻辑转变:大模型时代追求 “数据越多越好”;后大模型时代追求数据质量、数据可信度、数据可复用性与合规安全。未来模型之间的差距,很多时候不再是模型架构,而是谁掌握高质量、可复用、合规的垂直数据集。
三、应用层:从对话问答走向自主执行,AI 智能体、世界模型、垂直产业落地是主战场
大模型最直观的产品形态是聊天对话框,用户输入指令,模型单次返回回答。但这种单轮对话模式,商业价值有限。2026 年之后应用层最大风口,是具备自主规划、工具调用、多步骤任务执行能力的 AI 智能体(Agent),从被动回答升级为主动完成复杂工作流。
单智能体可以独立完成调研、文档撰写、数据处理;多智能体系统则模拟团队协作,多个专业智能体分工配合,自动完成长周期复杂项目,例如市场调研、产品方案、代码开发、工业巡检、医疗辅助诊断。多智能体工作流框架,是 2026 应用层落地最快的赛道,大量企业开始把智能体嵌入业务系统,替代重复、低价值的人工流程。
其次是世界模型与具身智能。传统大语言模型只学习语言文本,对真实物理世界理解有限。世界模型以预测物理世界下一状态为目标,融合视觉、三维、力觉等多模态信息,能够理解空间、物理规则,支撑机器人、自动驾驶、工业仿真、数字孪生等场景。具身智能机器人依托世界模型,在真实物理环境完成操作任务,成为工业、服务场景的长期机会,不过距离大规模商业化还有较长周期,当前更多处于试点落地阶段。
第三,垂直行业深度落地。通用 AI 产品容易陷入同质化竞争,而垂直行业场景具备天然壁垒。工业质检、生物医药研发、金融风控、企业财税、医疗影像辅助诊断、法律文书处理,这些场景拥有固定业务流程、明确评价指标、行业专属数据,更容易形成可落地、可变现的 AI 产品。AI 不再作为独立工具,而是嵌入企业原有业务系统,和 ERP、MES、医疗信息系统深度融合,形成业务闭环。
同时,应用层也存在大量泡沫。很多打着 “智能体” 概念的产品,只是简单的提示词串联,不具备自主规划能力,无法处理复杂任务,很容易在行业出清阶段被淘汰。判断应用项目真伪的标准,不是演示效果是否炫酷,而是能否稳定完成真实业务任务、降低综合成本、形成可量化的收益。
四、三层协同:后大模型时代的产业机遇与风险边界
算力、数据、应用三层并不是孤立存在,而是互相约束、互相放大。算力成本决定智能体能不能大规模部署;数据质量决定智能体在垂直场景会不会频繁幻觉;应用场景的需求反过来驱动算力架构、数据治理技术迭代。
从机会分布来看,算力层机会偏向重资产、长周期,适合有硬件、IDC、网络资源的企业;数据层属于中间基础设施,轻量化创业机会更多,例如数据标注、知识库搭建、RAG 服务、合成数据平台;应用层创业门槛最低,竞争最激烈,核心壁垒在于行业理解、业务流程改造能力与行业数据积累。
同时必须理性看待风险。第一,技术落地鸿沟,很多 AI 技术在演示环境效果优秀,但进入真实业务场景,面对噪声、异常情况,稳定性大幅下降;第二,幻觉与安全风险,智能体拥有调用外部工具、执行操作的权限,一旦出现错误,可能带来业务损失;第三,监管合规约束,数据隐私、内容安全、行业准入规则,会持续影响 AI 产品落地节奏。
结语
大模型基座竞赛落幕,并不代表 AI 浪潮结束,而是 AI 产业从技术探索期,正式进入产业化落地的新阶段。下一轮产业风口,不再是单一的模型奇迹,而是算力效率、高质量数据、场景化智能应用三者协同的系统性变革。
算力层,比拼推理成本与异构调度能力;数据层,比拼垂直高质量数据资产与合规治理;应用层,比拼智能体工作流、行业深度整合能力。未来能够跑出的企业,未必是能做出最大基座模型的团队,而是懂得把 AI 嵌入真实业务,用好算力、沉淀高质量数据,持续解决真实痛点的参与者。AI 行业的竞争,从 “模型跑分竞赛”,转向 “真实价值兑现” 的长期竞争。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。

评论列表