2026 端侧大模型轻量化部署实战:消费级显卡 72 小时落地行业定制模型

2026 年,QLoRA 低秩微调、GGUF 混合量化、Unsloth 加速框架重构行业定制模型落地范式,无需昂贵 A100/H100 算力集群,单张 RTX4090 这类 24GB 消费级显卡,可在 72 小时完成行业私有数据集处理、模型微调、量化压缩、端侧推理部署全链路。本文基于 2026 年 Q3 工程实测流程,将项目拆分为数据治理、QLoRA 微调评估、模型量化与部署验证三大阶段,详细拆解各环节技术要点,对比不同量化方案的显存占用、推理延迟与输出精度,剖析数据质量、模型幻觉、商用许可、显存瓶颈四大工程痛点。

长期以来,行业定制大模型被默认为算力密集型项目。传统全参数微调方案,训练 7B 基座模型就需要数十 GB 显存,项目周期动辄数周,中小企业只能选择云端 API 调用,持续承担 Token 费用,同时面临业务敏感数据外泄风险。进入 2026 年,随着 QLoRA 低秩适配、4-bit 量化、Unsloth 训练框架持续迭代,单张 24GB 消费级显卡,就能够完成 7B~14B 开源基座模型的领域指令微调,整套端到端工程流程压缩至 72 小时,实现行业私有模型本地化部署。该方案不依赖云端算力,业务文档、问答样本全程不出内网,适合企业内部知识库、设备运维手册、财税工单解析、法务合同检索等确定性垂直场景,成为中小团队私有化 AI 落地的主流路径。
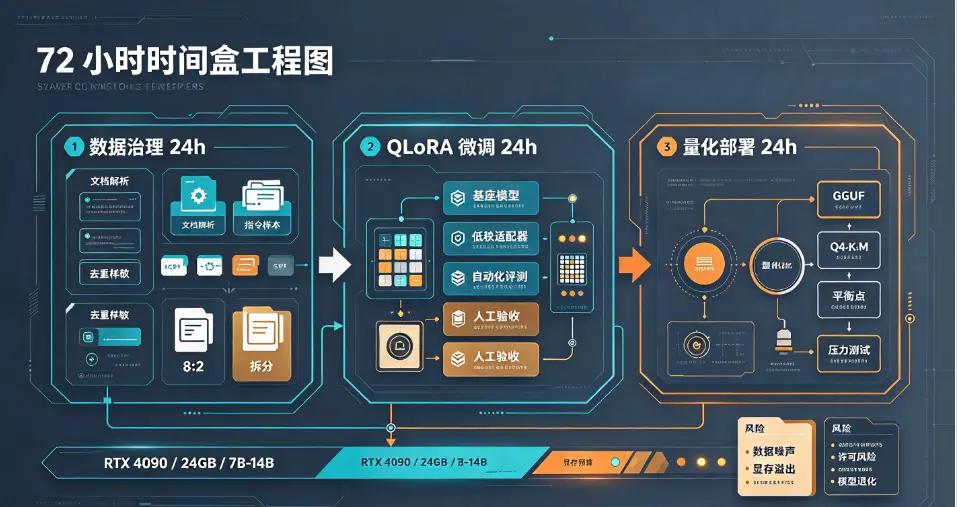
完整 72 小时项目实施流程,被划分为三大阶段:数据清洗与指令集构建(24h)、QLoRA 微调与自动化 + 人工评测(24h)、模型合并量化与端侧部署压力测试(24h)。三个阶段环环相扣,前序环节缺陷会直接传递到最终模型效果,因此每个阶段都设置验收标准,不允许直接进入下一环节。

第一阶段,24 小时数据治理与指令数据集构建,这是决定定制模型效果的核心环节。很多新手误以为微调的核心是训练代码,而工程实测显示,数据集质量对模型最终表现的权重超过 60%。原始业务素材一般包含 PDF 手册、Word 技术文档、历史客服问答、工单记录,第一步需要完成文档解析、去重、脱敏,剔除身份证、手机号等敏感信息,再将原始长文本转化为instruction-input-output指令微调样本。2026 年行业实践普遍采用 “小而精” 的数据集策略,不需要数万条样本,500~1500 条高质量领域样本,就足以让 7B 基座模型掌握行业术语、业务流程;样本数量过多反而会引入噪声,提升训练时长,甚至造成模型遗忘通用能力。
3b6635f655a2fa6989e9dd66344f81f.webp3b6635f655a2fa6989e9dd66344f81f.webp

数据集需要划分训练集、测试集,按照 8:2 比例拆分,预留测试集用于后续模型效果评估。样本构建需要兼顾正负案例,除了标准问答,还需要补充错误案例、边界场景,降低模型幻觉概率。以制造业设备运维场景为例,样本不仅包含设备故障排查方案,还需要增加 “不属于该故障的现象” 作为负样本。数据集完成之后,进行格式校验、重复度检测,完成第一阶段交付验收。
第二阶段,24 小时 QLoRA 微调与模型效果评估,是整套方案的技术核心。QLoRA 技术冻结基座模型全部权重,仅训练少量低秩适配器,训练参数量减少 99%,显存开销大幅降低,24GB 消费级显卡可稳定运行 7B 基座 4-bit 量化微调任务。2026 年主流使用 Unsloth 框架,依靠手工优化的 Triton 内核,相比原生 Hugging Face 训练脚本,训练速度提升 2\5 倍,峰值显存占用下降 30%\40%,大幅缩短训练耗时。
训练超参数采用垂直领域微调通用配置:LoRA 秩 r=8\16,学习率 2e-4,训练轮次 2\4 轮,轮次过高极易发生过拟合。训练完成后,不会直接合并 LoRA 权重,而是进入评测环节,分为自动化评测与人工评测。自动化评测使用预留测试集,评估行业术语召回率、答案事实错误率;人工评测重点检查模型幻觉、格式输出稳定性。如果领域问答错误率超标,需要回溯数据集,补充缺失业务样本,迭代二次微调,直到模型在测试集上满足预设指标,方可进入下一阶段。
第三阶段,24 小时模型合并、GGUF 量化与端侧部署验证。将训练产出的 LoRA 适配器与基座权重合并,导出模型权重,再转换为 GGUF 格式,选择合适量化等级。2026 年实测数据显示,Q4_K_M 是工程落地的黄金平衡点,在精度损失极小的前提下压缩模型体积;7B 模型 Q4_K_M 量化后文件约 4GB,在 RTX4090 上推理吞吐可达 87tok/s。对于显存资源紧张的硬件,可选用 IQ3_M 进一步压缩体积,但会带来复杂推理任务的精度衰减;Q5_K_M 适合对事实准确性要求高的法务、医疗场景,代价是显存占用小幅上升。
量化完成后,依托 llama.cpp 或者 Ollama 搭建本地推理服务,接入业务接口,开展多维度测试:首 token 响应延迟、Token 吞吐速度、长上下文稳定性,同时执行并发压力测试,模拟多人同时调用场景。在压力测试环节,重点观测显存溢出、输出乱码、工具调用 JSON 格式错误等问题。全部测试通过,模型即可交付内网部署,所有业务数据保留在本地工作站,不需要上传第三方云平台。
尽管 72 小时轻量化微调方案门槛显著下降,但工程落地过程中存在四大高频陷阱,也是很多项目失败的根源。第一是数据噪声问题,直接导入未经清洗的原始文档,数据集自带错误信息,微调之后模型会固化错误认知,幻觉问题比原始基座模型更加严重。第二是显存与模型规模的平衡,盲目选择 14B、27B 大基座模型,虽然复杂推理能力更强,但显存压力急剧上升,低配消费显卡会出现推理卡顿、OOM 显存溢出。第三是开源模型许可风险,商用项目微调基座,必须选用 MIT、Apache2.0 宽松协议权重,部分开源模型明确禁止商用,直接上线会带来版权纠纷。第四是模型退化风险,过度领域微调,造成模型基础通用能力丢失,无法处理领域外常规指令。
针对不同硬件条件,模型选型策略需要动态调整。24GB 显存 RTX4090,推荐 7B 基座为主力方案,也可以尝试 14B 模型的 QLoRA 微调;12GB 显存显卡,优先选择 4B~7B 轻量化基座,降低显存压力;8GB 显存显卡仅适合 4B 及以下小模型,只能处理简单标准化问答任务。业务场景层面,标准化文档问答、内部知识库检索,7B 模型完全胜任;多步骤复杂逻辑推理、合同深度解析场景,建议选用 14B 基座搭配 Q5_K_M 量化,牺牲部分推理速度换取更高事实准确性。
站在产业视角,消费级显卡本地微调方案,本质上打破了算力壁垒。过去中小企业想要搭建行业专属模型,只能采购昂贵智算资源,或者持续订阅云端 API,数据安全难以保障。而这套端侧轻量化方案,企业仅依靠现有工作站,就能完成模型训练、私有化部署,一次性硬件投入,后续无持续调用成本。但我们也要客观认识其边界,端侧微调模型擅长确定性垂直任务,复杂通用推理、多模态深度理解能力仍然弱于头部闭源大模型。
展望 2026 下半年到 2027 年,端侧微调工程会继续向自动化方向演进:数据自动清洗、样本自动生成、量化感知训练、持续样本回流迭代等工具链持续完善。未来行业定制模型开发,会进一步降低代码门槛,业务专家可以参与数据集构建,开发者聚焦模型评测与系统集成。算力基础设施的下沉,正在推动 AI 从公有云 API 服务,走向企业内网私有化、端侧本地化的新形态,而 QLoRA+GGUF 这套轻量化微调部署方案,正是这场产业变革的关键工程底座。

来源: 互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。

赞 ()

相关推荐

  • 2026 端侧大模型轻量化部署实战:消费级显卡 72 小时落地行业定制模型

    2026 年,QLoRA 低秩微调、GGUF 混合量化、Unsloth 加速框架重构行业定制模型落地范式,无需昂贵 A100/H100 算力集群,单张 RTX4090 这类 24GB 消费级显卡,可在 72 小时完成行业私有数据集处理、模型微调、量化压缩、端侧推理部署全链路。本文基于 2026 年 Q3 工程实测流程,将项目拆分为数据治理、QLoRA 微调评估、模型量化与部署验证三大阶段,详细拆解各环节技术要点,对比不同量化方案的显存占用、推理延迟与输出精度,剖析数据质量、模型幻觉、商用许可、显存瓶颈四大工程痛点。

    2026年09月21日 16点51分
  • 2026普通人AI轻创业全攻略:零门槛启动的8个低风险变现赛道拆解

    2026 年 AI 工具链全面成熟,轻资产单人创业(OPC 一人公司)成为普通人切入 AI 红利的主流方式,不再需要大额算力投入与团队搭建。本文结合 2026 上半年行业交易数据,拆解 8 个适合普通人、低启动资金、风险可控的 AI 变现赛道,对比各赛道启动成本、回款周期、收益区间、内卷程度与核心壁垒,摒弃市面上 “月入十万” 的夸张宣传,客观剖析赛道真实盈利逻辑。

    2026年09月20日 23点15分
  • 2026日常AI全场景改造实测:从清晨唤醒到夜间复盘的24小时效率升级

    2026 年端侧 AI 智能体走向成熟,个人 AI 不再是单点对话工具,而是可以跨设备、跨应用持续运行的全天候个人助理。本文基于 2026 年第三方个人生产力实测数据,搭建一套完整 24 小时全场景 AI 改造方案,覆盖清晨唤醒、通勤信息处理、日间办公、生活事务、晚间学习复盘全链路,实测对比改造前后时间消耗、认知负荷与有效产出。

    2026年09月20日 23点10分
  • 2026 行业智能体落地指南:从办公自动化到工业巡检的端到端方案

    2026 年行业智能体已经从概念 Demo 走向规模化落地,但大量企业项目卡在原型阶段,难以嵌入真实业务流程。本文构建一套可复用的行业智能体端到端落地框架,覆盖办公自动化、工业巡检两大典型场景,对比两类场景在数据接入、智能体编排、安全管控、ROI 评估上的差异。

    2026年09月20日 23点07分
  • 2026从零搭建企业级RAG系统:从文档切分到混合检索全流程实战

    2026 年,RAG(检索增强生成)已经从 Demo 原型走向企业生产环境,大量企业踩坑的核心并非大模型本身,而是文档预处理、分块策略、检索链路的工程缺陷。本文从零拆解企业私有知识库 RAG 完整流水线,重点对比固定切分、层级分块、语义分块、父子索引四种文档切分方案的适用边界,详解 BM25 稀疏检索 + 稠密向量检索的混合检索架构、RRF 倒数排名融合与重排(Reranker)落地细节。

    2026年09月20日 23点00分
  • 2026 AI变现指南:从提示词商店到垂直Agent订阅的七种现金流

    2026年AI行业彻底告别“流量噱头式变现”,进入精细化、工具化、订阅化的商业落地新阶段。普通创作者与中小团队的AI盈利逻辑,不再依赖简单内容搬运,而是依托标准化资产、自动化工具与垂直场景服务搭建稳定现金流。本文基于2026年全球AI商用落地数据,系统拆解提示词商店、AI内容量产、RAG知识库定制、模型微调代工、AI工具插件开发、智能体外包、垂直Agent订阅七大核心变现模式,对比各模式的准入门槛、盈利上限、运维成本与生命周期。

    2026年09月18日 19点26分
  • 2026 AI生活实验室:个人健康Agent如何管理睡眠、饮食与运动数据

    2026 年个人健康管理从被动数据记录迈入个人健康 Agent 自主闭环时代。区别于传统健康 APP 仅做数据可视化,新一代健康智能体能够打通可穿戴设备、饮食记录、运动传感器的多源异构数据,自主识别生理关联,动态调整睡眠方案、膳食结构与运动负荷。本文从健康 Agent 底层架构出发,拆解睡眠、饮食、运动三大模块的数据联动逻辑,结合 2026 年 SensorFM 等可穿戴基础模型落地案例,分析端侧本地推理的隐私优势,同时剖析数据噪声、算法偏见、过度干预等现实瓶颈。

    2026年09月18日 19点20分
  • 2026多智能体协作应用:AutoGen、CrewAI与LangGraph在业务自动化中的分工与博弈 业务自动化分工与博弈解析

    2026 年,企业业务自动化从单智能体工具走向多智能体团队协同,AutoGen、CrewAI、LangGraph 成为落地最广泛的三大开源编排框架,但三者底层协作范式完全不同,在任务调度、状态管理、生产稳定性上形成差异化博弈。根据 IDC 2026 Q2 企业 Agent 落地调研,40% 企业应用将内置任务型智能体,但是 88% 的多智能体试点项目无法上线生产环境,选型错误是首要原因。CrewAI 以角色团队模式快速搭建业务原型;AutoGen 依靠对话式自主协商,擅长开放式推理与代码执行;LangGraph 基于状态图实现精细化流程管控,是生产级业务系统首选。

    2026年09月18日 19点16分
  • 2026企业级RAG 2.0实战:从混合检索、多跳推理到评测闭环的完整工程手册

    2026 年企业知识库落地已经告别初代简单向量检索 RAG,RAG 2.0 面向复杂业务问答,解决多文档关联推理、检索噪声、幻觉漂移等生产痛点。本文以工程落地视角,完整拆解混合检索架构、Agentic 多跳推理机制、全链路评测闭环三大核心模块,结合 2026 年企业项目实测数据,分析传统 RAG 在复杂查询场景下的性能短板,给出可落地的文档预处理、多路召回融合、重排序、推理路由、自动化评测与 bad case 回流的整套工程方案。

    2026年09月18日 19点08分
  • 2026 AI智能体变现指南:数字员工、自动化服务与Agent经济中的合规边界

    2026 年 AI 智能体产业正式从概念验证走向规模化商业落地,Agent 经济成型,数字员工、业务自动化服务成为主流变现载体。区别于早期大模型 API 调用、提示词售卖的浅层盈利模式,新一代可自主执行任务的智能体能够对接企业业务系统,自动完成多步骤业务流程,但智能体具备自主操作权限的特性,放大了数据安全、内容责任、越权操作等多重合规风险。

    2026年09月17日 21点38分
  • 2026 AI陪伴与情感计算实验:从可穿戴到家庭机器人,隐私、伦理与真实体验

    2026 年情感计算硬件化落地加速,AI 陪伴不再局限于线上虚拟对话,可穿戴生理采集设备、家庭移动机器人形成多模态感知闭环,通过心率、皮电、语音、微表情数据实时识别用户情绪。本文结合 2026 年国内拟人化 AI 监管落地后的实测实验数据,拆解从手环、胸贴式生理传感器到家庭人形机器人的情感计算技术链路,剖析私域空间无感采集带来的新型隐私风险,讨论算法情感模拟、人机依恋、弱势群体保护三大伦理争议。

    2026年09月17日 21点34分
  • 2026个人AI智能体应用:桌面、浏览器与端侧协同,打造你的第二大脑

    2026 年个人 AI 智能体从独立对话工具演进为跨设备协同的个人知识中枢,“第二大脑” 不再是笔记软件的附加插件,而是由桌面客户端、浏览器插件、端侧本地模型共同构成的一体化 Agent 系统。根据易观分析 2026 年二季度个人端 AI 智能体调研,仅 29% 用户还在使用纯云端对话 AI,超过 61% 的重度知识工作者开始搭建本地优先的个人智能体,实现网页抓取、本地文档检索、任务规划、记忆沉淀一体化。

    2026年09月17日 21点29分
  • 2026多模态RAG实战教程:文档图像音视频一体化,搭建企业知识智能体

    2026 年企业知识库建设已经从纯文本 RAG 升级为多模态 RAG(MM-RAG)体系,大量业务知识沉淀在 PDF 文档、图表、截图、培训音视频当中,传统文本检索无法识别图表、时序视频画面信息。本文结合 2026 年 MM-BizRAG、ViDoRe V3 等行业基准实测数据,提供一套可落地的企业级多模态 RAG 搭建全流程,覆盖文档布局解析、图像图表理解、音视频 ASR 转写 + 关键帧提取、统一向量空间混合检索、智能体多跳检索闭环。

    2026年09月17日 21点22分
  • 2026 AI变现指南:从微SaaS到按结果付费,个人与小团队的七条现金流路径

    2026年AI行业变现逻辑彻底迭代,单纯靠内容接单、提示词售卖的低阶模式彻底内卷淘汰,行业正式进入结果导向、自动化复利、垂直精细化的变现新阶段。相较于大厂重资产模型训练、全域平台布局,个人与小团队的核心优势在于轻量化、高灵活、落地快。本文基于2026年最新市场成交数据、中小创业者落地案例,梳理出适配个人与小团队的七条可落地、可复利、低门槛AI现金流路径,覆盖即时变现、中期订阅、长期收益三大层级。重点拆解微SaaS自动化交付、行业Agent结果付费、企业轻量化AI改造等创新模式,打破“AI变现只能接单”的固有认知,同时对比各路径的回本周期、投入成本、风险等级,规避同质化内卷、算力浪费、无效交付等高频踩坑点,为中小从业者提供系统化、可落地的AI商业化实战方案。

    2026年09月16日 19点24分
  • 2026 AI生活实验室:端侧AI与家庭智能体如何重构健康、教育与消费决策

    2026年AI应用正式从云端通用大模型时代,迈入端侧本地化+家庭智能体自治的落地新阶段。区别于传统云端AI的被动问答模式,端侧AI依托本地设备算力实现低延迟、高隐私数据处理,家庭智能体凭借长效记忆、多设备联动、自主决策能力,深度渗透家庭日常场景。本文结合2026年智能家居行业白皮书、AI消费赛道最新数据,聚焦健康管理、家庭教育、消费决策三大核心家庭场景,拆解端侧AI与家庭智能体的落地逻辑、技术优势与创新应用模式,剖析传统家庭生活服务的痛点革新,同时梳理当下落地瓶颈与行业趋势,为普通用户、行业从业者解读AI重构家庭生活的底层逻辑,解锁民用AI的真实实用价值。

    2026年09月16日 19点15分
  • 2026企业级AI智能体应用:从Copilot到数字员工,任务规划、记忆与权限治理

    2026年企业AI应用迎来范式级迭代,行业彻底告别辅助式Copilot工具阶段,进入自治式数字员工规模化落地周期。根据IDC 2026年行业数据,国内企业级AI智能体市场规模突破449亿元,同比增速超110%,传统对话式AI辅助工具渗透率增速放缓,具备独立任务规划、跨会话长效记忆、分级权限自治的数字员工成为企业数字化核心刚需。本文聚焦2026年智能体核心技术升级,深度拆解从Copilot被动辅助到数字员工主动履职的底层差异,系统讲解企业级智能体的自主任务规划、结构化长效记忆、全链路权限治理三大核心能力,结合企业落地痛点梳理标准化部署与治理体系,解决传统AI工具任务碎片化、记忆失效、数据越权、操作不可追溯等行业难题,为企业落地AI数字员工、搭建合规可控的智能办公体系提供实操性极强的深度方案。

    2026年09月16日 19点09分

发表回复

评论列表

点击查看更多

    联系我们

    在线咨询: QQ交谈

    微信:叁叁

    邮件:794033364@qq.com

    工作时间:周一至周五,9:30-18:30,节假日休息

    微信