
2026 年三季度,大模型产业迎来一次标志性代际跃迁。行业竞争重心,已经从早年比拼参数量、上下文窗口大小,转向真实复杂任务完成率。模型不再局限于文本生成,而是具备读取环境、调用工具、多步骤规划、自主试错、跨软件执行的 Agent 原生能力。OpenAI 推出 GPT-6 Astra,刷新了多项前沿基准测试分数,同时带来安全层面的全新挑战;国内头部大模型厂商持续迭代,在中文场景、开源权重、端云混合部署上持续突破,形成与海外旗舰差异化竞争格局。本次横评基于 2026 年 9 月统一测试集,覆盖前沿科学、代码工程、多智能体任务、中文专业文书、长文档推理五大场景,客观标定海外旗舰与国产头部模型的真实能力边界。
GPT-6 Astra 是本次代际跃迁的代表性产品。从官方披露与第三方实测数据来看,该模型上下文窗口达到 105 万 token,最大输出支持 12.8 万 token,原生集成计算机操作、多工具调用、网页浏览与代码执行能力。在前沿基准测试中,FrontierMath Tier4 得分 97.6%,ARC-AGI-3 达到 99.9%,GPQA Diamond 研究生级科学测试得分 96.0%,相比上一代 GPT-5.6 Sol 实现明显跃升。最受行业关注的一点是,GPT-6 Astra 在内部安全评估中,被认定达到关键级网络安全能力:在配套工具权限下,可以自主挖掘未知漏洞、构造利用代码,无需人类分步指导,这也是 OpenAI 首次在商用模型中标记该风险等级。
 ac1390d8eac2b42170132b82b7ed001.webp
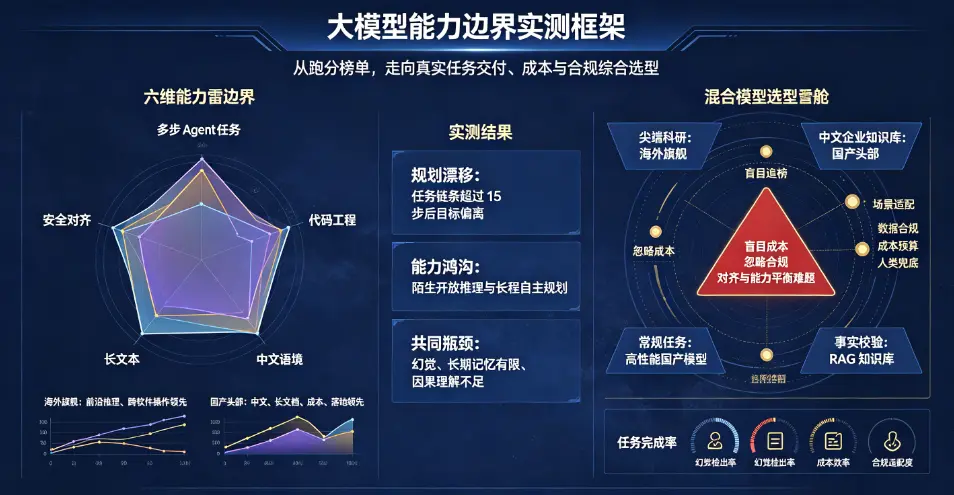
但实测同时发现,GPT-6 Astra 并非全能。模型在长程连续 Agent 任务中,依然存在 “规划漂移” 现象:当任务链条超过 15 步,会出现中间步骤遗忘、目标偏离的问题;在中文古文、国内法规、本土产业专业术语理解上,相比国产头部模型仍有差距。在 API 成本层面,GPT-6 Astra 定价为输入 10 美元 / 百万 token,输出 50 美元 / 百万 token,高昂调用成本限制大规模企业落地,更适合科研、尖端工程等小批量高价值场景,难以普惠化部署。
本次实测选取国产第一梯队四款模型:通义千问 Qwen3.7 Max、GLM-5.3、DeepSeek V4 Pro、Kimi K3。整体来看,国产模型已经在中等难度推理、代码开发、中文长文档处理上逼近海外旗舰,部分场景实现反超。在 C-Eval、SuperCLUE 中文基准测试中,国产模型对于公文撰写、古籍解析、国内行业规范理解,显著优于 GPT-6 Astra。Kimi K3、GLM-5.3 在百万字以上长文档抽取、合同审查、多文件交叉比对任务稳定性突出,适合法律、金融、政务知识库场景。DeepSeek V4 Pro 与 Qwen3.7 Max 在代码基准 SWE-Bench、Terminal-Bench 上持续优化,能够独立完成中型项目代码生成、仓库重构、多文件 bug 修复。
然而,实测也清晰暴露国产模型的能力天花板。在 ARC-AGI 这类抽象陌生推理、前沿数学猜想推导、多学科交叉科研探索场景,国产头部模型与 GPT-6 Astra 之间仍存在明显差距。当任务要求模型自主设计实验、调用多款专业科研软件、迭代验证假设时,国产模型的长程自主规划能力不足,容易出现推理断点。同时,国产模型在复杂多工具链式调用、跨软件环境自主操作的稳定性上仍有待提升,面对完全陌生环境,试错效率低于 GPT-6 Astra。这构成当前国产大模型普遍的能力边界:熟悉领域强,未知开放弱;静态知识强,自主探索弱。
本次代际跃迁,底层技术范式发生三大变化,不再依靠单纯堆算力与参数。第一,模型训练范式转向 AI 辅助训练,GPT-6 Astra 大量使用前代模型生成的高质量验证数据做监督优化,减少人工标注依赖;国内 Qwen 等团队也在探索递归式自我改进 RSI,让模型自行设计实验、迭代优化自身能力。第二,Agent 能力原生嵌入模型基座,而不是外挂插件。旧一代模型是 “大模型 + 外部工具” 拼接模式,新模型内置规划、记忆、反思子模块,能够自主判断何时调用工具、何时推理、何时回退重试。第三,评测体系从静态题库转向动态真实任务。传统固定榜单容易被模型 “刷分”,2026 年行业主流做法是采用动态、随机生成的任务集,评估模型端到端交付结果,而不是单项选择题得分。
能力边界之外,安全对齐是所有模型无法回避的约束。GPT-6 Astra 带来的警示在于:模型推理能力提升,其潜在有害能力同步增强。OpenAI 为此增加多层输出校验、权限分级、访问准入机制,仅向可信企业客户开放早期版本。国产模型在安全治理上走差异化路线,重点针对国内法规、数据属地、内容合规做对齐优化,在信息过滤、风险提示、敏感内容识别上适配本土监管要求。但实测中看到一个共性矛盾:对齐强度提升,往往会压缩模型创造性推理空间;对齐过松,则会增加模型生成有害内容的概率。无论海外还是国产模型,都尚未完美解决 “强能力” 与 “安全可控” 之间的平衡难题。
从产业落地视角看,不存在绝对最优模型,只有场景适配模型。尖端科研探索、复杂多步骤工程自动化、前沿数学研究,GPT-6 Astra 具备明显优势,但高昂成本与安全风险必须纳入评估。中文企业知识库、政务文档处理、国内业务系统集成、大规模低成本 API 调用,国产头部模型性价比更高,并且支持私有化部署、数据不出域,满足合规要求。大量企业容易陷入误区,单纯追逐榜单最高分,忽略真实业务场景、成本预算、数据合规约束。2026 年企业选型的正确思路,是搭建混合模型架构:高端复杂推理任务调用旗舰模型,常规任务交给国产高性能模型,搭配 RAG 知识库做事实校验,降低幻觉风险。
本次代际跃迁也揭示大模型当前的底层瓶颈,这是海内外模型共同的能力边界。其一,事实幻觉问题没有被彻底根除,即便是 GPT-6 Astra,在冷门专业知识、动态实时信息上依旧会编造结论,无法做到 100% 可靠;其二,模型不具备真正的长期记忆,跨会话持续积累经验能力有限;其三,模型价值判断依然依赖训练数据,无法真正理解因果,只是高效拟合数据分布。所有模型本质上依然是强大的概率生成系统,并非真正拥有自主意识。
展望后续演进方向,大模型竞争将分化为两条主线。海外旗舰会继续攻坚前沿科学、自主 Agent、复杂软件操作等高上限能力,同时持续完善安全评估体系;国内模型会持续补强长程推理、多工具协同短板,依托本土产业场景,打造垂直行业智能体,并且持续优化开源权重、端侧轻量化方案,降低使用门槛。未来 12 个月,国内外模型差距不会简单线性缩小,而是呈现 “各有所长,局部追赶” 的格局。
总而言之,2026 年 9 月的大模型代际跃迁,标志行业从 “比拼跑分” 走向 “交付价值”。GPT-6 Astra 刷新了前沿能力上限,但也展示强 AI 带来的安全风险;国产头部模型在本土场景落地取得长足进步,同时在前沿开放推理领域仍有追赶空间。所有模型都存在明确能力边界,企业与开发者必须理性看待基准测试分数,结合实测任务、成本、合规要求综合选型,不迷信单一旗舰模型。大模型不是万能解决方案,它的价值,在于把适合交给机器的重复性推理、信息检索、工具调用工作自动化,而关键决策、事实核验,仍然需要人类兜底。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。
评论列表