
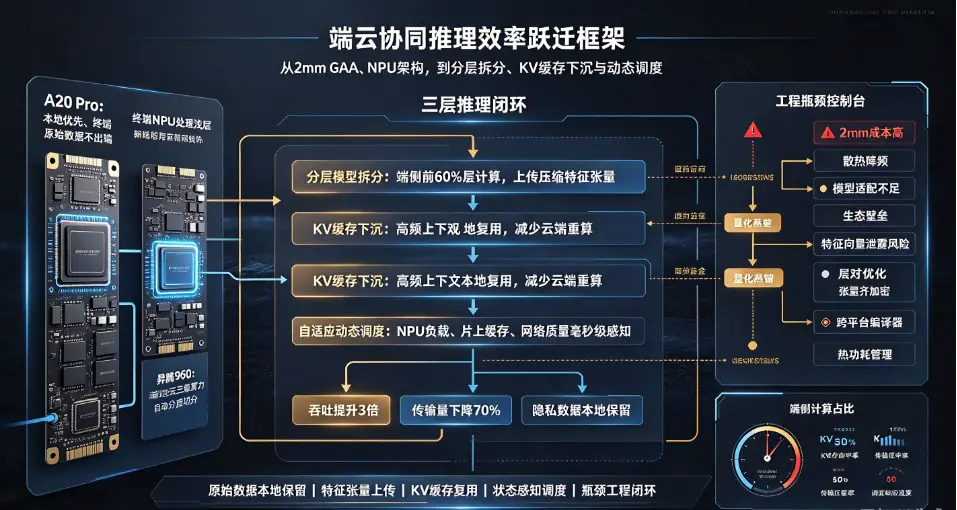
在后摩尔时代,单纯依靠云端大算力已经无法满足 AI 智能体、多模态交互对低延迟、隐私保护、离线可用的综合需求。2026 年,台积电 2nm GAA 全环绕栅极工艺大规模量产,晶体管漏电控制、功耗密度获得质的飞跃,端侧 AI 芯片不再只是简单的辅助算力单元,而是成为端云协同推理体系中核心计算节点。苹果 A20 Pro 作为消费端 2nm 旗舰 SoC,主打终端本地大模型轻量化推理;国产昇腾 960 则打通端 - 边 - 云完整算力链路,面向工业、行业智能体场景构建异构协同底座。实测数据显示,基于两颗芯片构建的端云混合推理系统,相比传统纯云端推理方案,端到端吞吐效率提升最高 3 倍,同时网络传输量下降 70% 以上。这一性能跃迁并非单纯来自制程带来的算力提升,而是芯片硬件架构、模型拆分算法、分布式缓存机制三者协同的系统性革命。
 4727e0c09345b296535c457fda7f8ab.webp
一、2nm 制程底层革新:端侧 AI 算力的物理基础
2nm 节点的核心变革,是从 FinFET 转向 GAA 纳米片晶体管架构,栅极从单侧包裹变为环绕导电沟道,晶体管漏电大幅降低。对比前代 3nm 工艺,2nm 工艺在同等性能条件下功耗降低 25%-30%,同等功耗下性能提升 10%-15%,晶体管密度提升约 20%,这对于空间、散热、供电受限的手机、PC、边缘设备至关重要。
传统端侧芯片最大瓶颈不是峰值算力,而是访存墙。大模型推理过程超过 80% 能耗消耗在数据搬运而非计算本身。2026 年 2nm 端侧芯片普遍采用片上高带宽内存、内存与计算单元近距离封装方案。苹果 A20 Pro 引入 WMCM 晶圆级多芯片模组封装,将 SoC 逻辑单元与 LPDDR 内存平铺在同一重布线层,大幅缩短内存与 NPU 之间的数据走线,降低访存延迟,同时优化散热,解决高密度 AI 计算下的降频问题。
昇腾 960 则面向端边云异构场景,采用分层内存架构,在端侧边缘节点搭载高带宽片上缓存,专门存储大模型 KV 缓存,减少重复向云端上传 token 向量。2nm 工艺带来的能效红利,让端侧设备有能力运行 30B 参数以内量化 MoE 模型,能够独立完成语义理解、图像感知、简单规划等基础任务,不再仅仅作为云端指令的输入输出终端。
二、标杆芯片架构对比:A20 Pro 消费端路线 vs 昇腾 960 端云一体化路线
苹果 A20 Pro,作为 2nm 消费级端侧 AI 芯片代表,其 NPU 架构针对本地多模态智能体做深度优化。硬件层面强化本地 KV 缓存存储单元,支持 8bit、4bit 动态量化,可在手机、平板设备本地运行轻量化多模态模型。A20 Pro 的设计思路以本地优先:优先在终端完成用户意图识别、图像预处理、短文本生成;仅当遇到超长上下文、复杂逻辑推理、高精度多模态生成任务时,才将压缩后的特征向量上传云端,而非原始文本、图像数据。这种设计天然降低带宽占用,同时保护用户原始隐私数据。
昇腾 960 的定位则完全不同,它不是单一终端 SoC,而是一套覆盖端、边缘节点、智算中心的异构算力体系。昇腾 960 内置自研灵衢高速互联接口,支持多芯片之间高速张量同步,原生支持模型分层拆分推理。在端云协同场景下,昇腾 960 边缘节点负责模型浅层特征提取、实时数据清洗、本地风控判断;云端昇腾集群承接深层复杂推理、长上下文处理、模型微调任务。昇腾生态配套的 CANN 8.0 编译器,内置端云协同自动切分工具,可自动根据端侧 NPU 算力、网络质量,动态切割大模型网络层,自动分配计算任务,降低开发者的工程开发成本。
两款芯片代表 2026 年两条主流端侧 AI 路线:A20 Pro 面向 C 端消费电子,追求单设备本地 AI 体验;昇腾 960 面向 B 端行业场景,主打多设备异构协同,二者共同推动端云协同推理走向产业化落地。
三、端云协同推理效率突破 3 倍的底层逻辑
很多人误认为端云协同只是 “本地小模型 + 云端大模型” 简单拼接,这是对技术的浅层理解。2026 年基于 2nm 芯片实现 3 倍推理效率提升,核心来自三大底层技术创新:分层模型拆分、KV 缓存下沉、自适应动态调度。
第一,分层拆分推理(Split Inference)。传统纯云端推理,用户所有输入原始数据全部上传云端,云端完整执行全部模型计算,再把结果下发,带宽开销大、网络延迟高。分层推理将大模型 Transformer 网络拆分为上下两段,端侧 NPU 执行浅层网络,提取高压缩特征向量,只把维度大幅压缩后的特征张量上传云端,云端完成深层网络计算。原始图像、文本等敏感数据保留在本地终端,传输数据量下降 70% 以上,网络等待时间显著缩短。2nm 芯片 NPU 算力与片上缓存提升,让端侧可以承担模型前 60% 层的计算任务,不再只能做简单输入预处理。
第二,KV 缓存下沉至端侧。大模型生成过程中,每一轮 token 都会产生 Key、Value 状态缓存,也就是 KV Cache。传统方案 KV 缓存全部保存在云端,每一轮对话都需要重复计算、反复占用云端显存。2026 年 2nm 端侧芯片具备更大片上 SRAM,支持将高频对话的 KV 缓存下沉存储在本地终端。当用户持续对话,重复的上下文不需要反复上传云端重算,端侧直接复用本地 KV 缓存,大幅减少云端显存占用与 token 计算开销。实测场景中,长对话类任务吞吐能力提升可达 3 倍,这也是本次效率跃升最核心的来源。
第三,基于硬件与网络状态的自适应任务调度。端云协同调度器实时采集三个维度指标:端侧 NPU 负载、剩余片上缓存、当前网络带宽与延迟。当网络良好、端侧负载低时,提升端侧计算占比;网络波动、端侧温度过高降频时,自动把任务迁移到云端。A20 Pro 与昇腾 960 都内置硬件级遥测接口,调度引擎可以毫秒级读取芯片状态,实时调整模型切分策略,避免固定拆分方案带来的性能浪费。
三者叠加,端云混合推理系统不再是端、云两套独立算力简单相加,而是一套完整协同的分布式推理系统,实现吞吐、延迟、隐私三重收益。
四、落地瓶颈:2nm 端侧 AI 芯片的现实约束
尽管 2nm 端侧芯片带来巨大性能提升,但产业落地依然存在多重瓶颈。首先是成本问题,2nm 晶圆制造成本远高于 3nm,高端 SoC 芯片价格抬高,限制在大量低成本边缘硬件普及。其次是功耗与散热矛盾,虽然 GAA 降低漏电,但高密度 NPU 持续进行大模型推理时,瞬时功耗激增,手机等小型终端散热空间有限,长时间运行依然会触发芯片降频。
其次是模型适配问题。当前绝大多数大模型是为云端 GPU/NPU 训练,针对端云分层推理的原生模型较少。模型切分位置、量化损失、端云张量对齐都会影响最终输出精度,需要专门做模型蒸馏、层对齐优化。另外,跨厂商芯片生态壁垒显著,A20 Pro 的端云协同能力高度绑定苹果生态;昇腾端云体系依赖 CANN 全栈软件栈,跨平台异构协同开发成本仍然偏高。
还有隐私与安全边界问题。端侧本地计算减少原始数据上传,但端云之间传输的特征向量、KV 缓存本身存在被捕获风险,需要配套张量加密、同态轻量化加密方案,才能满足行业数据合规要求。
五、产业趋势:端云协同成为 AI 智能体标准架构
2026 年 2nm 端侧 AI 芯片的普及,正在重塑 AI 产品的底层架构。过去 AI 应用分为两类:纯云端大模型,延迟高、依赖网络;纯本地小模型,能力弱,无法处理复杂任务。而以 A20 Pro、昇腾 960 为硬件底座的端云协同架构,融合两者优势:网络离线时,端侧 2nm 芯片独立完成基础感知、简单任务执行;联网时,端云联合完成复杂多模态推理、长链路智能体规划。
未来端云协同会继续向细粒度调度演进,不再只是简单模型层切分,而是支持 token 级别的分布式推理。端侧、边缘节点、云端智算中心形成三级算力池,AI 智能体自动把任务分配到最合适算力节点。芯片硬件、模型架构、调度算法三者深度耦合,算力不再集中在少数云端机房,而是分布式分布在亿万终端设备之中。
总结
2026 年 2nm GAA 工艺带来端侧 AI 芯片的代际跃迁,苹果 A20 Pro 与昇腾 960 分别代表消费终端与国产端边云算力两条技术路线。端云协同推理实现 3 倍效率提升,根源不只是芯片制程带来算力增长,而是分层模型拆分、KV 缓存下沉、硬件感知动态调度三大技术共同构建的分布式推理范式。
端云协同推理平衡了延迟、带宽、算力成本与数据隐私,成为 AI 智能体、多模态大模型落地的主流架构。同时也要看到,2nm 端侧芯片仍面临成本、散热、跨生态适配等工程难题。随着端侧 NPU、模型压缩、分布式推理技术持续迭代,端和云之间的算力边界将持续模糊,亿万终端设备将从单纯输入终端,转变为 AI 大系统中分布式计算节点,开启全新 AI 产业范式。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。

评论列表