
2017 年 Transformer 凭借自注意力机制,彻底改变自然语言处理领域,如今几乎所有主流大模型都基于 Transformer 衍生而来。但随着应用场景走向百万 token 超长上下文、复杂多步 Agent 推理、端侧低延迟部署,Transformer 原生缺陷日益凸显:自注意力计算复杂度随序列长度呈 O (n²) 二次增长,上下文越长算力开销越高;推理阶段 KV 缓存持续膨胀,占用大量显存;纯统计拟合模式缺少显式逻辑,面对数学、规则类任务容易产生幻觉。
2026 年,AI 架构不再是单一范式竞争,MoE 混合专家、状态空间模型、神经符号系统成为三大核心演进方向,大量混合架构(Mamba+Transformer、SSM+MoE)进入生产落地阶段。本文从底层原理、技术突破、适用场景与短板四个维度,解析三类下一代 AI 架构,并探讨架构融合的未来方向。
 b9318c9d1b7bbd5294627ea09b8a65b.webp
一、MoE 混合专家模型:稀疏激活,解耦参数量与推理算力
传统稠密 Transformer,每一个 token 前向推理都会激活全部参数,模型扩容必然带来推理成本同步上涨。MoE(Mixture of Experts,混合专家模型)的核心创新就是稀疏激活:模型由大量独立专家子网络组成,额外增加一个路由模块,根据输入 token 的语义特征,动态分配给少量专家计算,其余专家保持休眠。总参数量可以做到万亿级别,但单 token 仅激活一小部分参数,实现 “大容量、低推理开销”。
2026 年 MoE 技术迎来关键优化,传统 MoE 存在路由负载不均衡、跨 GPU 通信开销大、专家坍缩(多个专家学习趋同)三大痛点。新一代 LatentMoE 将 token 映射到低维隐空间再做路由,专家计算在压缩空间完成,同等算力下专家数量提升 4 倍,大幅降低集群通信带宽压力,代表项目如 Nemotron 3 Ultra,总参数量 550B,单 token 仅激活 55B 参数。同时 KERN 路由算法、SSMoE 无重训练专家指纹识别方案落地,缓解专家坍缩问题,路由分配更加稳定,在代码、数学、多模态任务上的专业专家分工更加清晰。
MoE 的优势:模型容量上限极高,适合大规模通用模型,不同专家专门学习代码、数学、创作、工具调用等细分能力。短板在于:训练与推理集群部署复杂,路由存在不确定性;负载失衡会造成部分专家过载,推理延迟波动大。适用场景:云端大模型、AI Agent 复杂任务,不适合资源受限的端侧设备。
二、状态空间模型(SSM/Mamba):线性复杂度,重塑长序列建模
状态空间模型(State Space Model,SSM)是 Transformer 最强有力的替代路线,Mamba 作为 SSM 代表,2026 年迭代至 Mamba2,大量混合架构采用 “Mamba 层 + 稀疏注意力层” 组合方案。
Transformer 的自注意力需要读取全部历史 token,复杂度 O (n²);而 SSM 将序列视作连续信号,用固定维度的隐状态,持续压缩、筛选历史信息,序列处理复杂度为 O (n) 线性复杂度。推理阶段不需要持续膨胀的 KV 缓存,仅保存固定大小状态向量,超长上下文场景显存占用优势巨大。Mamba 的选择性状态空间机制,可以动态筛选序列内关键信息,过滤冗余内容,兼顾长距离依赖捕捉与推理效率。
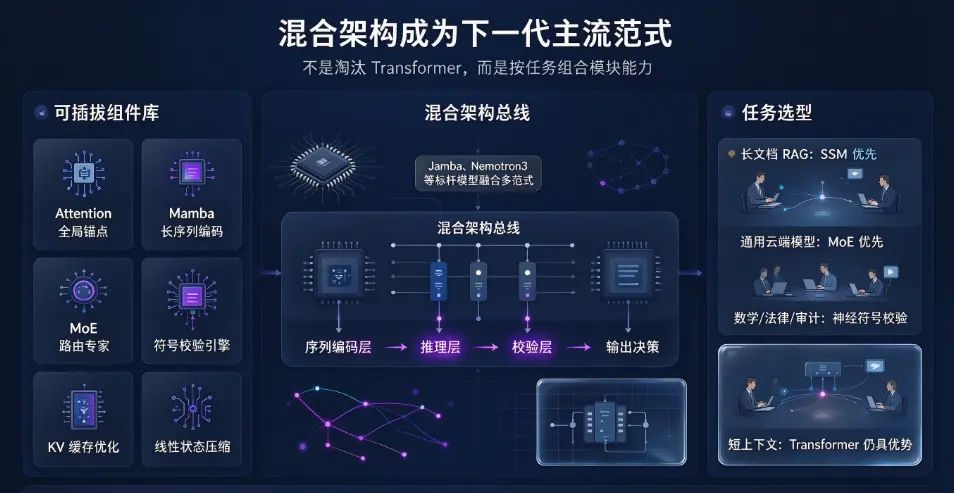
2026 年行业共识:纯 Mamba 在短文本强逻辑推理任务略弱于 Transformer;混合架构(Jamba、Nemotron3)成为主流方案。Mamba 层负责处理海量长文本、日志、文档、音频等连续序列,少量 Transformer 注意力层作为全局锚点,负责复杂逻辑推理。在百万 token 文档检索、长视频转录、时序数据分析场景,SSM 吞吐量远超传统 Transformer。
SSM 短板:全局精细推理能力弱于注意力机制,复杂数学、多步骤逻辑任务容易丢失细节;状态向量属于压缩摘要,极端情况下存在信息遗忘。适合场景:长文档解析、RAG 知识库、时序数据、端侧长上下文推理。
三、神经符号系统:神经网络 + 符号逻辑,解决幻觉与可解释性
MoE 与 SSM 依旧属于连接主义,依靠海量数据做概率拟合,天生存在幻觉、逻辑矛盾、无法严格遵循规则等缺陷。神经符号系统(Neuro-Symbolic AI)是第三条路线,将神经网络感知能力与符号逻辑引擎结合:神经网络负责自然语言理解、图像识别;符号引擎负责逻辑推导、定理证明、规则校验、因果推理。
2026 年神经符号系统不再停留在实验室原型,开始嵌入 Agent 工作流。当大模型输出数学推导、合约逻辑、规划方案时,自动将自然语言转化为一阶逻辑表达式,交由符号求解器验证,一旦发现逻辑冲突,自动回传给大模型重写,从链路层面降低幻觉。与纯大模型相比,神经符号系统具备可追溯推理链条,每一步推导都可以拆解核验,适合审计、法律、数学、工业控制等高可靠性场景。
但神经符号系统仍存在明显瓶颈:复杂自然语言向形式化逻辑转换难度高,转换过程容易引入错误;符号引擎处理开放域、模糊描述的能力弱,系统整体开发成本高,难以覆盖全部开放场景。现阶段并非完全替代大模型,更多作为 “校验层”,嵌入大模型推理链路,用于提升结果严谨性。
四、三大架构横向对比与混合范式成为行业主流
三类架构不是非此即彼的替代关系,2026 年产业落地的主流思路是混合架构。
MoE:解决模型容量问题,稀疏扩容,适合通用大模型;
SSM/Mamba:解决长序列效率问题,降低超长上下文算力与显存开销;
神经符号:解决逻辑可靠性、幻觉问题,提升推理严谨度与可解释性。
纯稠密 Transformer 在中小规模、短上下文任务仍具备优势,推理延迟稳定,工程成熟度最高,不会被快速淘汰。但面向百万级上下文、Agent 自主规划、高可信推理场景,单一 Transformer 架构已经难以满足需求。Nemotron3、Jamba 等标杆模型,同时融合 Transformer、Mamba、MoE,就是将三者优势整合:Mamba 处理长序列,MoE 提供大容量专家能力,注意力模块保障全局精细理解。
五、现存挑战与未来演进方向
下一代架构仍存在诸多待突破难题。MoE 的路由稳定性、跨卡通信开销依然是大规模部署的瓶颈;SSM 状态压缩会丢失细粒度信息;神经符号系统在开放场景的逻辑转换成本极高。除此之外,所有新架构都面临对齐、安全、评估基准不足的问题。
长期演进方向上,架构会进一步走向模块化解耦:序列编码层可以自由切换 SSM/Attention,推理层接入 MoE 专家,顶层外挂神经符号校验引擎。未来的模型不再是固定的单一网络,而是可插拔的组件系统,开发者根据任务类型自由组合模块。
六、总结
Transformer 开启大模型时代,但二次复杂度与概率拟合的局限,催生 MoE、状态空间模型、神经符号系统三大技术路线。MoE 通过稀疏激活突破模型容量边界;SSM/Mamba 以线性复杂度攻克超长上下文算力瓶颈;神经符号系统引入显式逻辑,弥补神经网络幻觉、不可解释的短板。
2026 年行业已经不再追求 “彻底淘汰 Transformer”,混合架构成为主流。不同架构各有取舍,不存在万能架构。对于开发者,架构选型核心看任务:长文档 RAG 优先 SSM;通用云端大模型优先 MoE 混合架构;数学、法律、审计等高可信度任务,需要引入神经符号校验模块。理解三类底层架构的取舍,是看懂未来 AI Agent、世界模型、端侧大模型演进的基础。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。
评论列表